删权重竟能提升LLM后训练效果?

删除部分权重在后训练中可能通过正则化与稀疏化带来意外收益。
文章围绕“在后训练阶段删除 LLM 部分权重”这一反直觉观点展开。后训练通常通过全参数微调或 LoRA 等参数高效方法更新权重,而权重删除属于剪枝范畴,其特殊性在于强调任务感知、可动态进行的删除,而非静态压缩。文章提出三条可能机制:一是正则化效应,删除迫使模型依赖关键特征、缓解小数据过拟合;二是稀疏性带来推理效率提升并减少参数间干扰;三是结合损失或梯度信息迭代删除,可能发现更优子网络。同时文章也指出局限:效果取决于删除策略、删除比例与任务特性,过度删除会导致性能崩溃,高效识别可删权重仍是开放问题,且原文缺少实验数据,有效性程度尚不明确。最后给出对从业者的三点启示。
引言:一个反直觉的发现
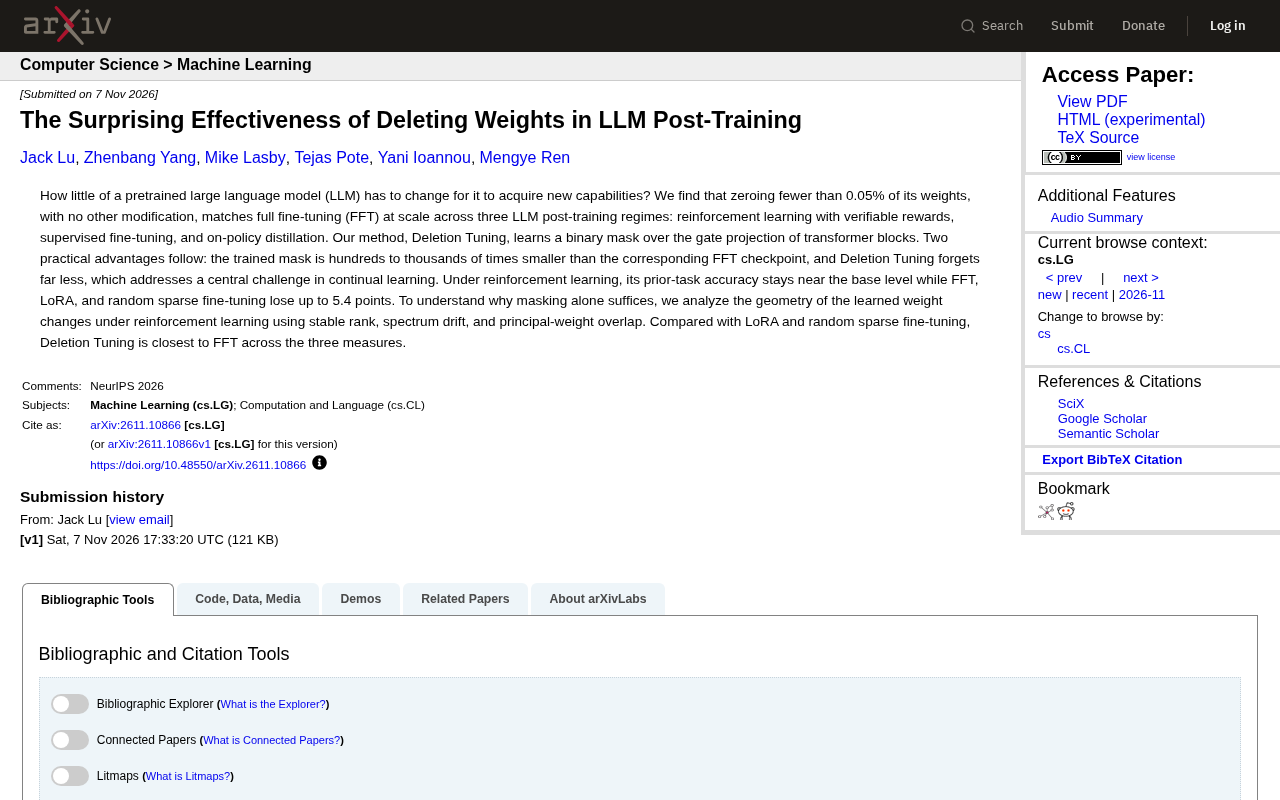
在大型语言模型(LLM)的后训练(post-training)阶段,我们通常致力于调整或增加参数以提升模型性能。然而,近期在Hacker News上引发讨论的一篇标题为《The Surprising Effectiveness of Deleting Weights in LLM Post-Training》的文章提出了一个反直觉的观点:删除部分权重可能带来意想不到的效果。尽管原文未提供详细数据,但这一思路挑战了传统认知,值得深入探讨。
后训练中的权重删除:概念与背景
后训练泛指在预训练模型基础上进行的微调、对齐等过程。传统方法如全参数微调或参数高效微调(如LoRA)均通过更新权重来适应下游任务。而权重删除则属于模型剪枝(pruning)的范畴,旨在移除冗余连接。但标题强调“后训练中”的删除,暗示这可能是一种动态的、任务感知的剪枝策略,而非简单的静态压缩。
参数高效微调(PEFT) 是一类冻结预训练模型大部分参数、仅训练少量新增或选定参数的方法,LoRA(Low-Rank Adaptation)是其中的代表:它在原始权重旁并联一对低秩矩阵,训练时只更新这对小矩阵,推理时可将二者乘积合并回原权重,从而不增加推理开销。PEFT 的意义在于显著降低显存与存储成本,并使同一基座模型可以挂载多个任务适配器。理解 PEFT 有助于定位“权重删除”的差异:PEFT 是在权重之外做加法,而剪枝是在权重之上做减法,二者都试图以远小于全参数微调的改动量完成后训练,但前者改变的是可训练参数集合,后者改变的是网络的连接结构。
为什么删除权重可能有效?
正则化效应
删除权重可视为一种强正则化,迫使模型依赖更重要的特征,减少过拟合。尤其在数据有限的后训练场景中,适度剪枝可能提升泛化能力。
幅度剪枝(magnitude pruning) 是最经典的一类剪枝准则:按权重绝对值大小排序,移除绝对值最小的连接,其直觉是绝对值小的权重对输出的贡献较弱。它实现简单、无需额外梯度信息,因而常作为基线。与之相对的梯度剪枝则依据损失对权重的敏感度(如梯度幅值或二阶信息)判断重要性,理论上更贴近任务,但计算与存储开销更高。实践中常采用迭代式剪枝:每次移除一小部分权重后继续训练若干步再评估,避免一次性大幅删除造成不可恢复的损伤。需要区分的是非结构化剪枝(逐个权重删除,产生不规则稀疏,需专用硬件才能兑现加速)与结构化剪枝(成块删除通道或注意力头,可直接加速通用硬件)。
稀疏性带来的效率
稀疏模型在推理时可能更高效,同时减少参数间的干扰,使关键路径更清晰。一些研究表明,稀疏网络在特定任务上可达到与稠密网络相当甚至更好的性能。
动态调整的潜力
后训练中删除权重可能是动态的:根据任务损失或梯度信息迭代移除不重要的连接,从而精炼模型。这种“边训练边剪枝”的方式或许能发现更优的子网络。
彩票假说(Lottery Ticket Hypothesis) 为“后训练中删除权重”提供了重要的理论参照:它指出稠密网络中可能存在一个稀疏子网络,若以其原始初始化值重新训练,就能达到与完整网络相当的性能。这一假说把剪枝从单纯的压缩手段提升为“寻找可训练子结构”的问题,也解释了为何剪枝后继续训练往往比直接剪枝后推理表现更好。不过彩票假说依赖精确的初始化与重训练,在 LLM 后训练场景中成本较高,因此更现实的做法是任务感知的迭代剪枝。另需注意,稀疏模型的实际加速高度依赖底层算子与硬件支持,稀疏度不高时,不规则稀疏甚至可能因索引开销而变慢。
潜在挑战与未解之谜
尽管思路吸引人,但实际效果取决于删除策略(如幅度剪枝、梯度剪枝)、删除比例以及任务特性。过度删除可能导致性能崩溃。此外,如何高效识别可删除权重仍是一个开放问题。原文未提供实验细节,因此其“有效性”的具体程度尚不明确。
对AI从业者的启示
- 重新审视剪枝的价值:剪枝不仅是压缩工具,也可能成为后训练的正则化手段。
- 探索任务感知的稀疏化:针对下游任务动态删除权重,可能比静态剪枝更有效。
- 关注稀疏模型的训练动态:理解删除对优化景观的影响,有助于设计更好的后训练流程。
结语
权重删除在后训练中的有效性虽需更多实证,但它为模型优化提供了新视角。在追求更大模型的同时,如何“做减法”或许同样重要。
注:本文基于Hacker News讨论及标题信息,原文未提供具体实验数据,观点仅供参考。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。