深度学习MLOps工具调研:生产环境模型维护的真实痛点

一位开发者在Reddit发起调研,验证生产环境模型维护痛点的普遍性,并考虑将自建MLOps工具开源。
Reddit上一位开发者发帖邀请深度学习从业者填写简短问卷,目的有二:验证"生产环境模型维护困难"是否是业界普遍问题,以及了解社区当前使用的工具栈,以便为其自建MLOps工具的开源计划做前期集成规划。文章以此为切入点,分析了MLOps领域长期存在"重复造轮子"的现象——从训练、版本管理到部署监控,每个环节都可能因团队差异需要定制化,加之MLflow、Kubeflow、W&B等工具各自割据不同阶段,新工具若无法顺畅集成既有生态便难以落地。这则帖子本身也提供了一个方法论样本:开源前用极低成本的社区调研先验证需求,远比埋头开发后无人问津更高效。
一则来自开发者社区的调研邀请
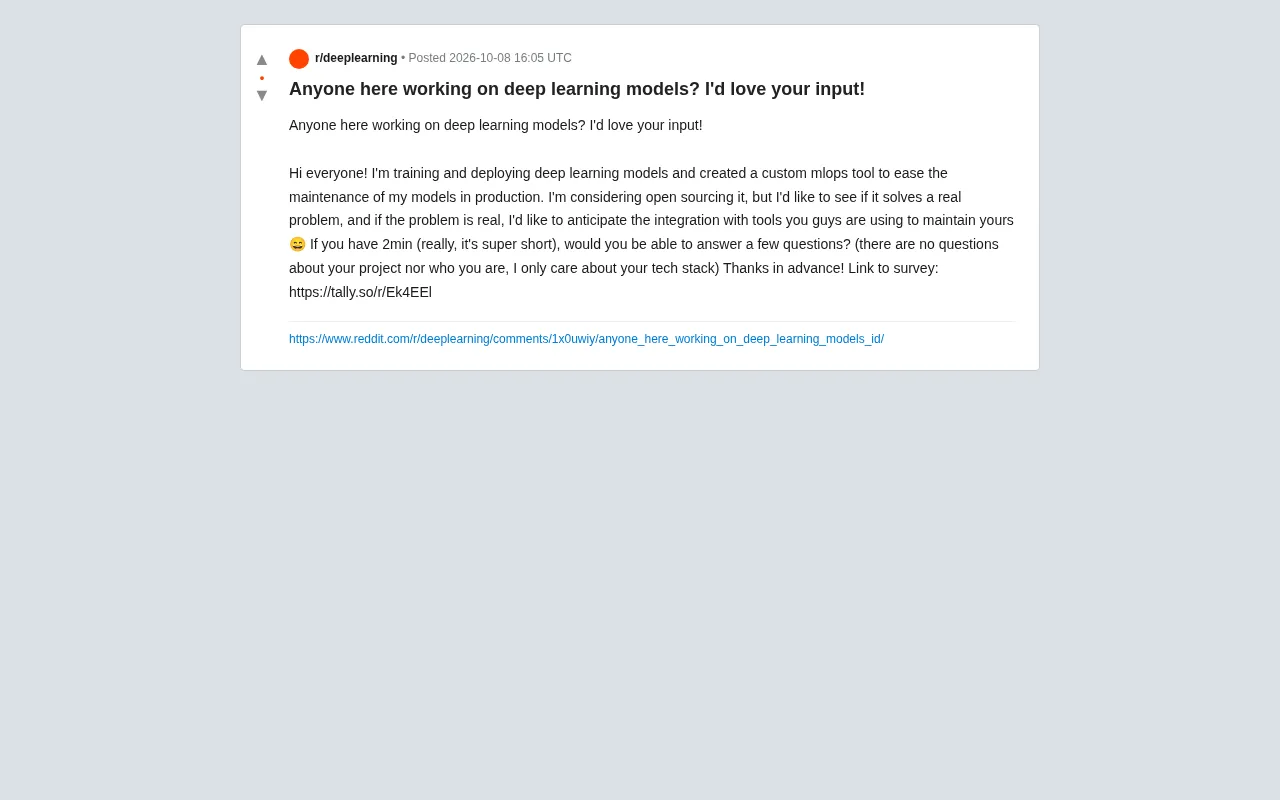
在Reddit的深度学习相关版块,一位开发者发布了一则简短的调研帖,希望了解社区中正在训练和部署深度学习模型的从业者所使用的技术栈。这位开发者表示,自己为了简化生产环境中模型的维护工作,开发了一款自定义的MLOps工具,目前正在考虑将其开源。
帖子内容相当克制,发帖人明确表示问卷不会涉及任何关于受访者个人身份或项目隐私的问题,只关心大家实际使用的技术栈。这种聚焦于验证真实需求、而非急于推广产品的做法,在当下充斥着营销噪音的开发者社区中显得颇为务实。
MLOps工具为何总在"重复造轮子"
这则帖子背后折射出一个在机器学习工程领域长期存在的现象:几乎每个认真做模型部署的团队,最终都会被迫自己搭建一套运维工具链。原因并不复杂——从模型训练、版本管理、部署上线到线上监控,每个环节都可能因为团队的技术栈差异而需要定制化处理。
发帖人提到的核心诉求有两点,值得单独拆解:
验证问题是否真实存在
开发者首先想确认的是,"生产环境模型维护困难"这个问题是否具有普遍性,还是仅仅是他个人项目中的特例。这是一个典型的产品早期验证思路——在投入更多精力开源和维护之前,先用极低成本的问卷来检验市场需求。对于任何打算做开源工具的人来说,这种先验证、后投入的节奏都值得借鉴。
预判与现有工具的集成需求
第二个诉求是提前了解社区成员正在使用哪些工具,以便在工具设计阶段就考虑好集成方案。这一点尤为关键。MLOps领域目前已经有大量成熟或半成熟的工具,如MLflow、Kubeflow、Weights & Biases、BentoML等,新工具若无法与这些既有生态顺畅对接,往往难以获得采用。发帖人意识到了这个"集成优先"的现实,说明其具备一定的工程经验。
MLflow是由Databricks主导的开源平台,主要提供实验追踪、模型注册与多框架打包能力,是目前使用最广泛的MLOps基础组件之一。Kubeflow则将机器学习工作流原生运行在Kubernetes之上,适合需要大规模分布式训练和流水线编排的团队,但上手门槛较高。Weights & Biases(W&B)以可视化实验追踪见长,在研究社区和快速迭代的产品团队中颇受欢迎。BentoML则专注于模型服务化打包与部署,能将训练好的模型封装为标准化的REST API容器镜像。这些工具各自覆盖MLOps生命周期的不同阶段,彼此之间存在功能重叠但又难以完全替代,这正是大多数团队最终形成"工具拼接"局面的根本原因——新工具若不能以最小摩擦嵌入这张已有的拼图,几乎注定被弃用。
MLOps(Machine Learning Operations)是将DevOps理念延伸至机器学习系统的工程实践,核心目标是将模型从实验室可靠地推向生产并持续运营。与传统软件不同,ML系统的"制品"不只是代码,还包括数据、特征处理逻辑和模型权重,三者任意一项发生漂移都可能导致线上效果悄然劣化。这种多维度的可变性,使得复用通用CI/CD工具链往往力不从心——版本控制需要同时追踪代码与数据,部署需要考虑GPU资源调度,监控需要关注统计指标而非仅仅是服务可用性。正因如此,即便市场上已有数十款MLOps平台,"自建"依然是许多中小团队的常态选择,因为通用工具难以完美匹配每个团队独特的模型类型、推理延迟要求和基础设施约束。
开源前的需求验证值得学习
从这则帖子可以提炼出一个对独立开发者和小团队都有价值的方法论:在开源一个工具之前,花两分钟做一次轻量级的社区调研,远比埋头开发半年后才发现无人使用要高效得多。
发帖人选择了Tally这类轻量问卷工具来降低受访门槛,并反复强调"真的只需要两分钟",这种对受访者时间成本的尊重,本身也是提高问卷回收率的实用技巧。帖子中没有夸大工具的能力,也没有附带任何商业链接或推广话术,整体保持了社区友好的姿态。
需要说明的是,由于原帖信息量有限,我们无法得知这款MLOps工具的具体功能、技术实现或与竞品的差异。帖子本质上是一次早期的用户访谈邀请,而非产品发布。
对MLOps从业者的启示
对于正在生产环境中维护深度学习模型的工程师而言,这类调研帖其实提供了一个反思自身工作流的契机:你当前的模型维护痛点是什么?是版本回滚困难、监控指标缺失,还是部署流程繁琐?这些问题的答案,恰恰是衡量一款新MLOps工具是否值得关注的标准。
如果你恰好在这个领域工作,参与这类社区调研不仅能帮助开发者打磨产品,也可能促成一个真正解决你痛点的开源工具诞生。开源生态的繁荣,很大程度上正是依赖于这种开发者与使用者之间的早期对话。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。