审计LLM裁判:文本转SQL流水线中的评估失效与修复

生产级LLM裁判一致性可低至随机水平,审计与替换可大幅提升可靠性且成本骤降。
一项针对实际部署的text-to-SQL流水线的审计研究发现,gpt-4o-mini裁判与人类黄金标准的一致性仅为kappa=0.04,且77.1%的正确案例被误标。研究者将大多数误判归因于一种命名为GRADE-HALLUCINATION的系统性失效机制。替换实验表明,自托管的Qwen3.6-27B(kappa=0.72)可媲美Claude Opus 4.7,但成本仅为后者的1/300。集成策略方面,弱强裁判配对反而拉低整体性能,三个强裁判的一致投票路由才能达到kappa=0.79。更值得警惕的是,同样的审计方法在BIRD-financial基准上标出了25.5%的专家黄金SQL存在质量问题,动摇了对权威基准的信任基础。
LLM-as-Judge的隐患:从未被验证的裁判
在生产级文本转SQL(text-to-SQL)流水线中,一个越来越普遍的做法是:让大语言模型充当"裁判"(LLM-as-judge),对生成的SQL结果进行忠实性判断。问题在于,这些裁判与人类标注者之间的一致性,往往从未被真正测量过。
一项发表于arXiv的研究(论文《Auditing and Repairing LLM-as-Judge Failures in a Production Text-to-SQL Pipeline》)直面了这一盲点。研究者对自己实际部署的 gpt-4o-mini 裁判进行了审计,结果令人警醒:在一个"分歧富集"(disagreement-enriched)数据集上,该裁判与两位作者共同确认的黄金标准之间,Cohen's kappa 一致性系数仅为 0.04——几乎等同于随机猜测。即便在均匀随机抽查中,kappa 也只有 0.42。
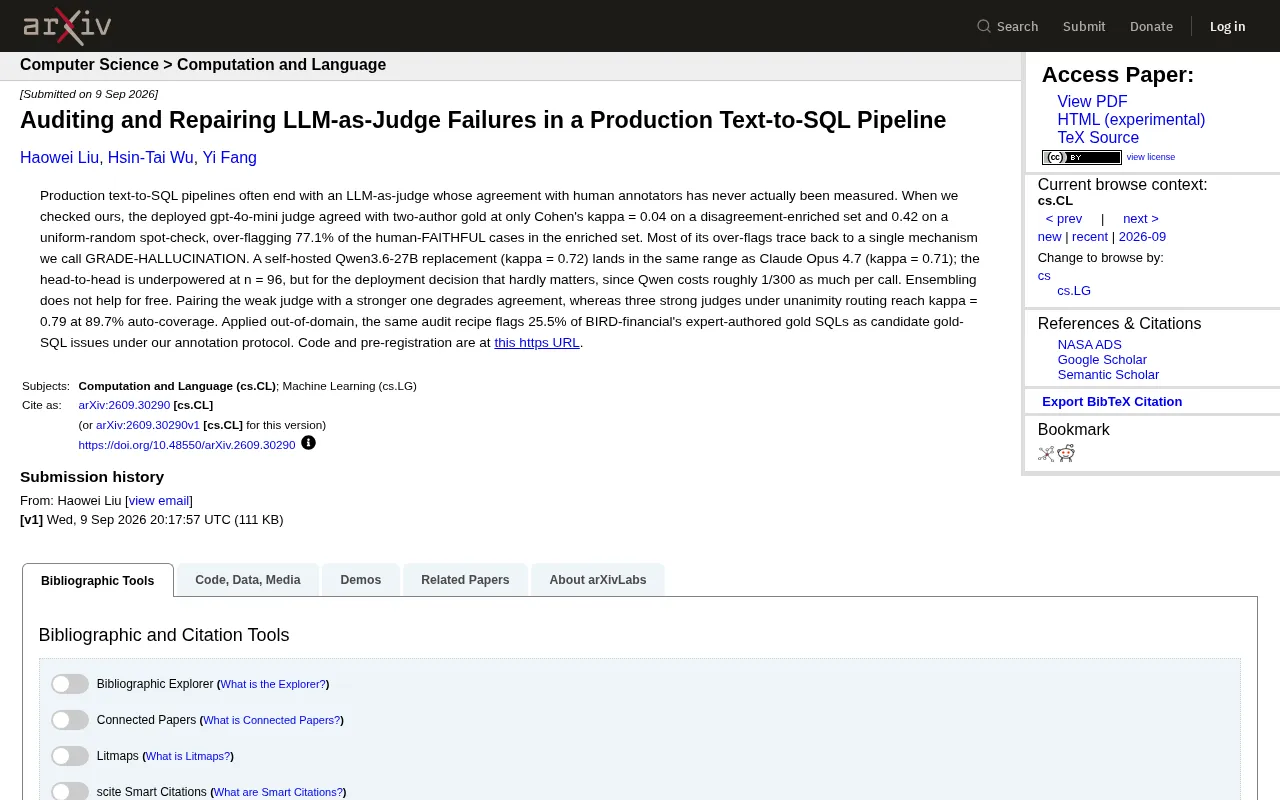
更严重的是,这个裁判在富集集上对本应被判为"忠实"(FAITHFUL)的人类案例,误标(over-flag)比例高达 77.1%。换句话说,它在大量情况下把正确的结果错误地打了红旗,可靠性堪忧。
Cohen's kappa 是衡量两个评估者之间一致性的统计指标,取值范围为 -1 到 1。其核心优势在于它会扣除纯粹由随机猜测带来的偶然一致性:kappa = 0 意味着两者的一致程度与随机一致无异,kappa = 1 代表完全一致,而 0.6–0.8 通常被视为"较强一致"的门槛。在评估任务中,直接计算"准确率"会虚高(因为即使随机猜测也有一定命中概率),kappa 因此成为衡量标注/裁判可靠性更严格的基准。该研究将 gpt-4o-mini 裁判的 kappa = 0.04 与随机猜测的 kappa = 0 并列对比,正是在强调:这个裁判实质上没有提供任何超越随机水平的判断能力。
GRADE-HALLUCINATION:误判的核心机制
研究者追溯了这些误判的根源,发现绝大多数过度标记都指向同一个机制,他们将其命名为 GRADE-HALLUCINATION(评分幻觉)。
这一发现颇具启发性:裁判模型的错误并非零散随机的噪声,而是存在系统性的、可归因的单一失效模式。这意味着评估失效是可以被诊断、定位并针对性修复的,而不是只能靠盲目更换模型来碰运气。对于任何依赖LLM进行自动评估的团队而言,识别出这类结构化的失效机制,是提升评估管线可信度的关键前提。
GRADE-HALLUCINATION 指的是裁判模型在对SQL查询结果进行忠实性打分时,产生的一种特定幻觉模式:裁判并非基于实际的查询语义或结果正确性作出判断,而是对某些表面特征(如数值格式、列名命名风格、结果排列顺序等)产生错误的敏感性,从而将实际正确的输出误判为不忠实。这一命名将裁判的失效与标准的LLM生成幻觉区分开来——问题不出在SQL生成阶段,而出在评估阶段本身。识别出这是一种结构化的单一失效模式(而非随机噪声),意味着可以通过针对性的提示词工程、裁判微调或结果后处理来系统性地消除它,而不必盲目替换整个评估框架。
换裁判:小模型也能媲美旗舰
针对失效的裁判,研究团队测试了替代方案。一个自托管的 Qwen3.6-27B 模型作为替换裁判,达到了 kappa = 0.72 的一致性水平,与 Claude Opus 4.7(kappa = 0.71)处于同一区间。
研究者坦诚指出,在 n=96 的样本量下,这场头对头比较统计功效不足(underpowered)。但从实际部署决策的角度看,这一点几乎无关紧要——因为 Qwen 每次调用的成本大约只有 Claude Opus 的 1/300。当两者性能相当而成本相差两个数量级时,选择自然一目了然。
这为业界提供了一个务实的信号:在评估任务上,自托管的中等规模开源模型可能提供极具性价比的选择,未必需要付费调用最昂贵的旗舰API。
集成不是免费的午餐
一个直觉上诱人的方案是"集成"(ensembling)多个裁判以提升可靠性。研究结果对此提出了警示:集成并非天然有益。
将一个弱裁判与一个强裁判配对,实际上会降低整体一致性——弱模型拖累了强模型。相比之下,让三个强裁判在"一致投票路由"(unanimity routing)下协作,才能达到 kappa = 0.79,同时保持 89.7% 的自动覆盖率。
这提醒工程团队:集成策略的收益取决于成员质量与路由机制的设计,简单堆叠模型不仅无法提升效果,反而可能引入负面干扰。
跨领域审计:连专家黄金标准也不可靠
研究最引人深思的发现之一,是将同样的审计方法应用到域外(out-of-domain)数据集上的结果。当把该审计流程用于 BIRD-financial 这一广泛使用的基准时,它标记出 25.5% 由专家撰写的黄金标准SQL存在候选质量问题。
这一数字直指整个text-to-SQL评估生态的深层隐患:即便是被视为"金标准"的专家标注数据,也可能包含相当比例的问题样本。如果基准本身不干净,那么建立在其上的模型排名与性能宣称都需要重新审视。
研究团队将代码与预注册(pre-registration)方案开源发布于 GitHub(github.com/JamesL404/synca-audit),使得这套审计配方(audit recipe)可复现、可迁移到其他生产管线中。
BIRD-financial 是 BIRD(Big Bench for Large-Scale Database Grounded Text-to-SQL Evaluation)基准的金融子集,由人工专家编写SQL答案,被学术界和工业界广泛用于评估text-to-SQL模型性能。由于其数据由领域专家标注,长期以来被默认为高质量的"黄金标准"参照。该研究将审计工具应用于这一被普遍信任的数据集后,发现约四分之一的条目存在可疑的候选质量问题,这对依赖 BIRD 排行榜得分作为模型选型依据的团队具有直接影响——排名靠前的模型,可能部分是因为它"学会了"适应基准中的噪声样本,而非真正掌握了更准确的SQL生成能力。
对实践者的启示
这项工作的价值不仅在于揭示了单个部署的问题,更在于提供了一套可操作的方法论:
- 先测量,再信任:任何LLM裁判在投入生产前,都应用带人类黄金标准的数据测量其一致性,而非默认它可靠。
- 诊断失效机制:像 GRADE-HALLUCINATION 这样的系统性错误一旦被定位,就能针对性修复。
- 成本与性能并重:自托管开源模型可能以极低成本达到旗舰级表现。
- 谨慎对待基准数据:连专家黄金标准都可能存在四分之一的问题率,评估结论应保持审慎。
对于所有正在依赖LLM进行自动评估的团队来说,这项研究是一记及时的提醒:评估器本身也需要被评估。
相关推荐
FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。
前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。