神经网络优化器命名太随意?社区吐槽搜索难

神经网络优化器命名花哨且与日常词汇重名,导致搜索效率低下,需社区共识改善。
文章从 Reddit 用户对 SOAP、Shampoo、FOAM 等优化器名称的吐槽出发,指出这些与日用品或物理术语同名的算法给研究者带来搜索困扰。命名趋势源于论文吸引眼球和快速传播的需要,但已演变为命名竞赛,降低了信息检索效率。作者建议通过限定关键词、在 arXiv 和 Google Scholar 等学术平台检索、以及借助社区分享来应对,并呼吁学术社区形成命名软性约束,在论文中给出全称与领域标签,以建立更友好的知识检索生态。
当优化器名字变成搜索噩梦
Reddit 上一位用户的吐槽引发了共鸣:为什么神经网络优化器的名字都这么奇怪?SOAP、Shampoo、FOAM——这些听起来像日用品或物理术语的词汇,却是深度学习领域重要的优化算法名称。该用户无奈地表示,每次搜索这些优化器时,都会因为名字不唯一而返回大量完全不相关的结果。
这个问题并非个例。随着深度学习研究的爆发式增长,每年涌现出大量新优化器,命名逐渐从描述性转向趣味性,甚至有些随意。这给研究者、工程师和学生带来了实实在在的困扰。
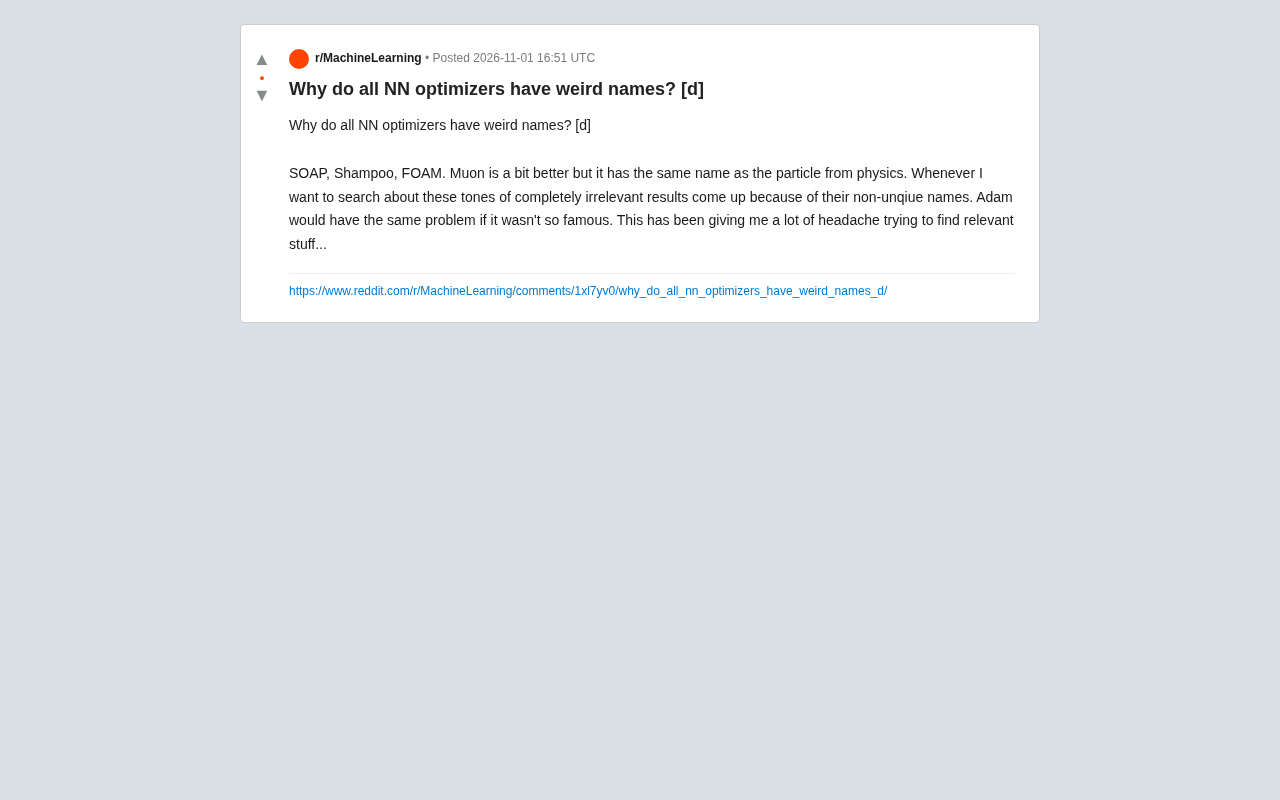
那些让人困惑的优化器名称
用户提到的 SOAP、Shampoo、FOAM 只是冰山一角。Shampoo 是一种基于矩阵预条件的优化器,FOAM 则与自适应学习率相关,而 SOAP 是近期提出的二阶优化方法。这些名字本身与算法原理毫无关联,纯粹是作者为了好记或有趣而选定的缩写。
Muon 的情况稍好一些,至少它听起来像是一个正常的算法名,但问题在于它和物理学中的 μ 子(muon)同名。该用户指出,搜索 Muon 优化器时,物理学的相关内容会大量混入结果。Adam 作为最著名的优化器之一,如果没有足够高的知名度,同样会面临搜索结果被同名人物或事物淹没的问题。
这种命名方式带来的直接后果是:信息检索效率大幅降低。研究者需要花费额外时间筛选结果,甚至可能错过关键文献。
矩阵预条件(Matrix Preconditioning)是一类优化技术的统称,其核心思想是在梯度更新前对梯度进行线性变换(通常用某个矩阵乘或求逆),以改善问题的条件数,使优化在参数空间中各方向上的收敛速度更加均衡。在深度学习中,Adam 通过逐元素的自适应缩放近似实现了对角预条件;而 Shampoo 则对每层权重矩阵分别维护行、列方向的协方差矩阵并做 Kronecker 因子分解,从而构造出更接近完整二阶信息的预条件子,代价是额外的存储与计算开销。理解预条件的概念有助于把握 Shampoo、SOAP 等二阶或准二阶方法为何与一阶方法(如 SGD、Adam)在命名和设计哲学上存在差异。
二阶优化方法指的是利用损失函数的二阶导数信息(Hessian 矩阵或其近似)来指导参数更新的算法。经典牛顿法即为其代表,它通过 Hessian 的逆来调整梯度方向,从而在接近最优点时获得更快的收敛速率。然而在深度神经网络中,参数数量可达数亿甚至更多,完整 Hessian 的存储与求逆不可行,因此实际使用的多为拟牛顿法或基于 Kronecker 分解、对角近似、低秩近似等技巧的变体。SOAP 等方法正是在这一背景下,试图以可承受的计算成本捕捉部分二阶曲率信息,以改善训练稳定性和收敛效率。
命名混乱背后的深层原因
为什么研究者偏爱这类名字?一方面,学术论文需要吸引眼球,一个有趣的名字更容易被记住和引用。另一方面,优化器领域的创新速度极快,许多作者希望用简短好记的缩写来代表复杂的数学过程。然而,这种趋势逐渐演变为一种命名竞赛,名字越来越花哨,实用性却越来越低。
从社区讨论来看,这已经不是一个简单的玩笑,而是影响了实际工作效率的问题。有用户建议,新优化器命名时应考虑搜索唯一性,比如加入领域前缀或使用更具描述性的名称。但在当前学术评价体系下,这种呼吁很难迅速改变现状。
arXiv 是物理学、数学、计算机科学等领域最重要的预印本平台,研究者通常在正式同行评审之前就将论文上传至此,以快速确立优先权并获取反馈。深度学习领域的大量新优化器首先以 arXiv 预印本形式出现,这意味着命名发生在正式发表之前,且缺乏统一登记机制。Google Scholar 则是跨出版商的学术搜索引擎,覆盖期刊、会议论文、预印本和专利等。由于通用搜索引擎对同名词的消歧能力有限,直接在 arXiv 或 Google Scholar 内检索、并结合作者名或年份等元数据,往往比在网页搜索中过滤结果更高效。
如何应对搜索难题
对于日常需要查阅优化器资料的研究者和工程师,可以采取一些策略来减少困扰。使用更精确的搜索关键词组合,比如在优化器名称后加上“optimizer”“deep learning”等限定词,或者直接在 arXiv、Google Scholar 等学术平台内搜索。关注顶级会议和期刊的论文列表,也能避免被无关结果干扰。
社区的力量同样重要。像 Reddit 的 r/MachineLearning 版块,经常有用户分享优化器对比和总结,这些人工筛选的内容质量往往高于通用搜索引擎的结果。该帖子的讨论本身就是一个例子:通过社区反馈,人们可以更快地识别哪些名字容易混淆,并共享有效的搜索技巧。
命名规范需要社区共识
优化器命名混乱的问题,本质上是学术社区缺乏命名共识的体现。虽然难以强制规范,但可以通过社区讨论形成软性约束。例如,在论文中首次提出优化器时,同时给出全称和明确的领域标签,有助于后续检索。会议和期刊的审稿人也可以建议作者选择更具区分度的名称。
从更广的视角看,这个问题折射出深度学习领域高速发展中的一些副作用:新概念层出不穷,但配套的知識管理方式没有跟上。优化器命名只是其中一个缩影,类似的困扰也可能出现在模型架构、数据集名称等方面。解决这些问题需要社区共同努力,建立更友好的知识检索生态。
背景补充
从技术谱系上看,文中提到的这些优化器并非彼此孤立。Shampoo 属于全矩阵预条件方法,其后续工作包括对计算效率的改进以及向更实用方向的简化;SOAP 可以看作在 Shampoo 预条件框架基础上结合了类似 Adagrad 的自适应思想,试图在二阶信息利用与训练稳定性之间取得平衡。Muon 则走的是另一条路线,它对动量更新后的矩阵做正交化处理(如通过 Newton-Schulz 迭代近似极分解),使更新方向在奇异值意义上更加均衡,常被用于大规模语言模型训练。将这些方法放在预条件、自适应学习率、正交化等几条技术脉络中理解,比单纯记忆名称更有助于把握它们各自解决的问题与适用场景。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。