神经网络原本就是「干净」的?Goodfire可解释性长文解读

Goodfire研究员提出工作假设:神经网络内部可能本来就是干净的,多义性是误读。
Goodfire 研究员 Nick Camerata 提出一个反向工作假设:神经网络内部可能本来就是「干净」的,而非一团纠缠的结。他重新审视著名的「猫车神经元」4E55,发现它实为 V 形神经元,猫和汽车只是形状的误读;并提出「递归泛化」——泛化呈分形结构,而非叠加导致的任意打包。对 Qwen3-32B 的初步审计显示约 90% 神经元极点只有一个主要职责,仅 2-4% 尚未理解,与早期 0/14 的可解释性评分形成鲜明对比。他还警告稀疏自编码器可能把干净神经元拆出并不存在的多义性。作者自评该假设约 85% 把握,认为规模化普通调查可能胜过精巧分解。
可解释性研究长期被一个假设笼罩:神经网络内部是「一团乱麻」,神经元把无关概念纠缠在一起,必须先拆解才能理解。Goodfire 研究员 Nick Camerata 在一篇新 essay 中提出一个反向的工作假设——神经网络可能本来就是干净的。如果成立,我们也许能直接阅读网络,而不是先做复杂分解。
从「猫车神经元」说起:多义性证据被误读?
早期可解释性研究从神经元入手,找到不少干净的边缘检测器、曲线检测器。但一个著名反例是:某个神经元似乎同时对猫脸和汽车前部强烈激活,这类现象被称为多义性(polysemanticity)。主流解释是叠加(superposition)——神经元不够用时,网络把罕见共现的无关概念折叠在一起,因此神经元内容是任意的「结」。
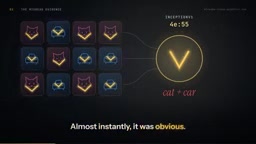
Camerata 重新审视了 Inception V1 中的 4E55 神经元。他花几秒问「它可能只代表哪一件事」,答案几乎立刻浮现:它不是猫车神经元,而是V 形神经元。最强激活对应 V 形火焰、V 形狐狸脸、火球喷出的 V 形水柱;负极点则对应圆形 O。猫和汽车从来不是重点,形状才是。
叠加(Superposition) 是 Anthropic 等机构在 2022 年前后系统化的一个假说:当网络需要的特征数量超过可用神经元维度时,网络会把多个稀疏共现的特征压缩到同一组神经元上,用近似正交的编码方式共存。这类似于用少于信号数量的麦克风做压缩感知——只要信号足够稀疏,仍可恢复。叠加假说预测神经元激活是多个特征的线性混合,因此单个神经元往往「说不清」代表什么。它也是稀疏自编码器(SAE)等分解方法的理论出发点:如果叠加真实存在,就需要先把混合解开。Camerata 的论证本质上是在质疑这一前提——多义性可能只是观察工具或采样偏差造成的假象,而非网络真实的组织原则。
递归泛化:泛化是分形的
另一个被引用的「电路」证据是狗神经元中隐藏汽车特征。但 Camerata 指出,没有下游读取那个组合;汽车和狗被放在一起,是因为它们共享姿态——Inception V1 中有上百个这类姿态神经元。特征可视化工具本身也会误导:它沿最易下降路径走,常常落到猫、狐狸或狗上,造成显微镜误差。
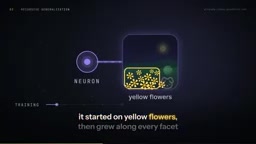
他训练网络时观察一个神经元形成:起初只对黄色花朵响应,随后扩展到照片的每个侧面——其他风景、绿色物体如球,甚至没有花的狗。语言模型中也类似:一个对字母 IY(如 Miyazaki)敏感的神经元,会扩展到 DIY,再扩展到完全不含 IY 的短语 do-it-yourself。Camerata 称这种现象为递归泛化:泛化不是局部的,而是分形般层层展开。
两种故事给出相反预测:泛化把相似事物归组,保持局部;叠加把无关事物打包,可能落在任何地方。于是可以实验检验。把 Inception 5-1 的 480 个神经元压缩到 10 个:如果叠加为真,应出现曲线+螺旋+蛛网的重叠混合;实际却是神经元保持干净,只是变得更粗——一个「曲线与环」神经元替代了原来的 10 个曲线检测器。空间越少,概念越粗;空间越多,概念越细。
Inception V1 是 Google 于 2014 年提出的经典卷积网络,因在 ImageNet 上取得突破且结构相对紧凑,长期是可解释性研究的「果蝇」模型。它的卷积层(如 conv5-1,即文中 Inception 5-1 的 480 个通道)被 Olah 等人用特征可视化系统研究过,许多早期关于神经元多义性的证据正来自这里。Camerata 选择它作为再分析对象,好处是既有公开的神经元可视化库可对照,又能与八年前的结论直接比较。理解这一点很重要:文中「视觉模型八年前的位置」正是指 Inception 时代的研究范式,而语言模型可能正处在同一阶段,只是规模更大、工具更弱。
语言模型:从 0/14 到 90% 单职
语言模型更大也更奇怪,这个结论还成立吗?2023 年 Anthropic 对小模型的研究给出中位数神经元 0/14 的可解释性评分;OpenAI 自动可解释性项目发现约 1.7% 神经元可解释。但用更好的工具和现代模型重做,画面完全不同。对 Qwen3-32B 的初步审计显示,约 90% 的神经元极点只有一个主要职责,约 7% 有两个相关职责,仅 2-4% 尚未理解;类似结果在万亿参数级模型上也能复现。
语言神经元的行为也出人意料。一个看似多义的「逗号神经元」,最高激活是一堆无关逗号;细看它追踪的是 Colorado——逗号出现在模型生成该词的上下文中。这个神经元维持对已生成上下文的滚动摘要;调高它,模型会规划一次徒步。另一个神经元对 base64 网址中的字母 PR 和孟加拉文激活;解码网址、转写孟加拉文后,都是 PR——不是混合,而是同一事物的伪装。
可解释性有像填字游戏一样的动量:初期一个神经元只能靠其他读不懂的神经元解释,但随着地图填满,每个答案约束下一个。当只能看到网络 2% 时,你无法判断工具哪里坏了;当看到大部分时,未解释的残余会直接指向工具问题。
稀疏自编码器(SAE) 是一类无监督分解工具:它训练一个带稀疏惩罚的瓶颈网络,把模型激活重构为大量稀疏特征的线性组合,试图把叠加的神经元拆成「单义」特征。Anthropic 2023 年用 SAE 从语言模型中提取出可解释特征,被视为可解释性的里程碑。但 Camerata 指出其风险:如果原网络本就干净,SAE 会强行把单一概念拆成多个成分,制造出并不存在的多义性——就像把 V 形神经元拆成汽车和猫。SAE 的有效性依赖于叠加假设,因此它既是工具也是该假设的检验对象,不能用来循环论证叠加存在。
从神经元到电路:诊断、取钱与「干净」的定义
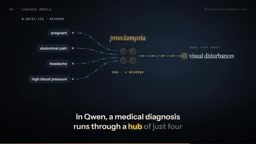
这种清晰度能扩展到电路层面。在 Qwen 中,一次医学诊断只经过一个四神经元枢纽;移除它们,模型转而询问瘙痒。在万亿参数的 Kimi K3 中,一个「捡到钱包」的提示点亮失物招领与诚实相关神经元,输出「归还」。
所谓「干净」并不是每个神经元都匹配我们已有的标签,而是每个部件都是为被后续部件读取和构建而设计的。就像在小镇里金融区几乎不成为一个问题,在纽约地图上一分钟就能找到。把一个从来不是结的网络拆开,反而可能让它看起来像结——好比用东京的 70 块碎片重建布鲁克林。稀疏自编码器对 V 神经元正是如此:把它拆成汽车特征和猫特征,制造了原本不存在的多义性。
Camerata 对比两种可解释性风格:一种是构建大特征列表再审计;另一种是从问题出发,像地图一样放大缩小。两者的错误并不对称:假设网络是干净的而判断错,你得到一张错地图,乱神经元是线索;假设网络是打包的而判断错,乱神经元就是终点,因为你停止寻找。
这或许也是可解释性的「苦涩教训」:规模化普通调查,胜过设计精巧的分解。作者谨慎表示,这只是一个约 85% 把握的工作假设,并非所有内容都已审计。但前沿模型可能正处在视觉模型八年前的位置:可读,只差许多小修正。若成立,可解释性将远比我们以为的更可处理——不是一团结,而是一座城市,或一片雨林,网络已经完成了几乎全部自我准备的工作。
完整 essay 与交互式显微镜可在 alreadyclean.goodfire.com 查看。
自动可解释性(Automated Interpretability) 指用另一个语言模型为神经元或特征生成自然语言解释,再以模拟激活预测的准确率打分,OpenAI 2023 年的工作即属此类。文中「约 1.7% 神经元可解释」和「中位数 0/14」都是这类评分的产物。这类方法的局限在于:解释由模型生成,评分依赖解释与激活的相关性而非因果干预,且早期模型容量小、工具粗糙,容易低估可解释性。Camerata 强调「更好的工具和现代模型」重做后结果逆转,提示早期低分可能主要是测量误差,而非网络本质混乱。
相关推荐
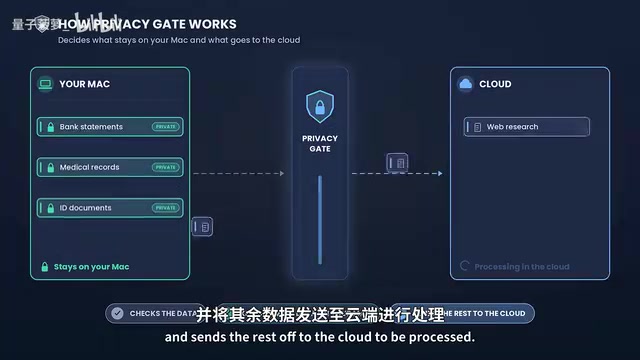
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。