省 Token 又不降质:Effort 与模型选型的性价比配置法

通过动态匹配「模型等级×Effort」组合,在保证质量的前提下大幅降低大模型使用成本。
本文聚焦于大模型调用中常被忽视的 Effort(推理努力程度)参数,说明它如何通过控制内部隐藏的思考 Token 数量来影响成本与速度。核心观点是:最优策略并非一味选用旗舰模型或拉满 Effort,而是根据任务难度动态组合这两个维度。对简单到中等难度的任务,「轻量模型 + Max Effort」往往能以更低成本逼近「旗舰模型 + Medium Effort」的效果;但面对复杂逻辑推理、长文本处理等吃能力的场景,旗舰模型仍不可替代,因为 Effort 只是放大器,无法突破模型本身的能力上限。文章最终给出了面向不同场景的实战配置建议,帮助用户把每一分 Token 预算花在刀刃上。
为什么 AI 也有「努力程度」
多数人用大模型时只关心选哪个版本,却忽略了另一个直接决定成本的旋钮——Effort(推理努力程度)。它控制 AI 面对一个问题时愿意花多少「心思」去深思熟虑。Effort 调得越高,模型就会产生越多看不见的思考 Token(reasoning token),这些 Token 不会出现在最终回答里,却实打实地计入用量和成本,同时拖慢回应速度。
换个角度理解:模型就像人一样,有自己的能量与努力程度。你让它全力以赴地处理每一个琐碎问题,不仅没必要,还在白白烧钱。真正懂得省 Token 的人,不是一味把 Effort 拉满,而是把「模型等级」和「努力程度」两个维度搭配起来调。
从技术层面看,这里的「思考 Token」对应的是 OpenAI o 系列、Anthropic Claude 3.7 等推理模型(Reasoning Model)所特有的链式思维(Chain-of-Thought)内部推理过程。与普通语言模型直接生成答案不同,推理模型会先在内部产生一段自我对话式的分析步骤,再将结论提炼为最终回复。这段中间过程对用户不可见,但会消耗大量 Token 配额——以 OpenAI o3 为例,单次复杂请求的内部推理 Token 数量可能数倍于最终输出。Effort(有时在 API 文档中称为 reasoning_effort)正是控制模型为此分配多少「思考预算」的参数,通常分为 Low / Medium / High(或 Min / Medium / Max)三档,分别对应不同的推理深度与 Token 消耗上限。
Effort 越高越好?答案是不一定
直觉上会以为「越努力工作结果越好」,但实际并非如此。调高 Effort 带来的额外思考过程,对于简单任务几乎没有收益,反而把成本和延迟一起推高。
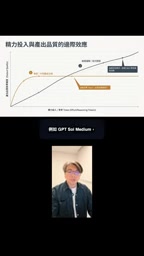
一个更聪明的策略是跨维度组合:用轻量模型 + 最大 Effort,往往能逼近旗舰模型 + 中等 Effort的体感表现。这里举的例子是把轻量级模型(如 Nano 系列)开到 Max,其品质表现可以接近旗舰模型(如 Sonnet 系列)的 Medium 档位,而成本却低得多。
这背后的逻辑是:对于简单到中等难度的问题,瓶颈不在模型本身的能力上限,而在于它愿意投入多少推理。给小模型多一点思考预算,就能把它的潜力压榨出来,性价比反而最优。
这种「跨维度组合」的思路,在机器学习领域有一个相关的理论依据——计算最优缩放(Compute-Optimal Scaling)。传统观点认为提升模型能力要靠增大参数量,但近年来的研究(如 DeepMind 的 Chinchilla 论文及后续的「推理时计算缩放」研究)表明:在推理阶段动态增加计算量,同样可以显著提升小模型的输出质量。换言之,模型的「能力」并非固定不变,而是由训练时的参数规模与推理时投入的计算量共同决定。这就是为什么给轻量模型配以更高 Effort,能在特定任务上「追平」更大模型的表现:它把运行时计算(Runtime Compute)当作了能力补偿的手段。
复杂任务:旗舰模型仍不可替代
但轻量模型 + Max 并非万能解。遇到真正吃能力的场景,差距就显现出来了:
- 复杂逻辑推理
- 模棱两可、需要判断的问题
- 长文本处理与程式开发
- 对准确性要求极高的任务
这些情况下,旗舰级模型配中等 Effort(如 Sonnet Medium)更有优势,也更稳定。再怎么给小模型加思考预算,也补不上模型本身的能力缺口。换句话说,Effort 是放大器,模型等级才是天花板——放大器拉不动天花板之上的东西。
实战配置建议
结合上面的原则,可以把日常使用拆成几种典型场景:
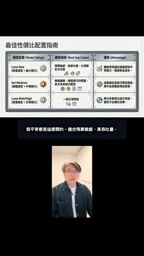
轻量模型 + Max:预算敏感的大规模任务
这是最常用的省钱配置,适合预算敏感、高吞吐量、能容忍品质轻微波动的场景。尤其是大规模批次任务,用这套配置基本上非常省,总成本能压到很低。品质可能会有些小波动,但对批量处理来说完全可以接受。
旗舰模型 + Medium:可靠性优先
当任务成果的稳定度和可靠性至关重要时,切到旗舰模型的 Medium 档位。它牺牲一点成本,换来结果的稳定与可预测,适合不容出错的关键任务。
日常问答:轻量模型 Medium 或 High
一般的日常问答,用轻量模型的 Medium 或 High 就足够了,大多数情况下根本不必开到 Max——那只是浪费 Token 和时间。
小结:把钱花在刀刃上
Token 成本的优化,核心不是找一个「最便宜的模型」,而是针对任务难度动态匹配「模型等级 × Effort」这个组合:
- 简单到中等任务,让小模型全力思考,性价比最高;
- 复杂关键任务,交给旗舰模型适度推理,稳定可靠;
- 日常使用别盲目拉满 Effort,中档就够用。
理解模型「有能量、有努力程度」这件事,是用好大模型、同时控制成本的关键一步。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。
Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。
Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。