实测Claude Code省token:90%节省是幻觉,真正有效的方法

实测12次后发现:Claude Code省token的真实空间远小于宣传,最有效的是三个免费习惯而非任何插件。
本文作者对多款宣称能为Claude Code节省大量token的工具进行了系统实测,核心结论是:可节省的空间远比"省90%"的宣传要小,因为存在一个由系统提示、重读机制、思考计费和缓存失效构成的消耗"地板",任何工具都无法消除。RTK摘要终端输出的思路本身合理,但实测账单几乎无变化;真正有效的工具——Anthropic官方插件(约省13%)和Ponytail(约省10%)——都靠减少执行步骤来生效。Graphify在理解和讲解大型陌生项目上价值突出,但实测无法确认其能降低token消耗。反而是三个零成本习惯效果最显著:用/clear为每个任务单开对话、用/rewind回退错误而非反复纠缠、在对话开头一次性选定模型和思考量。文章最后建议:装任何工具前,先用/usage测量,并对同一任务跑多次,因为单次测量方差极大,无法说明问题。
市面上大量工具宣称能帮你在Claude Code里省下高达90%的token消耗,很多人(包括本文作者)都曾被这类承诺吸引并推荐过。但当把同一个任务放在真实应用上重复测了12次之后,结论却出人意料:可节省的空间远比宣传的要小。本文梳理这次实测的核心发现,拆解token到底花在哪、哪些工具真的管用、以及三个不装任何插件就能立刻上手的习惯。
token为什么烧得这么快
要理解节省空间在哪,先得明白Claude Code的工作方式。你花的钱按token计算,而关键在于——Claude不会记住对话。每次你发一条请求,它都要从头把整段对话重新读一遍,就像一个同事在回答你每条消息之前,都要把整个聊天记录重看一遍。
更重要的是,一次请求往往不是单一动作。你让它在应用里加一个按钮,Claude要找位置、打开文件、修改、验证是否生效——每一步都是一个step,而每一步都会再次重读整段对话。一个简单请求可能包含15到20步。这种反复重读才是消耗大头,远超Claude自己写出来的内容。
由此推出一个硬道理:想让同一个任务花更少的token,只有两条路——要么让它重读的内容更短,要么让它完成所需的步骤更少。任何真正有效的工具,本质上都在做这两件事之一。
这种机制在技术上称为「上下文窗口重放」(context window replay)。Claude Code基于大语言模型的自回归推理架构,模型本身是无状态的——它没有持久记忆,每次推理必须将完整的上下文序列作为输入。Claude Code在工程层面通过「提示缓存」(prompt caching)做了优化:将近期的对话内容存入高速缓存,使重复读取的成本低于全量计算,但这只影响单价,不减少需要处理的token总量。每一个agentic step(自主执行步骤)本质上是一次独立的API调用,前序所有step的输入与输出都会被拼接进新一轮的上下文,这意味着step数量与累计token消耗之间是超线性关系:步骤越多,后期每一步的输入token基数越大,加速度越快。
无法消除的“地板”
在讨论工具之前,有一部分开销是你装什么都省不掉的。
第一,Claude Code启动时自带一个“背包”:它自己的系统指令和工具定义,在你还没输入任何内容前就占掉2万多token,而且每条消息都会携带。你唯一能减负的,是自己添加的部分——比如超长的指令文件或连接器。如果你的指令文件写了好几页,那几页会跟着每条消息一起跑。
第二,就是那个重读机制,它是工作方式本身,关不掉,只能缩短。第三,Claude回答前会“思考”,思考也计费。你可以在简单任务(改文本、重命名文件)上让它少想,在真正需要时让它多想,但不能让它完全不想。第四,Claude把对话存在一个更便宜的快速缓存里,但只保留一小时,去吃个饭回来再接着聊,它得把整段重新处理一遍。
所以第一个结论是:节省的余地比看上去小,存在一个谁都拿不走的地板。当一个工具承诺省90%时,值得反问一句——90%是相对什么而言?
“省90%”的真相:在咖啡上省钱,房租才是大头
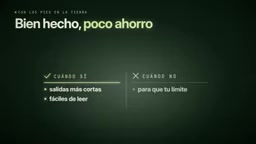
有一个很受欢迎的工具RTK,会把终端输出做摘要,让Claude少读点。思路不错,因为终端确实是消耗大户之一,它的计数器也会显示“已节省数百万token”。
但编辑器厂商JetBrains用数百个任务做了测量,账单却是另一回事:当Claude思考较少时,账单略有上升;思考较多时,基本持平。原因在于它只摘要了重读内容里很小的一部分。用作者的比喻——这就像在咖啡上省钱,而账单里真正压秤的是房租。它做的事本身做得不错,终端确实更短更干净,但在小漏洞上省,整个“水箱”里感觉不到。
真正降了消耗的两个工具
有两款工具确实压低了开销,而它们的共同点都是——让Claude少走几步。
Anthropic官方插件:教Claude直接按名字定位代码的某个部分,像编辑器那样,而不是挨个打开文件去碰运气。软件公司Marmelab对比多款工具后测得约13%的降幅,可直接在Claude Code内按编程语言安装对应插件。适用场景:项目文件已经不少、Claude老在找东西上耗时间;不适用:项目只有4个文件,或你主要用它处理文档而非代码。
Ponytail:让Claude优先做最简单的方案,不要在小需求上搭个大工程。JetBrains测得约10%降幅,且结果质量不变。适用场景:原型、内部工具、应用的第一个版本——简单正是你要的;不适用:你在构建需要扛高并发、需要Claude考虑所有边界情况的系统,哪怕贵一点也值。
10%、13%确实不错,但不是90%。而且它们生效的机制,都是减少步骤。
Graphify:好用,但别为省钱而装
作者曾亲自推荐过Graphify,这次也把它放上了测试台。它能读完整个项目并画出一张地图——一个超过800个文件的开源CRM,5秒内就能转成一张有3000个相互连接的节点、按应用区域分组的图谱。点开任意节点,能看到它和哪些部分相连、在哪个文件里。用来理解一个陌生项目、快速定位某个东西在哪,它非常出色。
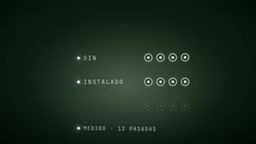
但它出名是因为另一个承诺:大幅省token。于是作者做了实测——在CRM里给联系人加一个“来源”字段(LinkedIn、官网还是推荐)。不装Graphify跑4次、装了跑4次、再明确要求Claude使用它跑4次。
结果很有意思:不装时平均花150万token;装了(但没主动调用)花120万,可那4次里Claude压根没用它,直接去读文件,所以这点节省根本不是Graphify的功劳;而当明确要求它使用时,Claude每个任务查了好几次,花费约135万,差不多。
更关键的是,同一个任务什么都不装,一次花110万,另一次超过200万,接近翻倍,做的事一模一样。这很正常,因为Claude不总走同一条路:有时一下就找到文件,有时多绕几圈、多做一次上次没做的检查。所以作者坦言:以他的测试,无法说Graphify能帮你少花钱,其他做过测量的人也得出相同结论。
这不代表它没用,而是用在别处:客户丢来一个你没碰过的应用,开地图一分钟看清核心区域和连接;动“销售看板”这类敏感部分前,先问它哪些文件会受影响,避免悄悄弄坏;或者向同事、客户讲解项目时,用地图代替一堆文件夹。适用于大型项目、不是你自己写的项目、需要理解和讲解架构的场合;不适用于Claude两步就能走完的小项目,或仅仅为了省钱而装。另外,代码改动大时记得重新生成地图,别用过期的。
真正有效的,是三个免费习惯
讽刺的是,最管用的做法恰恰最简单,而且不用装任何东西。
一个任务,一段对话。 做完一件事、开始另一件时,敲 /clear 从零开始,不花钱。这样Claude就不会在每条消息里都拖着之前的全部内容。比如做完联系人表单要去动发票模块,它根本不需要重读表单那一堆。怕丢掉进度,就先让它把“已做”和“待办”写进一个文件。
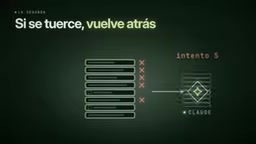
出错时别硬刚,用 /rewind 回退。 如果事情跑偏了,不要在同一段对话里反复纠缠。回到出错之前那个点,省掉重读所有失败尝试的开销。很常见的情况是:让它做,没成;让它改,还不行;第五次尝试时,对话里塞满了失败记录,每条消息都要重读一遍。不如退回去换个说法。
开头就选好模型和思考量,别中途切换。 每次在对话中途换模型,Claude都得重新处理整段对话。日常用Sonnet就很好,Opus留给难活。要设计整个数据库结构,就用Opus开场;要改文字和颜色,就用Sonnet开场。关键是一开始决定好,别来回跳。
装任何东西之前,先测量:用 /usage 看消耗花在哪,同一任务在前后各跑两次——因为正如实测所示,只跑一次说明不了任何问题。
/clear 和 /rewind 都是Claude Code的内置斜杠命令(slash commands),不依赖任何插件。/clear 会完全重置当前对话上下文,等同于开启一个全新会话,之后的第一条消息只携带系统提示和你的新输入,历史内容归零。/rewind 则类似版本控制里的「检出历史提交」:它会将上下文回滚到你指定的某个历史消息节点,抹去该节点之后产生的所有输入与输出——包括那些失败的尝试和Claude走错的岔路。两个命令的本质都是「缩短Claude下一次需要重读的内容长度」,直接作用于token消耗的最大来源,这也是为什么在所有优化手段中它们的性价比最高。
写在最后
被炒作带偏太容易了:看到一个几千颗星的工具、一个承诺省90%的视频,就装上。作者自己也踩过坑。工具确实能帮忙,但余地比看上去小,因为有个谁都拿不走的地板。真正省钱的,是让Claude少重读、少走步骤——而这往往靠更好的习惯,而非一个新插件就能实现。
背景补充
Anthropic官方将这套预填充内容称为「系统提示」(system prompt),其中包含Claude Code的角色定义、安全规则、可调用工具的JSON schema描述(如读写文件、执行终端命令、搜索代码等),以及各类内置约束。工具定义本身体积可观——每个工具的名称、描述、参数类型、枚举值都需要用结构化文本描述清楚,十余个工具叠加后轻松超过数千token。「提示缓存」虽然能降低这部分的重复计算费率(Anthropic目前对缓存命中收取约10%的正常读取价格),但缓存有效期仅约5分钟到1小时不等,超时后需重新写入并按全价计费一次。这也解释了为何中断会话后重新接入,第一条消息的成本会明显高于后续消息。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。