短剧Agent实测:AI一键出片真的可行吗?

短剧Agent爆火:AI正在重塑短视频创作
最近,一批甜妹与猫咪主题的短视频在B站悄然走红——有创作者仅凭26条作品就涨粉43万。这类萌系风格视频看似简单,背后却藏着一套完整的AI短剧生产流水线,而支撑这一切的,正是短剧创作圈热议的「短剧Agent」功能。
值得注意的是,这一现象出现的时机绝非偶然。2023-2024年间,国内短剧市场规模突破500亿元,首次超过同期院线电影总票房,催生了大量对低成本、高产能内容生产工具的迫切需求。传统短剧制作的人力成本——编剧、导演、演员、后期团队——构成了极高的准入门槛。AI短剧工具正是瞄准了这一结构性机会:B站、抖音等平台的算法分发机制对「完播率、互动率」高度敏感,而萌系短视频天然具备「低决策成本、高情绪价值」的完播率优势,AI工具降低内容生产边际成本后,创作者得以高频测试不同内容方向,以数据驱动迭代——这种创作范式本身就是AI工具与平台算法生态协同演化的产物。
所谓短剧Agent,本质上是面向短剧创作者的AI一站式生产线。它并非单一AI模型,而是多个专业化AI模型协同工作的编排系统——其底层架构借鉴了软件工程中的「流水线模式」(Pipeline Pattern),将剧本生成(通常由大语言模型如GPT-4/Claude承担)、图像生成(Stable Diffusion、FLUX等扩散模型)、视频生成(如Kling、Wan、Sora等)拆分为独立节点,通过工作流引擎串联调度。
这里值得对视频生成模型的技术谱系稍作梳理:Sora采用基于Transformer的DiT(Diffusion Transformer)架构,将视频视为时空patch序列统一建模;快手Kling采用3D因果注意力机制处理时序帧关系;阿里开源的Wan 2.1则以参数效率和生成质量的平衡著称,在开源社区中被广泛集成。三类模型的共同演进方向是提升跨帧时序一致性与物理运动的合理性,这也直接关系到后文将讨论的「画面连贯性」核心痛点。
Multi-Agent系统(多智能体系统)起源于分布式人工智能领域,其核心思想是将复杂任务分解为若干可并行或串行处理的子任务,由各自专精的智能体协作完成。这一理念并不新鲜——早在1980年代的学术文献中便有雏形——但2023年以来,随着LangChain、AutoGPT、MetaGPT等Agent编排框架的迅速成熟与开源普及,「多个AI模型协作完成复杂任务」从实验室概念正式走向大规模商业落地。短剧Agent正是这一产业趋势在垂直内容领域的具体体现:AIGC(AI Generated Content)产业链正经历从分散的「单点工具」向整合的「全链路平台」的结构性演进。
在短剧Agent的语境下,这一架构的优越性体现在:单一超大模型难以同时精通文本推理、图像合成与时序视频生成这三种截然不同的模态任务,而专业化拆分后,每个节点均可采用当前该领域的最优模型,并随技术迭代无缝替换。工作流引擎在此扮演着「总调度」的关键角色,而这一角色本身也存在技术分层:ComfyUI以节点图可视化方式编排扩散模型推理管线,面向图像/视频生成的底层调度;Dify是面向LLM应用的低代码平台,侧重业务逻辑编排;LangGraph则基于有向图建模Agent状态转换,适合需要条件分支与循环的复杂推理任务。三类工具在完整的短剧Agent系统中各司其职,协同管理节点间的数据依赖、错误重试与并发控制,确保跨模态信息(如角色描述从文本→图像→视频)在传递过程中语义保真。
这种Multi-Agent协作架构的核心价值在于:每个节点可独立迭代升级,且输出结果可作为下一节点的条件输入,实现语义信息的跨模态传递。因此,它不再是单点的「文生图」或「图生视频」工具,而是将剧本创作、角色设计、场景生成、分镜脚本到最终成片这整条链路串联起来,致力于成为创作者的「专属AI剧组」。
从产品定位来看,此类工具(如视频中演示的小云雀短剧2.0)已从单纯的AI Agent进化为完整的创作平台。对于缺乏专业团队、预算有限的个人创作者而言,这种「降本增效」的生产方式确实极具吸引力。
三步出片:萌系视频的制作流程
以走红的甜妹加猫咪视频为例,整个制作流程可以拆解为三步,上手门槛并不高。
第一步:生成视频提示词
创作者可以直接参考热门视频改编,或借助大语言模型生成「同款」提示词模板。提示词的质量直接决定后续画面效果,是整个流程的基础。提示词工程(Prompt Engineering)已逐渐形成一套系统性方法论:针对视频生成场景,有效的提示词通常需要同时涵盖主体描述(角色外貌、服饰、情绪)、环境描述(场景、光线、氛围)、镜头语言(景别、运动方式)以及画质关键词(如「8K」「电影感」「浅景深」)四个维度。借鉴现有热门视频的提示词结构,再结合大语言模型进行「同款改写」,是当前创作者社区中广泛流传的高效入门路径。
值得一提的是,提示词在不同模态的生成模型之间并非通用——文生图模型(如FLUX)更偏好静态场景的细节描述,而视频生成模型(如Kling)则对动作动词、镜头运动指令更为敏感。理解这一差异,是提示词工程从「入门」进阶到「精通」的关键分水岭。在实践中,许多创作者采用「LLM辅助扩写」的策略:先用自然语言描述创意意图,再让大语言模型将其转化为符合目标模型输入规范的结构化提示词,在跨模态语义转换中充当「翻译中间件」。
第二步:生成角色三视图
进入短剧Agent的自由画布功能,添加图片节点并输入角色形象提示词。AI会先生成甜妹的正面形象,再基于此扩展出三视图,用于保持后续画面中角色的一致性。猫咪形象同理,参考网红猫生成后补齐所需场景图即可。
「角色三视图」并非仅为美观,其核心功能是为AI提供多角度参考图,通过IP-Adapter、ControlNet或角色LoRA等技术手段锁定角色的外貌特征。扩散模型(Diffusion Model)是当前图像与视频生成领域的主流技术范式,其工作原理分为「正向加噪」与「反向去噪」两个阶段:训练时对真实图像逐步叠加高斯噪声直至完全随机化,推理时模型从纯噪声出发,学习逐步预测并去除噪声以还原图像。潜空间(Latent Space)是指VAE(变分自编码器)将高分辨率图像压缩后的低维抽象表示空间,扩散过程在此紧凑空间中进行可大幅降低计算量。
扩散模型在生成图像时,本质上是在高维潜空间中进行去噪采样,若缺乏多角度约束,同一角色在不同帧中的脸型、服饰、发色极易产生语义漂移。IP-Adapter通过将参考图像的视觉特征注入交叉注意力层,ControlNet则通过添加额外的结构化条件(如骨骼图、边缘图)来约束生成结果,两者共同构成了当前角色一致性控制的主要技术手段。值得一提的是,2024年出现的InstantID、PhotoMaker等新一代零样本身份保持技术,已可在无需额外微调的前提下,仅凭单张参考图实现跨风格的高保真角色迁移,进一步降低了角色一致性控制的使用门槛。三视图通过提供正面、侧面、背面的特征锚点,显著提升角色在跨帧、跨场景生成中的一致性——这正是解决「画面不连贯」痛点的主要技术路径,也是当前视频生成领域研究的核心难题之一。
第三步:生成视频
添加视频节点,将角色三视图与场景图一并连接,输入视频提示词,AI便会自动生成成片。整条链路的核心逻辑是:通过「角色资产 + 场景资产 + 提示词」的组合,维持多个片段之间的画面连贯性。
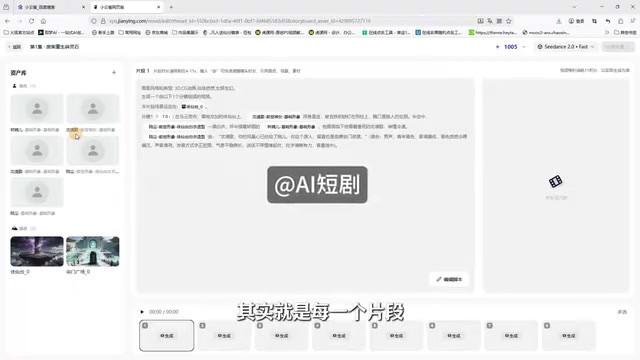
这种模块化设计值得关注:它将传统影视制作中「选角、布景、拍摄」的概念抽象成可复用的数字资产,让创作者得以专注于内容创意本身。
短剧Agent实测:从剧本到成片的完整链路
除了萌系短视频,短剧Agent更大的野心在于生成完整的剧情短剧。UP主实测了一个「东方玄幻仙侠复仇爽剧」案例,完整走了一遍流程。
智能化的剧本与资产规划
用户可以直接上传剧本,也可以只给出一段构想,让AI生成剧本大纲。确认大纲后,选择画面风格与比例,AI便输出完整剧本内容。进入角色与场景设计环节时,系统会自动规划每个场景对应哪一集、每个人物在哪一集出场。
例如剧中女主拥有「前世神女」「归位神女」「觉醒神女」等多个形态,AI都能提前规划到位,甚至连角色的音色描述也一并生成。这种系统级的资产管理能力,是普通拼接式工具难以企及的。从信息架构的视角看,这本质上是一种「角色状态机」的AI实现:系统将同一角色的不同形态视为独立但关联的视觉资产,通过元数据标记它们的出场时序与叙事条件,再在分镜生成阶段按需调用对应的视觉锚点——这与游戏引擎中角色「换装系统」的底层逻辑颇为相似,只是实现介质从像素图层变为了可生成式的AI提示词组合。
这一资产管理逻辑在工程层面的实现同样值得关注:系统通常维护一个结构化的「角色-场景知识图谱」,将角色形态、出场时序、情绪状态、服饰特征等作为节点属性存储,分镜生成时通过图查询检索对应节点的视觉锚点提示词,再注入视频生成管线。这种「知识图谱 + 生成模型」的混合架构,正是当前大型AIGC平台区别于简单提示词拼接工具的核心技术壁垒所在。
分镜脚本与视频生成
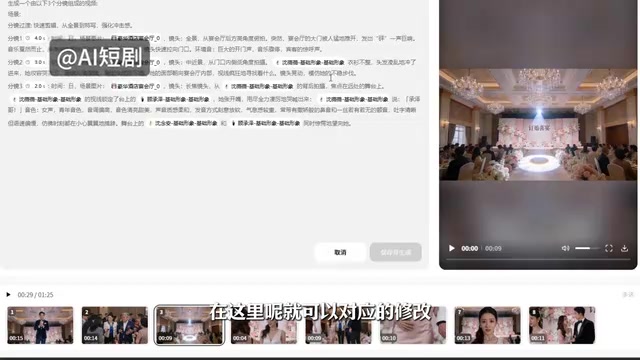
资产就绪后,系统先生成分镜脚本,再逐片段生成视频。
分镜脚本(Storyboard)是影视制作中连接剧本文字与实际拍摄的关键桥梁,其历史可追溯至迪士尼1930年代的动画制作流程。传统上需要专业分镜师手绘完成,涵盖景别(远景、全景、中景、近景、特写)、机位角度(俯拍、平拍、仰拍)、镜头运动(推、拉、摇、移、跟)以及转场方式等视觉化信息——这些视觉语法约定俗成地服务于特定叙事目的:仰角仰拍强调角色权威感,推镜头制造情绪压迫感,快切则营造节奏紧张感。
AI自动生成分镜的难点在于:大语言模型天然擅长处理语义逻辑,但「全景→中景→特写」的镜头语言体系属于视觉叙事的专业语法,需要模型在预训练阶段大量摄取影视剧本与对应分镜的配对数据,理解影视叙事中「情绪-视觉」的隐性映射规律。当前短剧Agent通常依赖经过影视行业数据微调的专用LLM,将「人物情绪高涨」等文学描述自动映射为「仰角特写+推镜头」等摄影机位指令,再传递给视频生成模块执行。这一映射过程在技术上借助了「思维链」(Chain-of-Thought)提示策略:模型先输出包含镜头语言术语的中间推理步骤,再将这些结构化描述转换为视频生成模型可理解的提示词格式,有效桥接了文学叙事语言与视觉生产语言之间的语义鸿沟。每个片段的提示词均可单独编辑修改,给创作者留有一定调整空间。
从最终成片来看,无论是甜妹与猫咪的甜宠对话,还是仙侠剧中「重生复仇」的戏剧张力,整体效果已具备相当的观赏性和情节完整度。
现实的短板:贵、难改、不连贯
实测同样暴露了这套AI短剧流水线目前的三大痛点,创作者需要理性看待。
生成成本偏高
成本是最直接的门槛。以视频中的数据为例,生成一个9秒片段需消耗99积分,换算下来约「10秒钟10块钱」。
这一定价折射出AI视频生成的算力经济现实——视频生成模型(如基于DiT架构的Wan 2.1、CogVideoX等)需要对每一帧进行独立的扩散采样,一段9秒、24fps的视频意味着216帧的并行/串行计算,单次推理需占用数十GB显存并消耗数分钟的A100/H100 GPU算力。相比之下,图像生成通常仅需数秒。理解这一成本结构,需要了解当前GPU算力市场的供需背景:英伟达H100单卡售价超过3万美元,云端租用价格约为每小时2-4美元,而全球AI算力需求的爆发式增长导致高端GPU持续供不应求。这意味着即便是头部AI视频平台,其计算成本也构成收入的重要部分,直接传导至用户端的积分定价体系。
不过,业界对于视频生成成本下降的长期趋势普遍持乐观态度,这一预判有其技术基础:模型蒸馏(Distillation)技术通过让小模型模仿大模型的输出分布,在损失极少质量的前提下将推理速度提升数倍;一致性模型(Consistency Model)则试图将扩散模型的多步去噪过程压缩至1-4步完成,理论上可将推理速度提升10-50倍;量化(Quantization)技术通过降低模型权重精度(如从FP16到INT8)可显著减少显存占用与推理延迟。与此同时,英伟达Blackwell架构GPU(B100/B200系列)相比上一代在AI推理性能上实现了数倍提升,而AMD MI300X的市场竞争也开始对高端AI算力定价形成压制。这些技术路线的共同演进,是业界对「视频生成成本将在1-2年内出现数量级下降」这一预判的底层支撑。但就目前而言,对于动辄数十个分镜的完整短剧,全流程跑下来费用相当可观,反复调整更是烧钱。
修改机制僵化
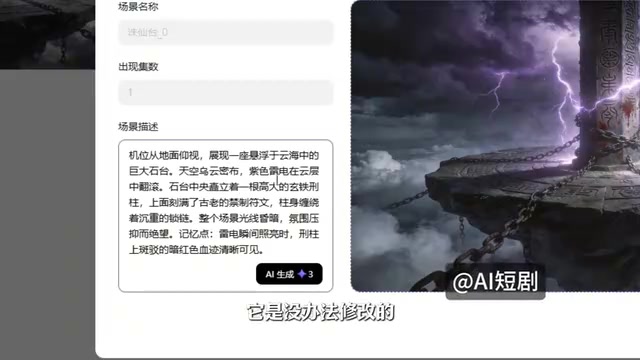
另一个明显短板是修改灵活性不足。当生成的图片只有细微瑕疵时,用户无法进行局部调整,只能「整张重新生成」。这一困境的根本原因在于当前主流扩散模型的生成逻辑——图像生成过程本质上是从随机噪声经多步去噪还原的不可逆过程,模型并不保留「哪个像素对应哪个语义元素」的显式映射。虽然Inpainting(局部重绘)技术理论上可实现局部修改,但在复杂的角色姿态和光影条件下,局部修改极易产生边缘割裂感(俗称「接缝」),反而影响整体质量。这与Adobe Photoshop的「图层」概念有本质区别——AI生成图像目前更接近一张「已曝光的胶卷」,而非可逐层编辑的数字画布。
学界正在探索的解决方向颇具启发性:基于Transformer架构的DiT(Diffusion Transformer)模型通过自注意力机制隐式建立了像素间的语义关联,为未来实现「语义感知局部编辑」提供了理论基础;而2024年兴起的「分割一切模型」(SAM,Segment Anything Model)与扩散模型的结合,也为精准的区域级内容修改开辟了新路径。此外,Google DeepMind发布的Imagen Editor与Adobe Firefly的Generative Fill功能,已初步展示了在商业产品层面实现「语义感知局部重绘」的可行性——这些系统通过将用户的自然语言指令(如「把背景换成夜晚」)转化为精确的区域掩码与条件生成信号,有效回避了直接像素级编辑的技术难题。这两个方向的技术成熟,有望在未来版本的创作平台中带来质的改变。不仅浪费积分,也大幅增加试错成本。
画面一致性难题
最核心的技术难题在于画面连贯性。同一角色和场景在不同片段中,机位与方位常常无法保持一致——第一个片段人物在前,后续片段可能就跑到了后面,明显对不上。
这一问题的本质是视频生成模型缺乏对三维空间的持久化理解:每个片段都是独立的生成过程,模型无法像真实摄影机那样维持一个固定的「世界坐标系」。从更深层的技术视角看,当前主流视频生成模型(无论是基于U-Net还是DiT架构)均在二维像素/潜空间中建模时序关系,其「时间维度」本质上是对帧间统计规律的学习,而非对三维物理世界的真正理解——这与人类视觉系统通过双目视差和运动视差主动构建三维场景模型的机制存在根本差异。
学界目前正在探索的解决方案颇具前景:NeRF(神经辐射场,Neural Radiance Field)通过神经网络隐式编码场景的三维几何与外观信息,可从任意视角渲染高质量图像;而2023年提出的3DGS(三维高斯溅射,3D Gaussian Splatting)以显式的三维高斯椭球体表示场景,渲染速度较NeRF快1-2个数量级,且便于实时编辑。更令业界兴奋的是,2024年已有多个研究团队发布了将3DGS与视频扩散模型结合的混合架构预印本:先由3DGS建立场景的持久三维表示,再以此为几何约束条件引导视频生成模型,确保跨片段的空间一致性。与此并行的另一条路径是「世界模型」(World Model)方向——以Google DeepMind的Genie 2为代表的新一代视频生成模型,尝试通过隐式学习物理规律建立可交互的三维世界表示,而非仅仅模仿视频帧序列的统计分布。这一路线有望从根本上解决当前短剧Agent面临的跨帧空间一致性难题,但距离产品化落地预计仍需1-2年时间。
虽然可以通过写精细提示词(明确指定机位方向、人物位置关系)来缓解,但由于调整成本高,这仍是一个待解的痛点。
总结:能用,但还谈不上全自动
综合来看,短剧Agent代表了AI内容生产从「单点工具」走向「全链路平台」的清晰趋势。它将剧本、角色、场景、分镜、成片整合进一套系统,对创作效率的提升是实打实的——萌系短视频这类相对简单的内容,甚至已能做到「效果不比付费差」。
但实测也坦诚指出,若想「全流程一键出片」,目前仍不现实,依然需要人工介入修改与调整。高昂的算力成本、扩散模型架构固有的修改局限以及画面一致性问题,是横在创作者面前的三道现实门槛。这三大痛点并非偶然——它们分别对应着AI内容生产的三个不同层次的挑战:算力经济的结构性约束(成本问题)、生成式模型与编辑式工具在设计哲学上的根本差异(修改问题),以及二维生成模型与三维物理世界之间尚未弥合的认知鸿沟(一致性问题)。每一层的突破都需要底层技术范式的迭代,而非简单的工程优化。
从更宏观的视角看,短剧Agent所遭遇的这三重困境,恰好映射了整个AIGC产业当前所处的历史节点:第一波「单点工具红利」已基本释放,行业正在向「全链路整合」演进,但真正实现「质量与效率双达标的全自动化生产」,还需等待算力成本曲线的进一步下行、编辑范式从「重新生成」向「语义感知修改」的范式迁移,以及视频生成模型从「二维统计建模」向「三维世界理解」的代际跨越。这三个方向的技术突破时间窗口,将在很大程度上决定AI短剧产业从「半自动」走向「高度自动化」的实际进程。
对于希望抢占流量红利的创作者来说,现在正是学习和布局此类工具的窗口期——提前掌握提示词技巧和资产管理逻辑,往往比等工具完全成熟后再入局更有先发优势。但也要认清现实:AI短剧目前更像是一个高效的「半自动剧组」,而非能完全替代人工的魔法按钮。
核心要点
核心要点
核心要点
核心要点
相关推荐

12GB显卡跑68GB大模型:Betelgeuse引擎实测22 tok/s
开发者发布Betelgeuse推理引擎,在RTX 3060 12GB+16GB DDR4的普通PC上以22 tok/s持续运行68GB Qwen 3.8 Flash Next MoE模型,峰值48 tok/s,且输出100%比特精确。

付费踢人抢网站?这个实验性项目引爆所有权争夺
开发者推出实验性网站 hijackthis.lol,付费1美元即可踢走当前占领者成为网站新主人,保护期与退款机制引发数字所有权博弈。

用领英帖子打造AI分身,靠谱吗?
讨论用多年领英帖子构建知识库型AI分身的可行性:相比模仿文风,引用原始内容的AI克隆更有价值,但面临观点过时、信任授权和持续维护等挑战。