实测七大Claude Code技巧:仅两条真正节省用量
69次对照实验显示,七个流行省额度技巧中只有两个真正有效。
作者针对视频平台上流传的Claude Code省额度技巧,设计了一组可复现的对照实验:69次运行,每个技巧在同一真实任务上分别使用与不使用,各至少跑3次,全部采用Opus 5.5默认设置,并由模型从未见过的隐藏检查统一评分,成本按列表价计算。结果显示,七个技巧中只有任务间使用/clear和保持CLAUDE.md精简真正省下用量;一会话一模型、按需决定是否先规划值得保留;子代理省token是最大误区,成本达5.5倍而得分相同;任务间compact、简洁回复风格反而更贵;插件清理处于噪声边缘,应先查看context占用再决定。
围绕Claude Code的"省额度"技巧在视频平台上流传甚广,但多数缺乏可复现的验证。一位创作者读取了13个流传最广的技巧视频,发现其中只有3个做过对照实验,且没人用模型看不到的隐藏测试来评分。于是他自行设计了一组对照实验:69次运行,每个技巧都在同一个真实任务上分别"用"与"不用",各至少跑3次,全部使用Opus 5.5默认设置,跑完后由模型从未见过的隐藏检查统一评分,成本按Claude Code自身的列表价读数计算。
结论相当反直觉:七个技巧里只有两个真正省下用量,而呼声最高的那个反而是最贵的。
实验方法:隐藏评分与重复运行
这套测试的关键在于两点。一是隐藏检查:评分发生在任务结束之后,模型全程看不到测试内容,避免了"为考试而写代码"的偏差。二是重复运行:作者提到9次相同的无技巧运行之间存在约八分之一的波动,低于这个幅度的差异一律视为噪声。这为后续判断"某技巧贵了5.5倍"是否成立提供了基准。
需要说明的边界条件:任务都是短任务、单一模型、单一代码库。作者本人也承认,多小时的长时间会话可能让compact或简洁风格重新变得划算。
隐藏测试(held-out evaluation) 是机器学习评测中的常见做法:测试集在训练或推理阶段对模型不可见,只在最后用于打分。文章中的做法更严格——检查项由作者单独编写、模型全程接触不到,因此不存在模型针对测试内容进行“应试优化”的可能。这与让模型自己写测试、再自己通过的自评方式有本质区别,后者往往高估真实能力。
重复运行与噪声基准 同样关键。大模型输出具有采样随机性,同一提示多次运行的成本和结果都会波动。作者观察到9次无技巧运行之间约有八分之一的波动,于是把低于该幅度的差异视为噪声,只有显著超出才判定为真实效应。这是判断“贵5.5倍”这类结论是否可靠的前提。
子代理:省token神话的最大反例
流传最广的说法是"用子代理节省token"——每个帮手拥有全新记忆,理论上烧的token更少。作者让Claude读取8个真实代码包,对比开启与关闭子代理的结果。
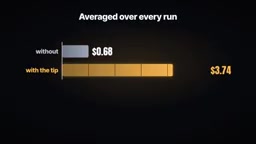
关闭子代理:76秒完成,通过全部46项隐藏检查。启用子代理:Claude每轮启动4到5个帮手,耗时189秒,同样通过46项。平均成本从0.68美元涨到3.74美元,用量是原来的5.5倍,耗时2.5倍,得分完全相同。作者为排除偶然又跑了第四次,成本4.26美元。
更有意思的是Anthropic自家最佳实践页面上有一张"你可以停止做的事"表格,"用子代理保护上下文窗口"正躺在其中——因为上下文不够用如今已很少是真正的问题。子代理在并行任务中仍有价值,但把它当作省钱手段是错的。
子代理(subagent) 指主代理把一部分任务派发给独立的模型实例执行,每个实例拥有独立的上下文窗口和对话历史,完成后把结果汇总回主代理。其设计初衷是并行化与上下文隔离:多个子任务可以同时推进,各自的中间过程不会挤占主代理的窗口。
但“独立上下文”不等于“更少token”。每个子代理都要重新加载系统提示、工具定义和任务背景,这些是重复开销;主代理还要额外消耗token去拆分任务、阅读并整合各子代理的回报。子任务越碎、帮手越多,重复加载和汇总的成本就越高。因此子代理在可并行的独立子任务上能换取墙钟时间,却未必能换来账单上的节省。
清空会话:小幅真实,但别压缩
"任务之间用/clear或/compact"是另一条高频建议。作者让Claude连续完成功能开发、修bug、安全修复三项任务:一个长会话花费2美元;每个任务开新会话(即clear的效果)花费1.83美元,便宜约8%,幅度不大但真实。
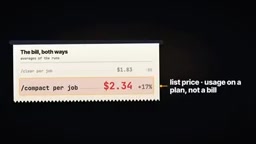
反向操作则适得其反:任务间做compact花费2.34美元,比什么都不做贵17%。原因在于压缩必须先读完整个上下文堆再压缩,本身就是一次大请求。Anthropic的成本页面与这两个结论一致。
有一个小插曲:全新会话的运行有两次漏掉了一项安全检查。作者将其标注为运行次数太少带来的注意事项,而非确定结论。
模型与努力等级:规则要拆开看
"会话中途别换模型、别改努力等级"这条建议只对了一半。作者先完成一个功能任务,再追问一次:同模型同努力等级,成本不到0.04美元;调低努力等级,仍不到0.04美元;中途切换到更小的Sonnet模型,约0.11美元,是原来的2.9倍。
原因在于每个模型有自己的缓存,切换模型会让整个对话重新读取。而在付费计划上调整Opus 5.5的努力等级,缓存仍然保留。所以正确的做法是保留"一会话一模型",放弃"别动努力等级"。
简洁风格:字数少了,账单反而涨了
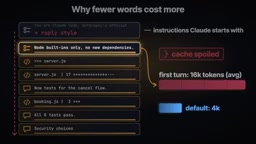
有视频宣称某种"原始人风格"能砍掉65%的token。实测中,这种风格确实少写了12%的字,但整轮运行贵了12%;另一种简洁风格得分相同,成本却高出20%。
矛盾的解释在于缓存:两种风格都改变了Claude启动时的指令,破坏了缓存,导致第一轮就写了约16000个token而不是4000个。这类技巧在短任务上是负收益。
提示缓存(prompt caching) 是理解多条结论的关键机制。服务端会把对话开头那段固定不变的内容(系统指令、工具定义、历史消息)缓存起来,后续请求只需读取缓存而不必重新计费处理。一旦这段前缀发生变化——改系统提示、切换模型、压缩历史——缓存即失效,整段内容要按新输入重新处理。
这也解释了为什么“少写字”反而更贵:简洁风格修改了启动指令,使缓存从第一轮就失效,首轮输入从约4000 token 涨到约16000 token,省下的输出字数远不足以抵消这笔开销。同理,会话中途换模型会各自建立缓存,导致整段对话重读。缓存的存在意味着:稳定性本身就有价格。
先规划再动手:取决于任务是否清晰
同一个功能任务,先规划再构建花费0.81美元、耗时161秒;直接构建花费0.53美元、107秒,两者都是11项检查全过。先规划贵了54%,结果一样。
但Anthropic建议先规划的理由是避免方向错误后的返工,而这个任务本身毫无歧义。所以这条属于"看情况":任务清晰时跳过,方向不明时保留。
CLAUDE.md:要留,但要薄
作者在规则文件中埋了一条"每个新错误回复必须附带消息"的测试。完全没有文件时,Claude每次都漏掉这条规则;31行的精简文件,每次都遵守;599行的臃肿文件把规则埋在深处,也每次都遵守。
文件确实有效,但代价是0.88美元对0.59美元——为了重读每一行,成本高出约一半。Anthropic的建议是控制在200行以内。结论是:留一份,但保持简短。
插件与加载项:先看slash context再动手
"关掉不用的插件"这条建议的实测差距只有18%(0.64美元对0.54美元),处于噪声边缘。过去"某个加载项吃掉26000个token"的警告也已过时,完整工具描述现在只在需要时加载。
正确的做法是先运行slash context看看说话前到底加载了什么,再决定是否删除,而不是盲目清理。
Slash context(在 Claude Code 中键入 /context)是一个诊断命令,用于在正式对话前展示当前会话已经加载了哪些内容、各占多少 token,包括系统提示、CLAUDE.md、已启用的插件与工具描述、MCP 服务器等。
它的价值在于把“看不见的固定开销”显性化。盲目关插件可能删掉真正有用的能力,却只省下噪声级别的用量;而先查看 context 占用,就能定位到真正的大头——例如某个臃肿的规则文件或某个加载了大量工具描述的扩展。工具描述改为按需加载后,旧的“某加载项吃掉数万 token”的经验已不再适用,更需要以实测数据而非传闻作为清理依据。
最终结论
七条技巧里,真正省下用量的只有两条:任务之间用/clear,以及保持CLAUDE.md精简。另外两条值得保留:一会话一模型、按需决定是否先规划。应该跳过的有三条:子代理省token、compact、简洁风格,其中子代理是最响亮的失败案例。插件清理则属于看情况。
这套实验的价值不在于给出终极答案,而在于示范了一种判断方法:任何"省额度"的技巧,都该用隐藏测试和重复运行去验证,而不是凭感觉转发。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。