视觉大模型入门指南:从预训练到下游任务全解析

本文系统梳理视觉大模型的知识框架,涵盖预训练范式、模型分类、演进脉络与学习路径。
本文以一门系统性视觉大模型课程为基础,将该领域知识体系归纳为"预训练"与"下游任务适配"两大板块。文章回顾了大模型从BERT到GPT-3再到ChatGPT的演进脉络,介绍了智能涌现现象及Few-shot/Zero-shot能力的意义,并将当前大模型划分为纯语言LLM、纯视觉模型与多模态VLM三类。核心框架是"从通才到专才"的迁移路径:用自监督学习在海量数据上预训练通用视觉基础模型,再通过知识迁移低成本适配各类下游任务,弥合Domain Gap。文章还指出,CV领域大模型参数规模相对较小,普通实验室几张3090显卡即可完成特定领域预训练,为资源有限的研究者提供了切实可行的入场路径。
视觉大模型(Vision Foundation Model)已成为计算机视觉学术圈最火热的研究方向之一。本文基于一门系统性的视觉大模型课程内容,梳理这一领域的知识框架、技术演进与学习路径,帮助读者建立起对视觉大模型的整体认知。
视觉大模型的两大知识板块
如果要对视觉大模型的知识体系做一个归类,可以清晰地分成两大块:视觉大模型的预训练和下游任务的适配。
所谓预训练,就是从零训练一个大模型的过程。无论是GPT、文心一言,还是各大厂推出的各类大模型,本质上都属于预训练这一范式。而下游任务适配,则是在已有一个训练好的大模型之后,如何将它更好地应用于自己的特定业务任务。
课程的组织逻辑也遵循这一划分:第一章讲解自监督学习(视觉大模型的基础),第二章聚焦纯视觉大模型,第三章讲解多模态视觉大模型——这三章都属于预训练部分;而从第四章开始,进入下游任务迁移的内容。对于核心的网络结构或模块,课程还会以代码形式演示,帮助理解底层原理。
学校实验室也能做视觉大模型吗?
一个常见的疑问是:实验室算力有限,普通人真的能做大模型预训练吗?答案其实比想象中乐观。
NLP领域的大模型确实非常庞大,普通实验室很难有足够算力去训练。但CV领域的视觉大模型,参数量往往没有那么夸张。即使做不了整个CV领域的通用大模型,只要聚焦特定领域、特定规模数据集上的预训练,几张3090显卡有时也足够训练出一个特定领域的视觉基础模型。
退一步讲,即便显卡资源紧张也不必气馁——预训练本身就是一个热门话题。使用普通的ViT小模型,只要效果比同等规模模型更好,就具备发表论文的价值。这为资源有限的研究者提供了切实可行的入场路径。
学习前置要求
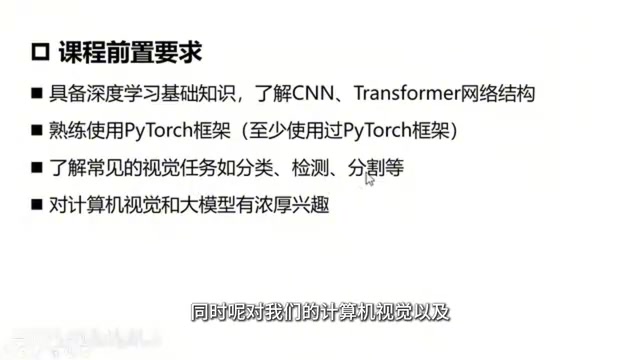
课程尽可能降低了入门门槛,但仍需要一些基础储备:
- 深度学习基础:了解CNN、Transformer等网络结构,清楚训练和测试的流程;
- PyTorch框架:至少使用过PyTorch进行开发;
- CV任务认知:了解分类、检测、分割等常见计算机视觉任务在做什么;
- 对计算机视觉与大模型有浓厚兴趣。
如果这些基础还不牢固,建议先通过课程或网络博客补齐,稍加学习即可有大致了解。
大模型的演进脉络
大模型的崛起主要源于NLP领域的成功。最早在2018年10月,BERT这种基于Transformer的自监督学习方法突然获得了巨大的性能提升。人们由此发现:只要扩大模型和数据规模,就能获得显著更好的性能——这种现象被称为智能涌现。
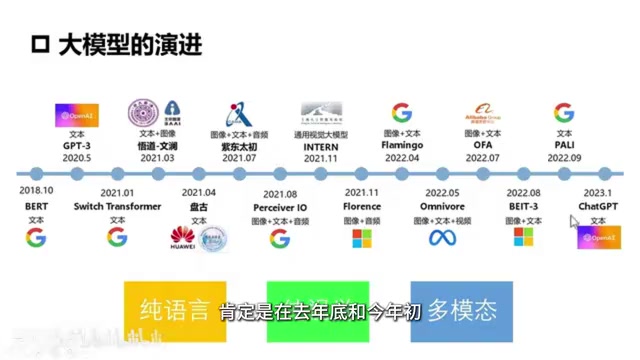
随后GPT-3出现,参数规模达到千亿量级,并展现出**少样本(Few-shot)和零样本(Zero-shot)**能力。也就是说,训练完大模型后,只需极少样本就能适配各种任务,AI开始像人一样具备学习新知识的能力。
之后出现了多模态方法,如清华与智源研究院的悟道系列,在NLP基础上融入图像、音频等模态信息。同时也有纯视觉数据训练的基础模型,如上海人工智能实验室发布的通用视觉大模型。而ChatGPT的产品化爆发,让大模型真正走入大众视野,GPT-4V(Vision)作为多模态大模型,已能同时处理和生成文本与图像内容。
智能涌现(Emergent Abilities) 是指当模型参数量或训练数据规模超过某个临界值后,模型突然获得在小规模时完全不具备的能力。这一现象并非线性提升,而是类似"相变"的跳跃式质变。研究者发现,模型规模从数亿扩展到千亿参数后,算术推理、逻辑类比、多步骤问题求解等能力会"涌现"出来,而这些能力在小模型中几乎为零。GPT-3在1750亿参数规模下展现出的Few-shot和Zero-shot能力正是典型案例——无需针对新任务进行梯度更新,仅凭少量示例描述即可完成任务,这与人类"举一反三"的认知方式极为相似。智能涌现的发现从根本上改变了AI研究的方向:不再执着于为每类任务设计专用结构,而是转向"更大的模型 + 更多的数据"这一统一范式。
大模型的三大分类
基于以上演进,当前大模型可以粗略分为三类:
- 纯语言大模型(LLM,Large Language Model):纯文本处理;
- 纯视觉大模型:仅使用视觉数据训练;
- 多模态大模型(VLM,Vision Language Model):多数情况下是语言加视觉的组合,也可涵盖音频、自动驾驶传感器数据、医疗特殊图像等其他模态。
只要不局限于单一模态信息,就都属于多模态大模型范畴。
VLM(Vision Language Model,视觉语言模型) 的核心技术路径是将视觉编码器与语言模型对齐。代表性工作包括 OpenAI 的 CLIP,它通过对比学习在4亿图文对上联合训练图像编码器与文本编码器,使图像与对应描述在同一向量空间中距离更近。这种对齐使得模型在无需额外标注的情况下即可完成零样本图像分类。后续的 DALL-E、Flamingo、LLaVA 等模型进一步将语言生成能力与视觉理解融合,实现看图问答、图像生成、多轮视觉对话等功能。相比纯视觉大模型,VLM 的优势在于可以用自然语言描述任务目标,大幅降低下游适配成本;代价则是训练需要大量高质量图文配对数据,且语言偏见可能影响视觉推理的准确性。
从通才到专才:视觉大模型的理想形态
引用清华大学戴季峰老师讲座中的框架,视觉领域理想的大模型输入包括海量图像数据、图文成对数据以及纯文本数据。基于这些数据,目标是训练出一个大规模视觉通用感知模型,即视觉领域的主干网络,用它来解决上百种视觉任务。
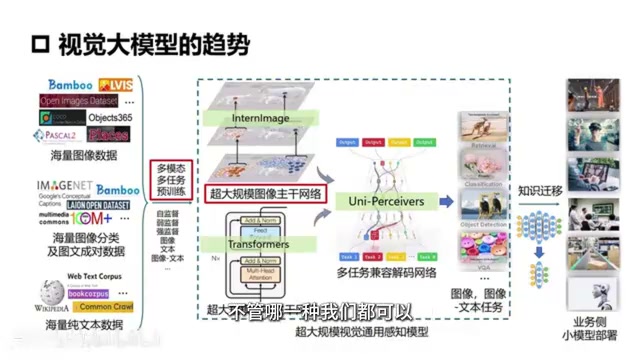
训练方法可以是自监督学习、弱监督学习或强监督学习。只要有足够多的数据、足够大的模型,就能获得一种通用的视觉表征。
但训练好主干网络并非终点。还需要将这个CV大模型迁移到各种下游任务,实现具体业务落地——这个过程叫做知识迁移或迁移学习。由于下游任务的数据与预训练数据往往不同,甚至毫无交集,知识迁移的核心就是解决两者之间的Domain Gap。
这里的大模型称为通才模型,下游针对特定问题的模型称为专才模型,整个流程就是从通才到专才。这一过程与人类教育体系高度相似:通才模型如同九年义务教育,学习各领域基础知识,不求精但求全;专才模型则如同大学专业,聚焦特定领域深耕。
基础模型:范式的转变
在"大模型"这一词汇流行之前,学术界一般称之为基础模型(Foundation Model),两者描述的是同样的东西。
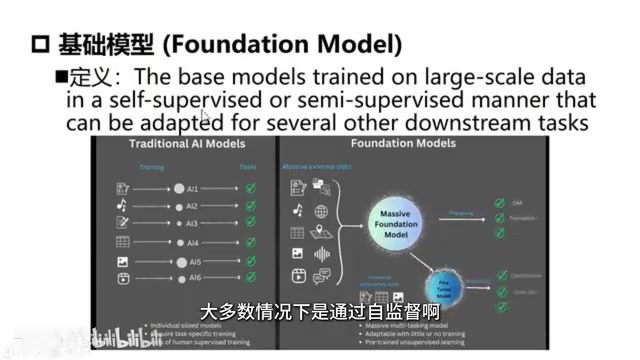
基础模型的定义是:在大规模数据(Large Scale Data)下训练得到的模型,大多数情况下通过自监督或半监督学习方式实现(也有采用强监督的),并且能够适配到大量下游任务中。
整个AI领域已经从传统训练范式转型为基础模型的"Pre-Training + Fine-Tuning"时代。我们不再需要针对不同任务分别采集数据集、训练单独的模型,也不再需要大量人工标注。取而代之的是用无监督学习从海量数据训练一个模型,再用极少样例数据低成本迁移到一系列下游任务。
基础模型还可以是层级式的:从整个CV领域的大模型,迁移得到医疗领域基础模型,再进一步迁移到病理图像、MRI、CT等更细分的专才模型,实现不同程度的专业化。
Pre-Training + Fine-Tuning 范式的核心价值在于解耦"通用表征学习"与"任务特定学习"两个阶段。预训练阶段利用海量无标注或弱标注数据,让模型学习到丰富的世界知识和特征表示;微调(Fine-Tuning)阶段则在少量有标注的下游任务数据上做轻量级更新,使模型快速适应特定场景。相比传统的从头训练(Training from Scratch),Fine-Tuning通常只需更新部分参数(如最后几层),甚至发展出 Prompt Tuning、Adapter、LoRA 等参数高效微调(PEFT)方法,进一步降低计算成本。Domain Gap 是指预训练数据分布与下游任务数据分布之间的差异,例如在自然图像上预训练的模型直接用于医学病理图像时性能大幅下降。如何通过迁移学习技术弥合这一差异,是当前视觉大模型落地应用的核心挑战,也是课程下游任务适配板块的主要内容。
结语
视觉基础大模型是当前CV学术圈最火热、发展最迅速的方向之一。理解"预训练+下游适配"这一双板块框架,掌握从通才到专才的迁移思路,是入门这一领域的关键。后续深入学习中,自监督学习、纯视觉大模型、多模态模型以及各类下游迁移方法,都将围绕这一主线展开。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。
Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。
Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。