事实核查分数提升的真相:证据比答案更关键
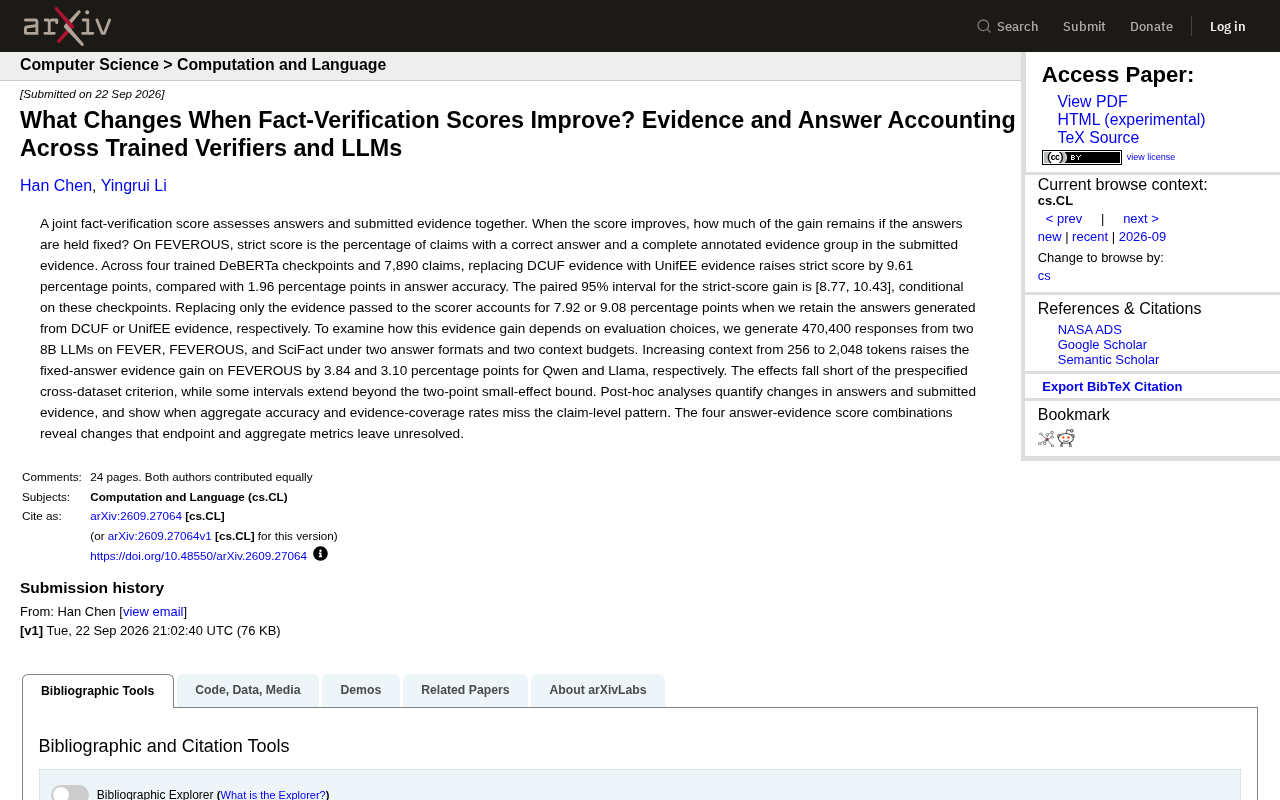
拆解事实核查联合分数发现,证据质量的贡献远超答案正确性,联合指标会掩盖真实能力边界。
这篇研究针对自动化事实核查系统中「联合评估分数上涨究竟意味着什么」这一问题展开严谨的归因实验。以FEVEROUS数据集为核心场景,研究团队通过替换证据检索系统(DCUF vs. UnifEE)、固定答案模块的对照设计,发现证据替换可使严格分数提升9.61个百分点,而对答案准确率的提升仅为1.96个百分点。进一步的精细拆解确认,单独替换评分器接收的证据即可独立贡献约8-9个百分点的提升。研究还指出,整体准确率和证据覆盖率等聚合指标会掩盖声明层面的真实变化,提出「答案对/错×证据全/缺」四象限框架作为更诚实的评估工具。这些发现对事实核查、RAG系统及可信AI评估均有直接方法论价值。
当事实核查分数上升时,究竟是什么在改变?
自动化事实核查(fact-verification)系统的评估往往依赖一个联合分数:既评判模型给出的答案是否正确,也评判它提交的支撑证据是否完整。问题在于,当这个综合分数上升时,我们很难判断改善究竟来自答案质量的提升,还是来自证据检索的优化。这篇发表于 arXiv 的研究(arXiv:2609.27064v1)正是围绕这一问题展开,尝试用严谨的实验设计把「答案」和「证据」两个贡献来源拆解开来。
研究以 FEVEROUS 数据集为核心场景。在该数据集中,严格分数(strict score)被定义为:既有正确答案、又在提交证据中包含完整标注证据组的声明所占的百分比。换句话说,一个声明要拿到分数,答案对和证据全缺一不可。这种双重门槛让「拆账」分析变得尤为必要。
FEVEROUS(Fact Extraction and VERification Over Unstructured and Structured information)是一个专为复杂事实核查设计的基准数据集,要求系统同时处理维基百科中的非结构化文本与结构化表格数据。与早期的 FEVER 数据集相比,FEVEROUS 的核心挑战在于证据往往分散在多个异构来源中,单条声明可能需要跨段落与跨表格的联合推理才能验证。数据集中的每条声明都附有人工标注的「黄金证据集」,即正确验证该声明所必需的最小证据组合。严格分数的双重门槛设计正是源于此:若系统提交的证据未能完整覆盖黄金证据集,即便答案标签正确,该声明也不计入得分。这一设计初衷是鼓励系统给出「可解释的」验证结论,而非仅凭运气猜对答案。
证据替换带来的增益远超答案本身
研究团队在四个训练好的 DeBERTa 检查点、共 7,890 条声明上做了对照实验。核心发现相当直观:把 DCUF 证据替换成 UnifEE 证据后,严格分数提升了 9.61 个百分点,而同一操作对答案准确率的提升仅为 1.96 个百分点。两者近五倍的差距说明,联合分数的大部分改善其实来自证据质量,而非模型答对了更多题。
配对的 95% 置信区间为 [8.77, 10.43](条件于这些检查点),说明这一增益在统计上相当稳健。研究进一步做了更精细的归因:如果只替换传给评分器的证据、而保留基于 DCUF 或 UnifEE 证据生成的答案,严格分数的改善分别为 7.92 和 9.08 个百分点。这一结果直接量化了「仅仅换证据」这一动作对分数的独立贡献,剥离了答案变化的干扰。
这一发现对领域的意义在于:许多号称提升事实核查性能的方法,其收益可能主要来自更好的证据检索管线,而非核心推理能力的进步。如果不做拆解,很容易把证据侧的红利误记在模型答题能力的账上。
实验中涉及的 DCUF 与 UnifEE 是两种用于 FEVEROUS 的证据检索系统,代表了不同的检索管线设计。DCUF(Decompose, Classify, Unite, Filter)采用分解式策略,将声明拆解为子问题后分别检索再合并;UnifEE(Unified Evidence Extraction)则通过统一的抽取框架同时处理文本与表格,在证据召回的完整性上表现更优。DeBERTa(Decoding-Enhanced BERT with Disentangled Attention)是微软研究院提出的预训练语言模型,在自然语言推理和文本蕴含任务上表现突出,常被用作事实核查流水线中的答案预测(verdict prediction)模块。将 DeBERTa 检查点与不同证据来源组合,可以在固定模型能力的前提下单独操控证据质量,从而实现因果意义上的贡献拆解。
上下文预算如何影响证据增益
为了检验这种证据增益是否依赖具体的评估选择,研究团队还在 FEVER、FEVEROUS 和 SciFact 三个数据集上,用两个 8B 规模的大语言模型(Qwen 与 Llama)生成了 470,400 条回复,覆盖两种答案格式和两种上下文预算。
结果显示,把上下文从 256 token 扩展到 2,048 token 后,在 FEVEROUS 上「固定答案条件下的证据增益」分别提升了 3.84(Qwen)和 3.10(Llama)个百分点。这意味着给模型更大的上下文窗口,确实能让证据侧的表现更好,但幅度并不算大。
研究还设定了一个跨数据集的预先判定标准,用来判断效应是否显著。实际效应未能达到这一标准,不过部分置信区间确实超出了「两个百分点」的小效应边界。这种谨慎的表述提醒读者:证据增益的存在性有一定证据支撑,但其规模和跨数据集的一致性仍需保留态度。
聚合指标为何会掩盖真实变化
论文的一个重要方法论贡献,是指出常用的聚合指标(如整体准确率、证据覆盖率)会错过声明层面(claim-level)的模式。事后分析量化了答案和提交证据各自的变化情况,并揭示了在什么条件下,宏观的准确率和覆盖率数字会与逐条声明的实际变化脱节。
研究提出了「答案—证据」四种组合的分析框架:答案对/错 与 证据全/缺 交叉,形成四个象限。这种细粒度的核算方式,能揭示端点指标(endpoint metrics)和聚合指标留下的空白。例如,一个方法可能在整体准确率上看起来没变,但实际上有大量声明从「答案对但证据缺」变成了「答案对且证据全」——这种迁移只有在声明层面才看得见。
对于从事事实核查、检索增强生成(RAG)以及可信 AI 评估的研究者,这套核算方法提供了一个更诚实的评估视角:不要只看一个综合分数上涨了多少,而要追问上涨的来源、以及不同声明是如何在四个象限间流动的。
这种「答案—证据」四象限分析与因果推断中的异质性处理效应(heterogeneous treatment effect)分析思路一脉相承:系统层面的平均改善可能掩盖大量方向相反的个体变化。在检索增强生成(RAG)系统的评估实践中,类似的问题同样普遍存在——常见的端到端指标如 RAGAS 评分或 answer faithfulness,将检索质量与生成质量混为一体,难以指导针对性优化。四象限框架的价值在于将「正确但证据不足」和「证据充分但答案错误」这两类不同性质的失败模式区分开来,前者提示检索管线需要改进,后者则指向推理模块的缺陷,二者对应截然不同的工程干预方向。
对可信 AI 评估的启示
这项工作虽然聚焦在一个较为专门的评估问题上,但其思路具有普遍价值。随着大模型越来越多地被用于需要引用来源、提供证据的任务,如何区分「答对了」和「给对了依据」变得至关重要。一个能给出正确结论却提供错误或不完整证据的系统,在高风险场景中同样不可信。
研究传递的核心信息是:评估事实核查系统时,应当把证据质量和答案正确性分开核算,并深入到声明层面观察变化。单一的联合分数虽然方便,却容易掩盖真实的能力边界。对希望在检索、证据聚合与生成之间做取舍的工程实践者而言,这种拆账方法能帮助把资源投入到真正带来收益的环节。
相关推荐
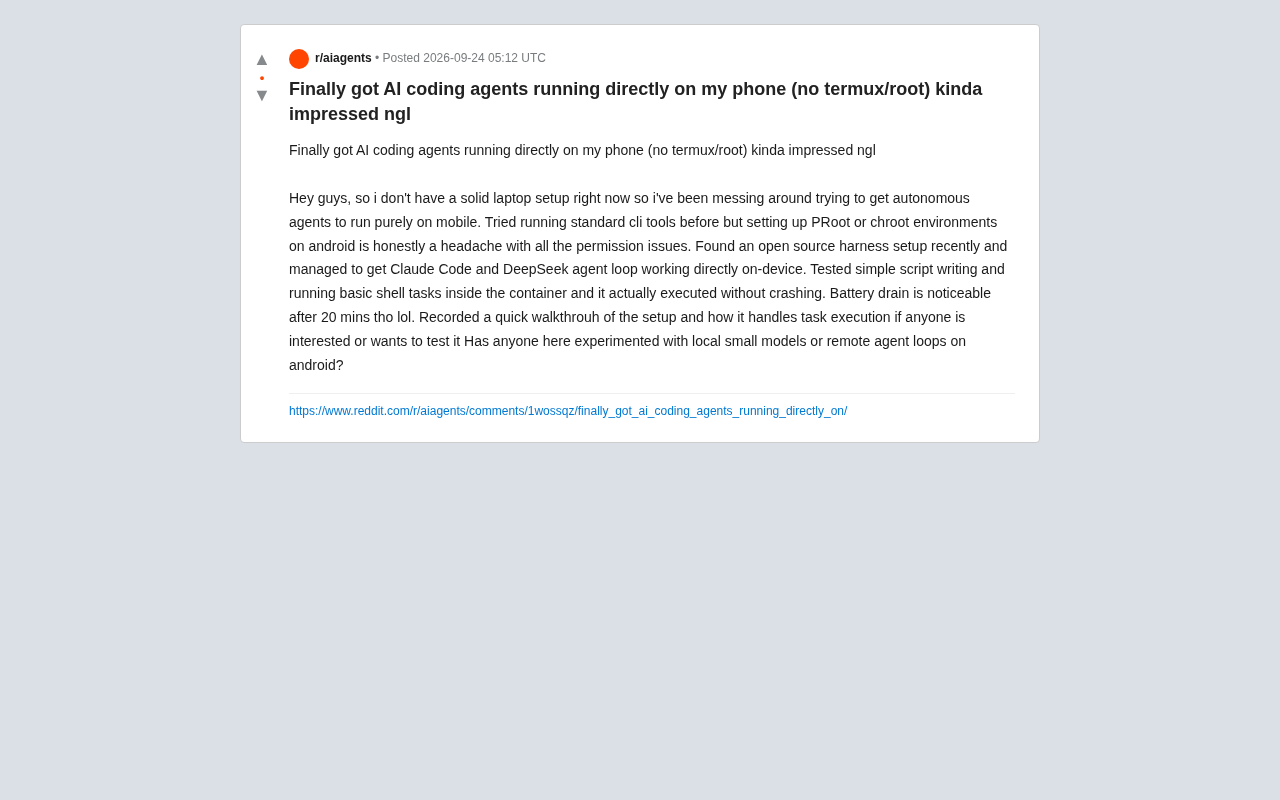
手机直接运行AI编程Agent:无需Termux和Root的实践
一位Reddit用户成功在Android手机上直接运行Claude Code和DeepSeek的AI编程Agent,无需Termux或Root,借助开源harness绕开PRoot环境配置难题,但续航问题依然明显。
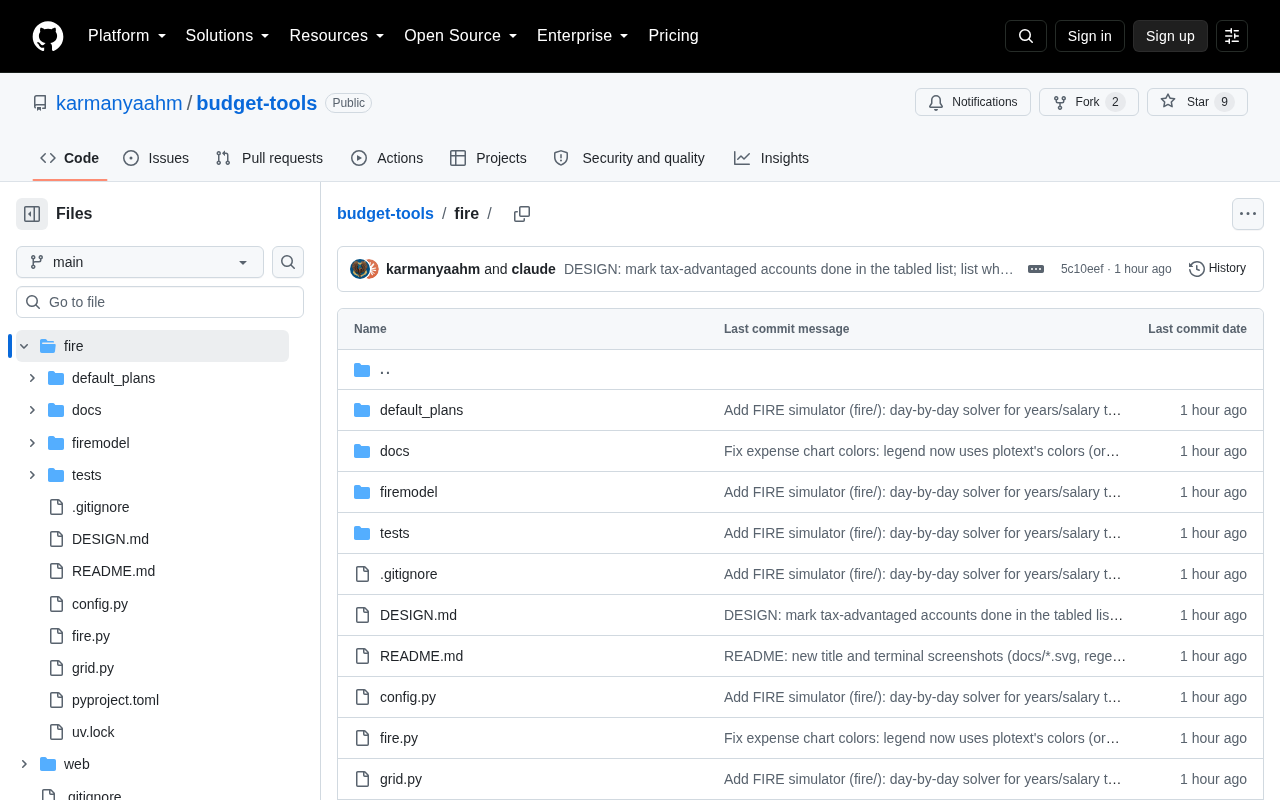
财务自由计算器:算清工作多久才能提前退休
一款登上 Hacker News 热榜的财务自由计算器,帮你算清按当前薪水还需工作多久才能进入 Coast 滑行状态或提前退休。解析 FIRE、4% 法则与工具背后的复利逻辑。
AI产品经理如何撰写Skill需求文档:模板与实战方法
AI产品经理如何撰写Skill需求文档?本文梳理出命名、概述、实现逻辑、输出效果、错误处理五大模板要素,并对比完全AI生成、手写+AI润色、纯手写三种写作方式的优劣,助你高效产出研发可落地的Skill需求文档。