数据驱动策略的风险:CVaR视角下的样本风险溢价

论文用CVaR分解数据驱动策略风险,揭示样本风险溢价可占总遗憾74%-97%。
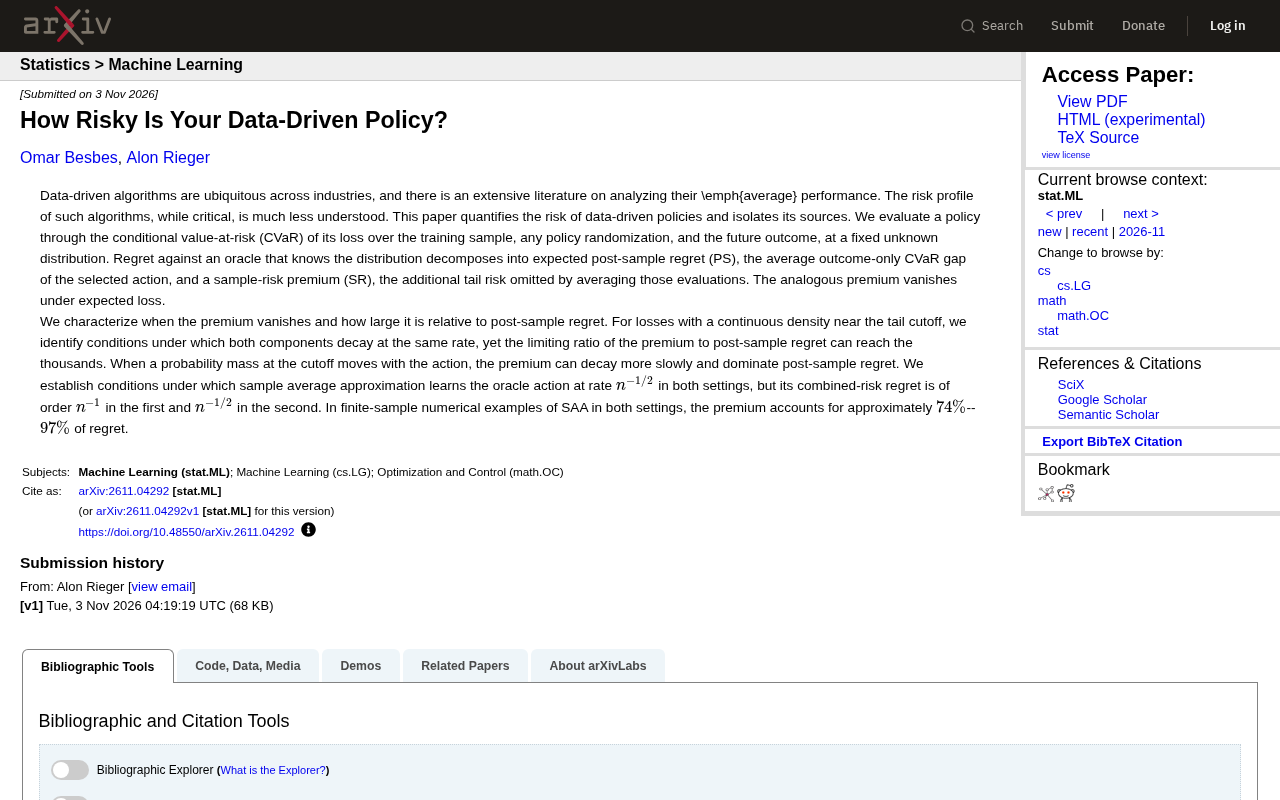
该论文采用条件风险价值(CVaR)度量数据驱动策略的尾部风险,并将遗憾分解为期望后样本遗憾、仅结果CVaR差距和样本风险溢价三部分。研究发现,样本风险溢价在期望损失准则下消失,但在CVaR准则下可能主导遗憾,极限比值可达数千倍。当截断点概率质量随动作变化时,样本风险溢价衰减更慢,SAA的组合风险遗憾阶数从n^{-1}变为n^{-1/2}。有限样本实验中,样本风险溢价约占总遗憾的74%-97%,表明尾部风险常被平均评估掩盖。实践者应将样本风险溢价纳入常规风险评估,尤其在金融、医疗等风险敏感领域。
数据驱动的算法决策已渗透到各行各业,但学术界对其平均性能的分析远多于对风险剖面的理解。一篇最新论文《How Risky Is Your Data-Driven Policy?》深入量化了数据驱动策略的风险,并拆解了风险的来源。本文基于该论文的核心结论,解读其分析框架与关键发现。
风险度量的新框架:CVaR与遗憾分解
传统上,策略评估往往关注期望损失或平均表现。而这项研究采用条件风险价值(CVaR)来刻画策略在训练样本、策略随机化以及未来结果上的尾部损失。具体而言,研究者将策略的遗憾(regret)相对于一个知晓真实分布的“预言机”进行分解,得到三个组成部分:
- 期望后样本遗憾(PS):策略在未见数据上的平均表现差距。
- 仅结果CVaR差距:所选动作在结果分布上的尾部风险差距。
- 样本风险溢价(SR):由于平均化评估而忽略的额外尾部风险。
这种分解揭示了风险的两个独立来源:一是策略在平均意义上的次优性,二是尾部风险的“隐藏成本”。
你可能没注意到,在期望损失准则下,样本风险溢价会消失;但在CVaR准则下,它可能成为主导因素。
样本风险溢价何时消失?何时主导?
论文进一步刻画了样本风险溢价消失的条件,以及它相对于后样本遗憾的大小。对于尾部截断点附近具有连续密度的损失分布,研究者发现:即使两个组成部分以相同速率衰减,样本风险溢价与后样本遗憾的极限比值仍可能达到数千倍。这意味着,在平均表现看似接近最优的策略,其尾部风险可能被严重低估。
当截断点处存在随动作变化的概率质量时,样本风险溢价的衰减速度可能更慢,甚至主导后样本遗憾。这一发现挑战了“平均性能好即风险低”的直觉,提示实践者需要单独审视尾部风险。
学习速率与有限样本表现
在两种设定下,样本平均近似(SAA)都能以 (n^{-1/2}) 的速率学习到预言机动作。然而,其组合风险遗憾的阶数却不同:第一种设定下为 (n^{-1}),第二种设定下为 (n^{-1/2})。这表明,当截断点概率质量随动作变化时,SAA的收敛速度会变慢。
有限样本数值实验进一步证实了理论分析:在两种设定下,样本风险溢价约占总遗憾的74%至97%。这一比例远高于许多实践者的预期,说明在风险敏感的场景中,忽略样本风险溢价可能导致严重的决策偏差。
对实践者的启示
这项研究传递了一个明确信号:数据驱动策略的风险评估不能止步于平均性能。尤其是在金融、医疗、自动驾驶等对尾部风险敏感的领域,样本风险溢价应成为策略评估的常规指标。实践者可以通过CVaR等风险度量来显式地量化尾部风险,并在模型选择时权衡平均表现与风险溢价。
同时,论文的分解框架为诊断风险来源提供了工具:如果样本风险溢价占比过高,可能需要增加样本量或改进采样策略;如果后样本遗憾主导,则需关注策略在未知分布上的泛化能力。
总之,数据驱动策略的风险并非单一维度,CVaR视角下的分解揭示了被平均掩盖的尾部风险,值得算法设计者和决策者深入关注。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。