四大AI图像模型实测:同一题目下谁画露珠更真实
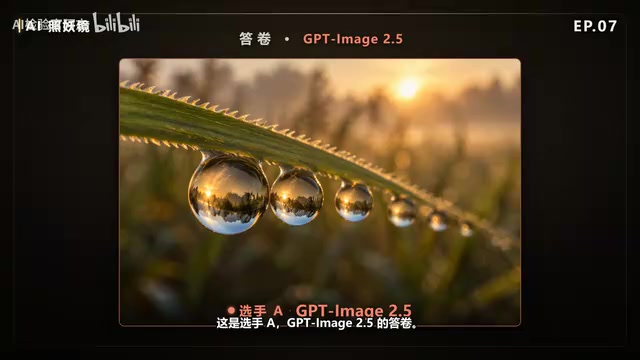
四款AI图像模型同题竞技,GPT Image 2.5凭借景深与焦点控制夺冠,露珠物理逻辑成最大分水岭。
本文记录了一场以「一寸之间」为题的AI图像生成评测,考察四款模型在极近距离下还原露珠、绒毛与晨雾细节的能力,并引入多个AI模型担任评委进行综合打分。GPT Image 2.5以78.2分夺冠,胜在近实远虚的景深层次与清晰的视觉焦点;通义Image 3.0 Pro以74.5分居次,氛围禅意但暗部细节牺牲过多;即梦5.0 Pro得68.2分,雾感晨光讨喜却因焦点偏移削弱叙事;Nano Banana 2以52分垫底,露珠「坐」而非「悬」的物理失真是核心败因。评测同时揭示,物理真实感与景深控制正成为区分模型能力的关键维度,而AI评委机制本身因模型审美偏差存在局限,分数更宜作横向参考。
一场由AI当裁判的图像生成对决
在这期名为「AI照妖镜」的实测中,创作者设计了一个颇具巧思的评测机制:让四款主流AI图像模型各自作答同一道题目,再由多个AI模型充当评委进行综合打分。题目名为「一寸之间」,考察的是在极近距离下对细节质感的还原能力——具体表现为叶片上的露珠、绒毛与晨雾的微妙层次。
这种「AI选手+AI评委」的双重设定,本身就是一个有趣的观察窗口。它不仅检验各家模型的出图水平,也间接暴露了不同评委模型对「画面质量」的理解差异。参赛的四位选手分别是 GPT Image 2.5、通义 Image 3.0 Pro、Nano Banana 2,以及即梦(C Dream)5.0 Pro。
选手A:GPT Image 2.5 以细节层次夺冠
GPT Image 2.5 在本期拿下冠军,综合得分 78.2 分,是四位选手中唯一突破 78 分的作品。评委 GPT 6 给出的评价是「近远地虚,双珠近处最佳」,意指画面在景深处理上形成了近实远虚的层次,让近处的两颗露珠成为视觉焦点,符合微距摄影的基本美学逻辑。
不过这份答卷并非无可挑剔。评委 Code 指出了一个构图瑕疵——「太阳直接入画犯题」,即画面中直接出现了太阳,这在一道强调「一寸之间」近距离质感的题目中略显跑题。正负评价相抵后,GPT Image 2.5 仍凭借扎实的景深与焦点控制领先全场。
选手B:通义 Image 3.0 Pro 禅意与暗部的取舍
通义 Image 3.0 Pro 获得 74.5 分,位列第二。有意思的是,评委中同样包含通义自身模型,它给出了偏向正面的评价——「绒毛亮边与雾感渐变最禅意」,肯定了画面在柔光质感和氛围营造上的表现。
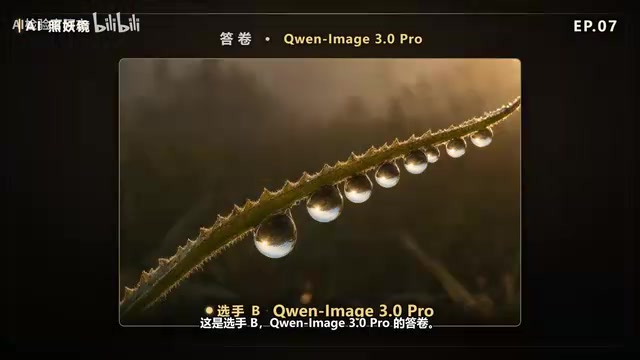
但评委 Gemini 的视角更为挑剔:「暗部过重,缺失发丝及相处间隙」。这说明该作品在整体氛围讨喜的同时,牺牲了暗部的细节信息,一些本应清晰呈现的绒毛发丝和结构缝隙被过深的阴影吞没。禅意与信息量之间的平衡,成了这份答卷的主要失分点。
选手C:Nano Banana 2 露珠物理逻辑失准
Nano Banana 2 以 52.0 分垫底,与冠军差距超过 26 分,是本期拉开最大差距的一次。评委 Code 的点评直指核心问题:「露珠多数坐在页面上而非悬垂,页面满布碎水滴」。
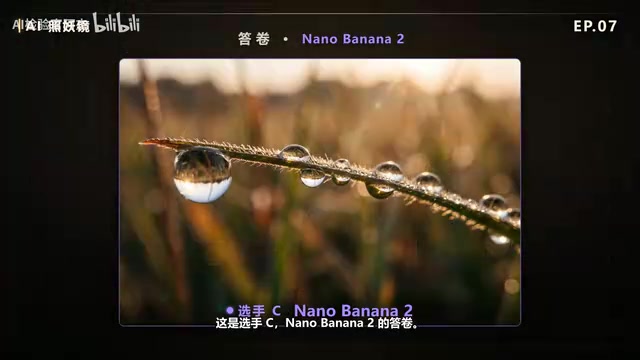
这个评价揭示了AI图像生成中一个常被忽视的难点——物理真实感。真实世界中的露珠会因重力在叶片边缘悬垂,呈现出特定的形态与光学折射;而该模型生成的露珠更像是「贴」在表面的平面水滴,且数量过多、分布杂乱,缺乏符合物理直觉的排布。这类错误往往比构图问题更容易被识破,也更难修正。
露珠的物理真实感之所以难以还原,根源在于它涉及多个物理规律的同时成立:表面张力决定露珠在光滑叶面上呈近球形隆起,重力使边缘露珠向下拉伸成泪滴状,而光学折射则让露珠内部呈现出倒置的环境映像。AI图像模型在生成时依赖统计模式而非物理仿真,往往能学会「露珠长这样」的外观特征,却难以内化「露珠为什么长这样」的力学逻辑。一旦场景偏离训练数据的常见视角——例如极近距离的微距构图——这种表层模仿便容易露馅,呈现出「贴图感」而非真实感。这也是为何物理真实感的考察,往往比色彩或构图更能区分模型的生成能力上限。
选手D:即梦 5.0 Pro 氛围出色但焦点偏移
即梦(C Dream)5.0 Pro 获得 68.2 分,表现中规中矩。评委 Code 对其氛围给予肯定——「雾感晨光漂亮」,说明在晨光渲染和雾气质感上该模型有一定造诣。
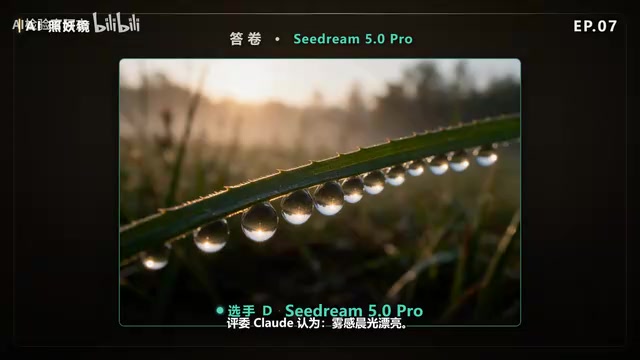
失分则来自构图层面。评委 Gemini 指出「焦点未落在最近最大露珠上,视觉重心出现偏移」。在微距题材中,观者的视线理应被引导至最前、最大的主体露珠上,而该作品的视觉重心跑偏,削弱了画面的叙事焦点。氛围讨喜但主次不清,是这份答卷的典型特征。
这场评测透露出的几个信号
把四份答卷并排对比,可以提炼出几点值得关注的趋势。
第一,物理真实感正成为分水岭。Nano Banana 2 的垫底并非输在美感,而是输在露珠的物理逻辑——这类「看着就不对」的错误,是当前图像模型拉开差距的关键维度。
第二,景深与焦点控制决定上限。冠军 GPT Image 2.5 的优势正在于近实远虚的层次感和明确的视觉焦点,这与排名靠后作品的「焦点偏移」形成鲜明对比。
第三,氛围好看不等于高分。通义和即梦都在雾感、晨光等氛围营造上获得好评,但分别因暗部过重和焦点偏移丢分,说明单一维度的讨喜难以转化为综合高分。
需要说明的是,「AI评委」机制本身存在局限——评分依赖评委模型的审美取向,不同评委对同一画面的判断存在分歧(如通义自评偏高、Gemini 偏严),因此这些分数更适合作为横向参考而非绝对标准。真正的裁判,或许还得交给人眼。
换作是你来当评委,又会给这四份露珠答卷打几分?
「AI评委」机制在图像评测领域属于新兴实践,其原理是将待评图像输入语言-视觉多模态模型,要求模型依据给定标准输出文字评价与量化分数。这一方式的优势在于可复现、可并行,且不受人类评委主观情绪波动影响;局限则在于不同模型的视觉理解能力与审美偏好存在系统性差异——本文中通义模型对自身作品给分偏高、Gemini对暗部细节更为敏感,均属于评委自身偏差的典型表现。此外,多模态模型对图像的「理解」本质上仍是特征匹配,对某些需要直觉判断的美学维度(如画面气息、情绪张力)的把握,与人类专业评委之间仍有明显落差。因此,AI评委更适合用于标准明确的技术维度评分,而非全面的艺术价值判断。
相关推荐
FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。
前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。