AI游戏开发能力实测:4大模型13项对决深度解析
AI游戏开发能力的极限挑战
随着大语言模型能力的飞速演进,AI在游戏开发、3D建模和图形创作领域的表现,已成为衡量其综合能力的重要标尺。一项覆盖13个测试项目的横向评测,将四款前沿模型——Kimi K3、Claude Opus 5、Grok 4.6 以及 GPT-5.6 Sol(Max)——放在同一起跑线上进行较量。
测试遵循「一次机会」原则:每个模型面对完全相同的提示词,仅有一次生成机会,最终结果依据实际产出内容评判。这种严苛的基准测试方式,不仅考验模型的能力上限,更凸显其在效率、成本和稳定性上的真实表现。在实际使用中,用户往往会通过多轮对话、反复修改提示词来优化输出,这种迭代过程掩盖了模型首次理解和执行复杂指令的真实能力。one-shot测试剥离了人为干预因素,直接暴露模型在指令理解、代码生成、空间推理等方面的基线表现,这对于需要自动化流水线集成的工业场景——例如CI/CD管线或批量资产生成——尤为关键。这种方法借鉴了软件工程中基准测试(Benchmarking)的核心理念,类似于SPEC CPU测试套件对处理器性能的标准化评估。在AI领域,它与HumanEval(代码生成基准)、MMLU(多任务语言理解基准)等标准化评测的设计哲学一脉相承——通过消除外部变量来获得可重复、可比较的结果。对于游戏开发这类高度综合性的任务,one-shot测试还隐含着对模型「第一性原理」理解能力的考察:它是否真正理解了3D空间、游戏逻辑和美术原则,还是仅仅在模式匹配训练数据中的相似片段。
此次测试由 Moonshot AI 赞助,其 Kimi K3 被定位为该公司最强大的开源模型,总参数高达2.8万亿,拥有100万Token的上下文窗口,并原生支持多模态,专注于优化编码能力。2.8万亿的参数规模使其跻身全球最大的开源模型之列。值得注意的是,如此庞大的参数量并不意味着推理时的计算成本同比增长——混合专家(Mixture of Experts, MoE)架构允许模型在推理时仅激活部分参数,从而在保持知识广度的同时控制计算开销。MoE架构最早由Hinton等人在1991年提出,近年来因Google的Switch Transformer和Mixtral等模型而重新获得广泛关注。在MoE架构中,模型被分为多个「专家」子网络,每次推理时通过门控网络(Gating Network)选择性地激活其中一小部分(通常为2-8个专家),其余专家处于休眠状态。这意味着一个2.8万亿参数的MoE模型,实际推理时可能仅激活数百亿参数,推理成本可能仅为同等规模密集模型的十分之一。100万Token的上下文窗口意味着模型可以一次性处理约75万个英文单词或数十万行代码,这对于理解大型代码库、长篇技术文档或复杂的多文件项目结构至关重要。作为开源模型,Kimi K3还允许开发者自行部署和微调,在数据隐私敏感或需要深度定制的企业场景中具有显著优势。当前开源大模型竞争格局日趋激烈——Meta的LLaMA系列、Mistral AI的模型、DeepSeek等已形成活跃的开源生态,Kimi K3的加入进一步加剧了这一领域的竞争,也为开发者提供了更多元化的选择。
3D建模与资产创作:效率与质量的平衡
测试从构建一个受《荒野大镖客》启发的酒馆内部场景开始,模型需要用Blender自行制作资产来布置空间,酒吧后挡板、天花板和吊灯是关键考察点。Blender是业界广泛使用的开源3D创作套件,支持通过Python API进行程序化操作。当AI模型被要求「用Blender制作资产」时,它实际上需要生成可执行的Python脚本,调用Blender的bpy模块来创建几何体、设置材质、配置光照和摄像机。bpy模块提供了对Blender几乎所有功能的编程访问,包括网格操作(bmesh模块)、修改器堆栈(如Subdivision Surface细分曲面、Boolean布尔运算、Array阵列等)、节点式材质系统(Shader Nodes)、粒子系统、物理模拟,以及对Cycles和EEVEE两种渲染引擎的完整配置。程序化建模(Procedural Modeling)本身是一个成熟的技术领域,SideFX的Houdini是其商业标杆,而Blender的Geometry Nodes自3.0版本引入后也大幅增强了节点化程序生成能力。
这要求模型同时具备3D空间推理能力(理解物体的尺寸比例与空间位置关系)、程序化建模知识(如何用代码描述曲面、布尔运算、细分修改器等)以及美术审美(材质色彩搭配、光影构图)。AI模型生成Blender脚本时面临的独特挑战在于:它需要将自然语言描述的视觉概念转化为精确的几何操作序列,这种从「语义空间」到「几何空间」的映射目前仍是计算机图形学与AI交叉领域的前沿课题。一个酒馆场景中的吊灯,可能涉及数十行代码来定义灯罩形状、金属支架、灯光发射器及其阴影参数,任何一处的参数失误都可能导致视觉效果崩塌。
Kimi K3 生成了多达9个资产,且成本远低于 Opus 5,展现出极高的性价比。GPT-5.6 SoMax 虽然耗时超过一个小时,却仅创建了3个资产,不过其台球桌和配套墙架颇具亮点。综合成本与时间,Kimi K3 在此项测试中表现最佳。
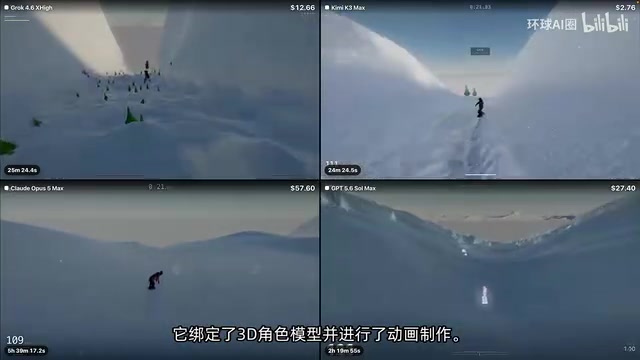
在滑板游戏测试中,各模型需制作完整的游戏循环。Opus 5 完整性最出色,不仅绑定了3D角色模型,还完成了动画制作——这或许也是它耗时长达5小时39分钟的原因。角色绑定(Rigging)是3D动画制作中技术复杂度极高的环节,需要为模型创建骨骼系统(Armature),并通过权重绘制(Weight Painting)将网格顶点与骨骼关联,使骨骼运动能驱动模型表面的自然变形。一个基础的人形骨骼通常包含20-30根骨骼,而带有手指和面部表情的完整绑定可能需要上百根。在此基础上制作动画还需要设定关键帧、处理动画曲线的插值方式(如贝塞尔曲线平滑过渡),以及确保不同动画状态之间的混合过渡自然。在游戏引擎中,动画状态机(Animation State Machine)负责管理角色在待机、行走、跳跃、技巧等不同状态之间的切换逻辑,每个转换通常附带混合时间(Blend Time)参数以避免动作突变。Opus 5能独立完成这一完整流程,说明其在时间轴数据处理和骨骼层级推理方面具备相当的深度。这也解释了它为何在此任务上投入了如此长的时间——它不仅在生成静态模型,还在处理骨骼层级、蒙皮权重和时间轴上的动画数据。
然而在雪地物理效果的观感上,其他模型反而更具优势。游戏物理引擎需要模拟摩擦力、重力加速度、碰撞响应、角色惯性等多种物理属性。Grok 制作的游戏控制手感极佳——所谓「手感好」,本质上是物理参数与玩家输入响应之间的精细平衡。游戏手感(Game Feel)是游戏设计领域由Steve Swink在其同名著作中系统化阐述的核心概念,涵盖了大量微妙的设计模式:例如转向的灵敏度曲线、加速度的非线性映射、跳跃时的「土狼时间」(Coyote Time,即离开平台后仍有短暂跳跃窗口的宽容机制),还有输入缓冲(Input Buffering,在当前动作完成前提前接受下一次输入指令)、镜头抖动(Screen Shake)、打击停顿(Hit Stop,碰撞瞬间短暂冻结画面以增强打击感)、以及速度线和拉伸变形(Squash & Stretch)等众多细节。这些参数通常需要游戏设计师在数百次playtest中反复微调,AI模型能够生成「手感好」的游戏代码,说明其训练数据中可能包含了大量开源游戏项目的参数配置,但这种能力的泛化性和一致性仍有待验证——这类「感觉对」的参数往往来源于大量游戏开发经验的隐性知识,很难用精确规则来定义。Kimi 的输出是四者中最便宜的,加速时游戏体验尤为有趣。
场景构图与美术表现:Opus 5 的稳定优势
在只狼风格的主菜单测试中,模型需制作「插在草丛中的刀」的电影感画面。所谓电影感(Cinematic Look),通常包括多个专业的视觉构图要素:浅景深(通过调节虚拟摄像机的光圈参数实现前景清晰、背景模糊的效果)、黄金比例或三分法构图、体积光(Volumetric Lighting,光线穿过雾气或尘埃产生的可见光柱效果)、以及色彩分级(Color Grading,对高光和阴影施加不同色调以营造情绪氛围)。
从技术实现层面看,基于物理的渲染(Physically Based Rendering, PBR)是现代3D渲染的基础,它使用金属度(Metallic)、粗糙度(Roughness)等物理参数来描述材质,确保物体在不同光照条件下的表现符合真实世界的光学规律。体积光的实现需要光线步进算法(Ray Marching),在Blender中通过Principled Volume着色器节点实现,计算成本较高但视觉效果极为突出。景深效果在实时渲染中通常使用散景模糊后处理(Bokeh DOF),而在Cycles等光线追踪渲染器中则通过模拟真实镜头光学来实现更自然的虚化效果。色彩分级在电影工业中使用DaVinci Resolve等专业工具完成,而在3D渲染管线中通常通过合成器(Compositor)节点实现色调映射和颜色校正。在这个具体场景中,还需要处理金属材质的高光反射(金属的菲涅尔效应与非金属截然不同)、草地的次表面散射(Sub-Surface Scattering,光线穿透半透明材质产生柔和的内部发光效果),以及可能的粒子系统(如飘散的花瓣或萤火虫)来增强氛围感。AI模型需要在代码中正确配置所有这些参数才能产出具有电影感的画面。
Opus 5 花费了4小时50分钟。Grok 的输出相对最差——箭甚至没有插进地面,草地也显得过于平面,这表明其在物体交互和空间推理上存在明显缺陷。最佳输出集中在 Opus 5 和 GPT-5.6 之间,而 GPT 仅用了 Opus 一半的时间就达到相近水准。
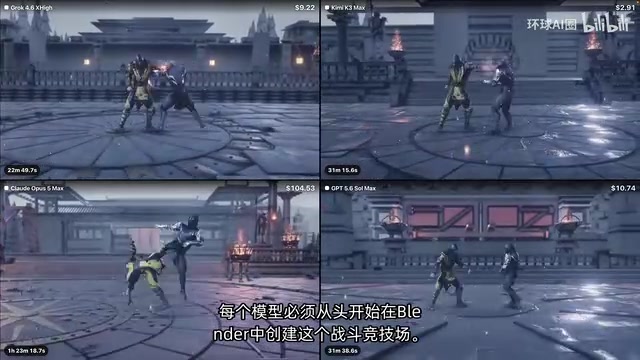
格斗游戏竞技场测试中,Grok 的表现令人印象深刻,且是最快完成生成的模型。Kimi K3 以三分之一的价格完成了同类任务。Opus 5 在地板和背景的打磨上投入了更多时间,但如果 Grok 投入同等时间,或许能达到相似效果且成本更低。
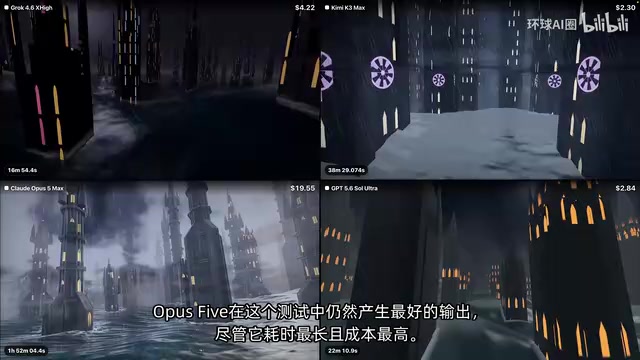
在哥特城市洪水、大教堂等复杂场景测试中,Opus 5 持续产出最优质的结果,尽管它往往耗时最长、成本最高。特别是大教堂测试中的 Grok 4.6——其输出更接近 Opus 5 而非 GPT-5.6,且成本与时间极低,仿佛是「Opus 5 在低努力模式下的产物」。
Grok的性价比与稳定性权衡
Grok 4.6 在测试中展现出鲜明的两面性。在太空飞行测试中,它凭借极高的价格效率和远超其他模型的生成速度脱颖而出;在前哨站立体模型测试中,其输出质量直逼 Opus 5,成本效益令人惊讶。
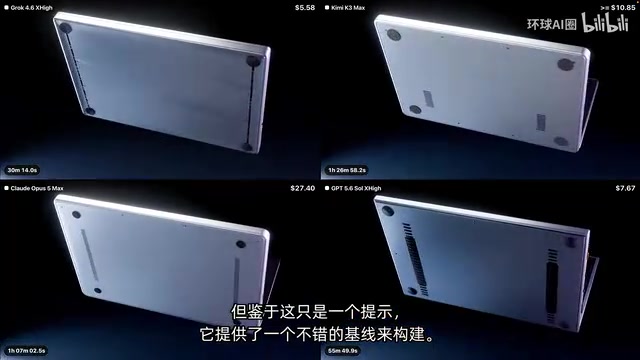
然而,速度快也伴随着稳定性的代价。在越野卡车测试中,Grok 4.6 直接失败,未能产生可玩的结果;在古庙测试中,它虽然最便宜最快,却没能完成寺庙和整体场景的构建,到处是残留的多余几何体。所谓「残留几何体」是程序化3D建模中的常见问题:当AI通过代码生成复杂场景时,可能产生未被删除的构造辅助网格(如用于布尔运算的切割体)、重叠面片导致的Z-fighting闪烁现象、未合并顶点产生的非流形几何体,以及法线方向错误导致的面片透明或内翻。
Z-fighting是两个共面或极其接近的多边形因深度缓冲区(Z-Buffer)精度不足而产生的视觉闪烁,这在游戏开发中是一个经典问题,解决方法通常是移除重复面或增加微小的深度偏移。非流形几何体指那些在物理世界中不可能存在的拓扑结构,如共享一条边的三个以上面片、孤立的边或顶点、以及法线方向不一致的相邻面——这类问题会导致物理模拟崩溃、渲染异常,以及3D打印时的切片错误。在专业工作流中,Blender的3D Print Toolbox、MeshLab或Unreal Engine的静态网格验证器等工具可以自动检测这些问题。
这些问题的根源在于模型生成的代码缺乏对3D拓扑完整性的系统性验证——一个经验丰富的3D艺术家会在建模过程中持续检查网格的「清洁度」,而AI生成的代码往往跳过了这类必要的后处理步骤。未来AI生成3D内容的一个关键改进方向,是在生成管线中嵌入自动拓扑验证和修复步骤,类似于代码生成中的语法检查和单元测试——在每个构造步骤后自动运行网格清洁脚本,检查非流形边、重叠面和法线一致性。这也从侧面说明了为何追求速度的模型更容易出现此类问题。相比之下,Opus 5 即便存在瑕疵,仍是最一致、最美观的输出。
在神社村庄测试中,Kimi K3 表现优于 Grok,产出了一个没有明显缺陷的场景,而 Opus 5 反而因过度设计、几何体杂乱显得不够美观。这说明「投入更多算力」并不总意味着更好的结果,简洁一致的设计有时更受青睐。这一现象在软件工程中有一个类比——过度工程化(Over-Engineering),即在解决方案中引入了超出实际需求的复杂性,反而损害了最终产出的质量和可维护性。
测试总结:场景化选择比追求最强更重要
综合13项测试,四款模型各有所长:
- Opus 5:质量标杆,在复杂场景和美术表现上最稳定,但代价是最高的时间与成本
- Grok 4.6:极致的速度与性价比,多数场景下能逼近 Opus 5,但稳定性存在明显短板
- Kimi K3:作为开源模型,在资产数量、成本控制上表现亮眼,多项测试中性价比最优
- GPT-5.6 Sol:在部分场景构图上出色,但在细节和整体一致性上时常落后
这场测试的价值不在于选出唯一赢家,而在于揭示当下AI在专业创作领域的真实边界:模型的选择应基于具体任务对质量、速度和成本的不同权衡。这种权衡在工程领域有一个经典框架——项目管理中的「铁三角」(Iron Triangle),即质量、速度和成本三者之间只能优化其二而必须在第三个维度上做出妥协。Opus 5选择了质量优先,Grok选择了速度优先,而Kimi K3则在成本控制上找到了自己的生态位。
对开发者而言,理解每款模型的特性,比追逐单一的「最强」更为实际。当前AI生成的3D内容仍面临拓扑质量不稳定、物理参数依赖经验值、复杂动画流程覆盖不全等挑战,但从Opus 5能独立完成角色绑定与动画、Grok能在极短时间内输出可用场景来看,AI辅助游戏开发正从概念验证走向实际生产力工具的临界点。在不远的将来,我们可能会看到这些模型被集成到游戏开发的自动化管线中:由AI完成初始资产的批量生成和场景搭建,再由人类艺术家进行精细打磨和品质把控——这种人机协作模式可能从根本上重塑独立游戏和中小型工作室的生产效率。
相关推荐
tiun.:为AI开发者打造的一站式认证与支付系统
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。
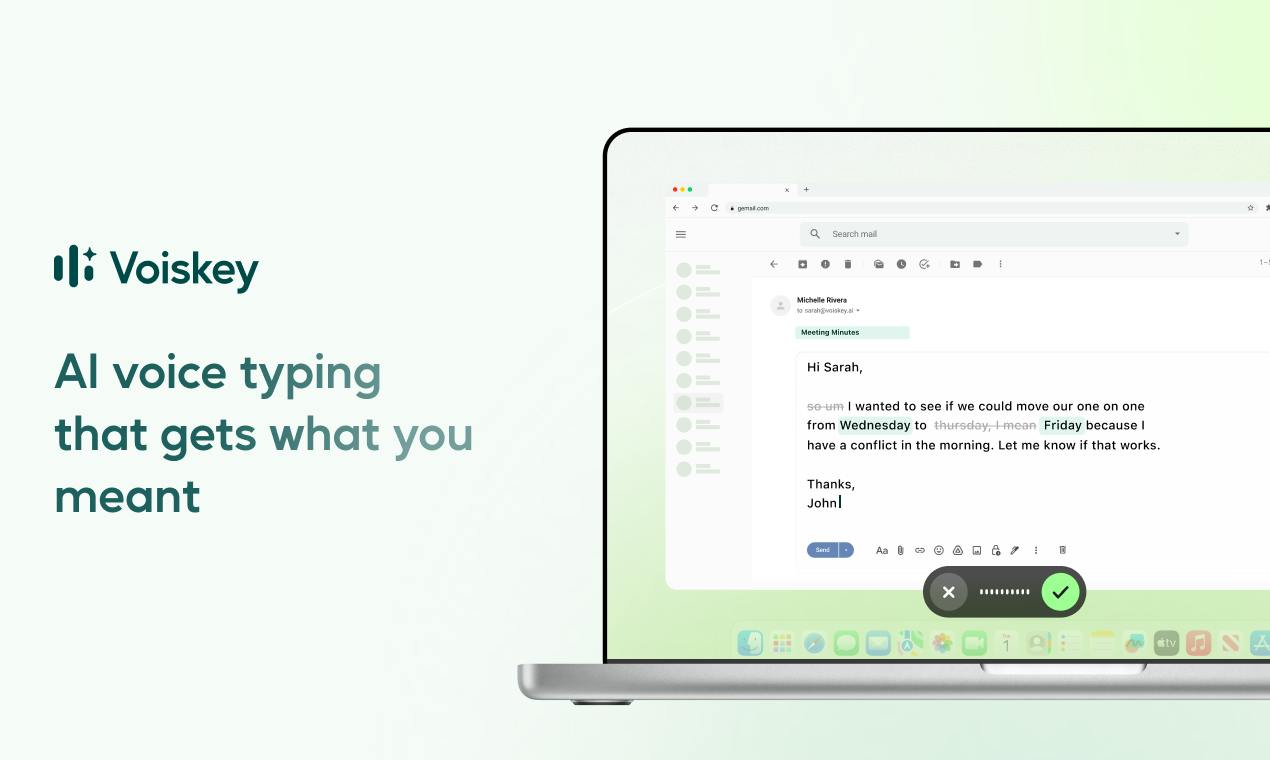
Voiskey:能读懂语境的AI语音输入工具
Voiskey是一款登上Product Hunt排名第3的AI语音输入工具,能根据场景和读者自动调整语气,比打字快5倍,支持iOS、macOS、Android、Windows四大平台及100多种语言。
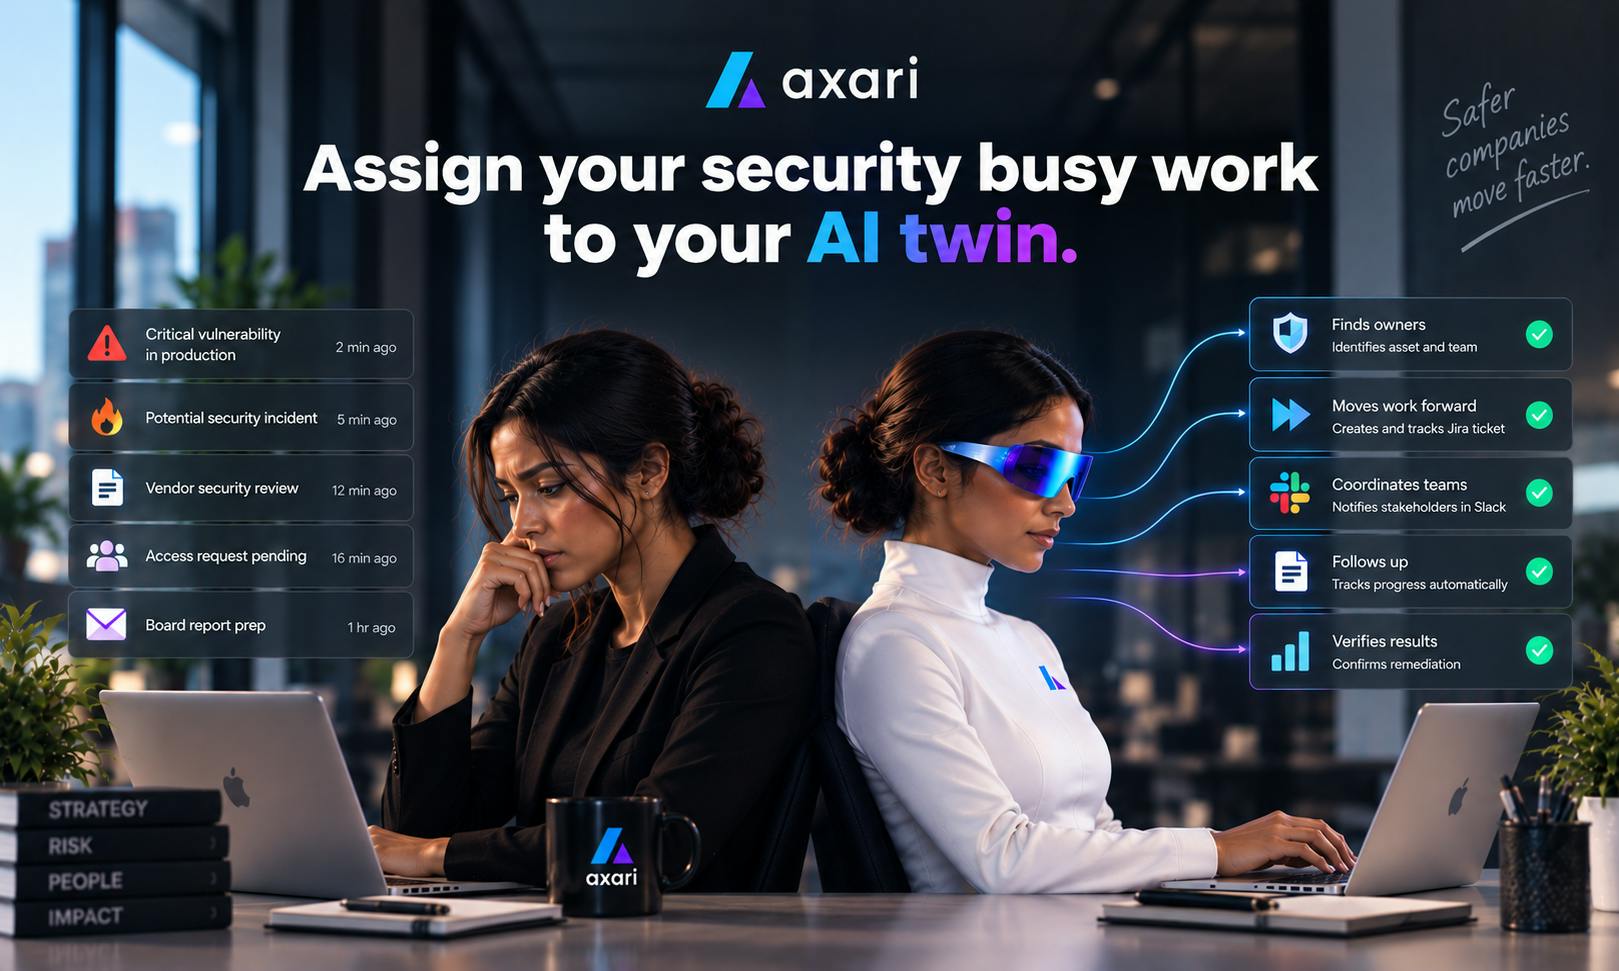
Axari:让AI分身接管你的安全运营琐事
Product Hunt新品Axari主打「AI分身」概念,帮安全团队自动处理重复性运营琐事,可在Slack、MS Teams中指派目标并自主推进任务。本文解析其产品逻辑、行业定位与需要冷静看待的问题。