似然温度调节如何拯救贝叶斯神经网络的"先验坍缩"
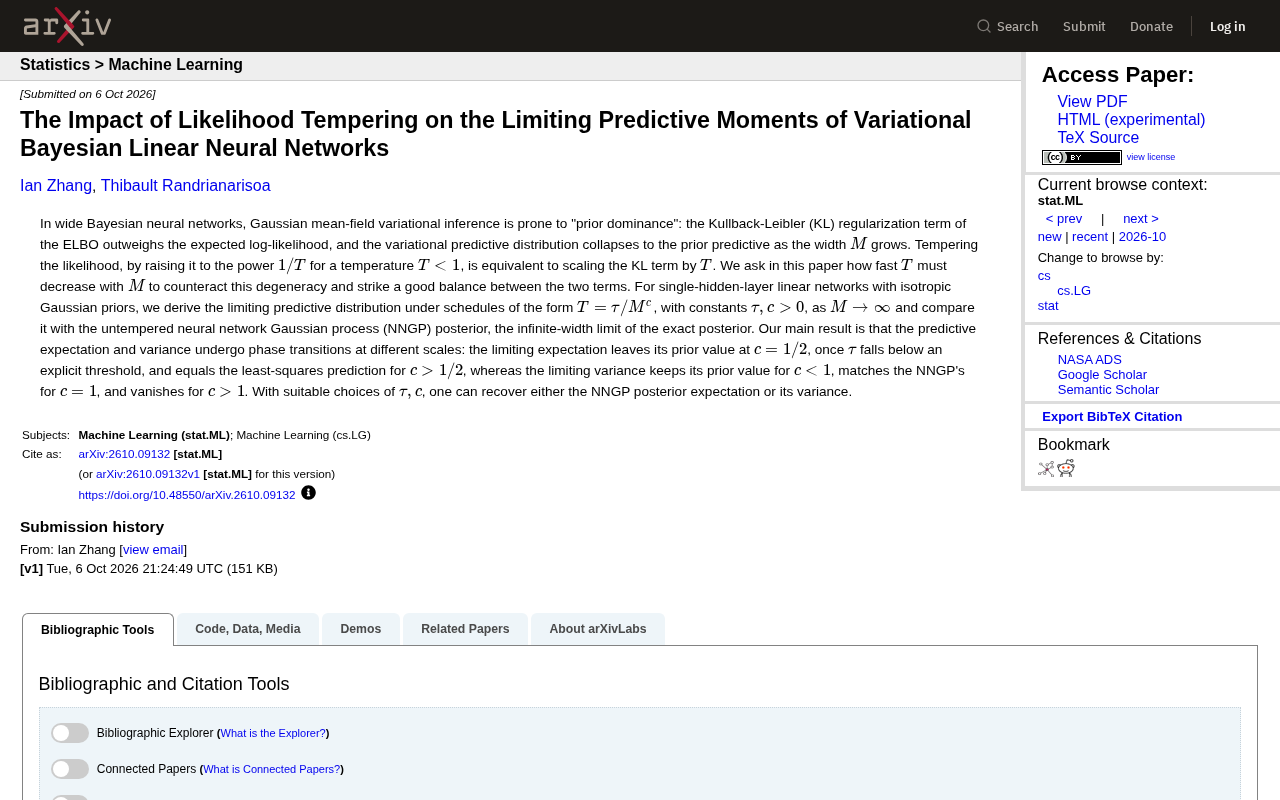
论文通过解析分析揭示,似然温度调节对贝叶斯神经网络预测期望和方差的修复发生在不同尺度,存在双重相变。
这篇论文针对宽贝叶斯神经网络中均值场变分推断的"先验主导"问题展开理论分析。随着网络宽度增大,ELBO中的KL散度项会压过期望对数似然项,导致变分预测退化为先验。论文提出用似然温度调节($T=\tau/M^c$)来重新平衡两项,并以单隐层线性网络为分析对象,推导出一个核心发现:预测期望在 $c=1/2$ 处发生相变(可恢复最小二乘预测),而预测方差要到 $c=1$ 才发生相变(匹配NNGP后验方差)。这一"错位双相变"揭示了温度调节对一阶矩和二阶矩影响的本质差异,说明期望准确性与不确定性量化质量无法被同一套温度参数同时最优化。
当宽度变大,变分推断为何会"失灵"
贝叶斯神经网络(Bayesian Neural Network)试图给深度学习模型的预测赋予可量化的不确定性,但在实际使用高斯均值场变分推断(Gaussian mean-field variational inference)时,存在一个长期被诟病的问题——先验主导(prior dominance)。
这篇 arXiv 新论文(arXiv:2610.09132v1)聚焦的正是这个现象。研究指出,在宽度 $M$ 不断增大的贝叶斯神经网络中,ELBO(证据下界)中的 KL 散度正则项会逐渐压过期望对数似然项。换句话说,模型越宽,训练数据对后验的影响越被稀释,变分预测分布最终会退化为先验预测分布,使得网络几乎学不到数据里的信息。
这是一个尴尬的处境:理论上更宽的网络应该有更强的表达能力,但在变分贝叶斯框架下,宽度反而成了拖累预测质量的因素。
均值场变分推断(Mean-Field VI) 是变分贝叶斯方法中最常用的近似推断策略:它假设后验分布可以分解为各参数相互独立的乘积形式,每个参数独立服从一个高斯分布(由均值和方差参数化)。这极大地降低了计算复杂度,但也牺牲了捕捉参数间相关性的能力。ELBO(Evidence Lower Bound,证据下界) 是变分推断的优化目标,其形式为 $\text{ELBO} = \mathbb{E}_q[\log p(\mathcal{D}|\theta)] - \text{KL}(q(\theta) | p(\theta))$,其中第一项鼓励模型拟合数据,第二项(KL 散度)则将近似后验 $q$ 拉向先验 $p$。当网络宽度 $M$ 增大时,参数数量随之线性增长,KL 项(对所有参数的 KL 散度之和)也线性增长,而期望对数似然项的增长速度相对较慢,导致正则化项在优化中占据主导,这正是先验主导现象的根本数学原因。
似然温度调节:用一个参数重新平衡两股力量
论文提出的核心工具是似然温度调节(likelihood tempering)。做法很直接:把似然函数提升到 $1/T$ 次方,其中温度 $T < 1$。
关键的数学等价关系在于——对似然做温度调节,等价于对 ELBO 中的 KL 项乘以系数 $T$。既然问题出在 KL 项过强,那么只要用一个小于 1 的 $T$ 去压低 KL 项的权重,就能让期望对数似然重新"说得上话"。
但真正的难点不在于"要不要调",而在于"调多快"。随着宽度 $M$ 增长,先验主导效应也在加剧,如果温度下降得太慢,依然压不住 KL;下降得太快,又可能过度削弱正则化。论文正是要回答:$T$ 必须以多快的速度随 $M$ 衰减,才能在两项之间取得恰当平衡。
相变现象:期望与方差在不同尺度上"跳变"
为了得到可解析的结论,作者将研究对象限定在单隐层线性网络,并采用各向同性高斯先验。他们考察形如 $T = \tau/M^{c}$ 的温度调度策略($\tau, c > 0$ 为常数),推导出当 $M \to \infty$ 时的极限预测分布,并与未经温度调节的 NNGP(神经网络高斯过程)后验做对比——后者正是精确后验在无限宽极限下的形式。
论文最有意思的发现是:预测的期望和方差会在不同的尺度上发生"相变"(phase transition),二者并不同步。
预测期望的相变点
对于极限预测期望:
- 当 $c = 1/2$ 且 $\tau$ 低于某个明确阈值时,期望开始偏离先验值;
- 当 $c > 1/2$ 时,极限期望恰好等于最小二乘预测。
也就是说,期望值在 $c = 1/2$ 这个尺度上发生转变,温度衰减足够快时,模型就能恢复出数据驱动的最优线性预测。
预测方差的相变点
方差的转变发生在不同的位置:
- 当 $c < 1$ 时,方差保持先验值;
- 当 $c = 1$ 时,方差恰好匹配 NNGP 后验的方差;
- 当 $c > 1$ 时,方差趋于消失。
期望在 $c = 1/2$ 转变,方差却在 $c = 1$ 才转变——这种错位的双重相变是本文的核心贡献,它揭示了温度调节对预测分布一阶矩和二阶矩影响的本质差异。
NNGP(神经网络高斯过程)后验 是本文用作比较基准的"理想目标"。当神经网络宽度趋于无穷时,在特定初始化条件下,网络的函数空间分布收敛到一个高斯过程,其核函数(kernel)由网络架构和激活函数决定。对于有限数据集,NNGP 的精确贝叶斯后验同样是高斯过程,具有解析可计算的均值和协方差,代表了在无限宽极限下"完美的"贝叶斯推断结果。论文以 NNGP 后验的期望和方差作为衡量变分近似质量的标尺:变分预测分布越接近 NNGP 后验,说明温度调节越成功地将均值场近似从先验主导中"解救"出来,逼近了真正的贝叶斯推断。
实践含义:你想恢复哪一个,就调哪一个
这组结论带来一个颇具操作性的推论:通过适当选择 $\tau$ 和 $c$,可以有选择地恢复 NNGP 后验的期望,或者恢复它的方差。
这对实践者是一个清醒的提醒——温度调节并不是一个"万能开关",它无法同时、无代价地把均值场变分预测拉回到精确后验的全部统计特性。若你更关心点预测的准确性(期望),需要的调度与你更关心不确定性量化(方差)时的调度并不相同。想两者兼得,就必须在参数空间里精细地权衡。
从方法论上看,这篇论文的价值在于把一个经验性的"调温度能缓解先验坍缩"的直觉,提升为可解析、带明确阈值和尺度的理论刻画。虽然分析对象是最简化的单隐层线性网络,但它为理解更一般的变分贝叶斯深度学习中的退化现象提供了一个干净的数学参照系。
局限与展望
需要如实说明的是,论文的结论建立在相当理想化的假设之上:单隐层、线性激活、各向同性高斯先验。真实的深度非线性网络是否仍遵循同样的双相变规律,仍是开放问题。但正如许多无限宽网络理论(如 NTK、NNGP)所展示的那样,线性与无限宽的可解模型往往能揭示出在更复杂模型中依然成立的定性规律。
对于关注贝叶斯深度学习不确定性量化的研究者而言,这篇工作至少提供了一个明确的信息:温度不是随便调的,它的衰减尺度决定了你最终得到的是先验、是最小二乘,还是真正的后验近似。
NTK(Neural Tangent Kernel,神经切线核) 是另一个重要的无限宽网络理论框架:当网络宽度趋于无穷且学习率趋于零时,梯度下降训练过程可以用一个固定的核函数(NTK)精确描述,网络训练等价于核回归。NTK 与 NNGP 共同构成了理解无限宽神经网络行为的两大理论支柱,前者刻画训练动态,后者刻画贝叶斯推断。尽管这些理论在实践中面临"宽度有限""非线性激活""实际训练与理论假设不符"等挑战,但它们在定性规律上往往与有限宽网络的实验观察高度吻合,因此被广泛用作分析工具。本文对线性单隐层网络的分析也遵循这一传统,期望从可解析的极端情形中提炼出对更复杂模型具有指导意义的洞见。
相关推荐
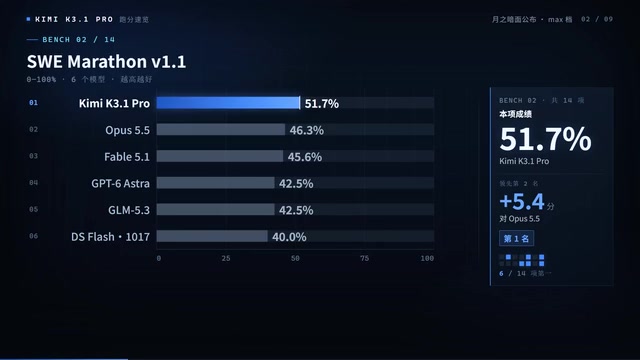
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。