斯坦福CS336:从零构建大模型的硬核哲学

斯坦福CS336课程主张从零构建小语言模型,以掌握机制、思维模式与效率视角。
斯坦福CS336课程已进入第三版,核心哲学是从零构建语言模型。课程团队认为,AI研究者正与底层技术脱节,而抽象会泄漏,缺乏底层知识将限制研究设计空间。课程将知识分为机制、思维模式和直觉三类,前两者可跨规模迁移,直觉则需大规模实验获得。课程以效率为统一框架,分五部分对应五次高强度作业:基础(分词、架构、训练)、系统(最小化数据移动、多GPU并行)、扩展定律(设计扩展配方、超参数迁移)、数据(过滤、去重、混合)和对齐(弱监督、RL)。课程还引入AI教学助手政策,并强调可预测性与最优性同等重要。
在AI编程助手能零样本生成语言模型的今天,为什么还要亲手从零构建大模型?斯坦福CS336课程给出了答案:抽象会泄漏,真正的理解源于构建。这门由Percy Liang、Tatsu Hashimoto等教授主讲的课程已进入第三版,其核心哲学——从零开始——始终未变。
为什么从零构建依然重要?
课程团队观察到,AI研究者正与底层技术脱节。十年前,研究者亲自实现和训练模型;八年前,大家还会下载BERT进行微调;如今,仅靠提示模型就能完成许多任务。然而,抽象是有泄漏的。当你受限于模型能力而无法实现特定功能时,没有底层知识就无计可施。
“如果你对基础研究真正感兴趣,仅靠提示模型会极大限制你探索的设计空间。”——Percy Liang
前沿模型的工业化使得从零训练GPT-4级别模型成为天方夜谭。据课程提及,GPT-4的训练成本据称高达1亿美元,而如今前沿模型的成本可能在10亿美元量级。大实验室的GPU数量巨大,且构建细节秘而不宣。GPT-4论文明确表示,出于竞争和安全考虑,不会分享任何构建细节。
因此,课程选择构建小语言模型,但强调小模型可能无法代表前沿模型的行为。例如,在较小规模下,MLP层的计算占比约为44%,而扩展到175B参数时则升至80%。优化重点会随规模变化。此外,涌现能力也只在临界规模才突然出现。
可迁移的三类知识
课程将知识分为三类:
- 机制(Mechanics):Transformer是什么、模型并行如何工作。这部分教学效果最好。
- 思维模式(Mindset):如何榨取硬件最大性能、严肃对待扩展定律。这部分同样可迁移。
- 直觉(Intuitions):哪些建模和数据决策能带来好性能。这部分跨规模迁移性最差,必须通过大规模实验获得。
课程强调,效率至关重要。模型准确率可视为效率与资源的乘积。在小规模实验中,运行时间翻倍或许只是多等一会儿;但在大规模下,成本可达数亿美元,5%的效率提升都意义重大。OpenAI在2020年的论文曾展示,图像质量方面算法效率在2012至2019年间提升了44倍,硬件进步与算法改进相乘,带来了效率与准确率的巨大跃升。
课程结构与核心主题
CS336分为五部分,对应五次高强度的作业。课程资料全部公开,讲座视频也将发布在YouTube上,方便自学者跟进。
基础:从分词到训练
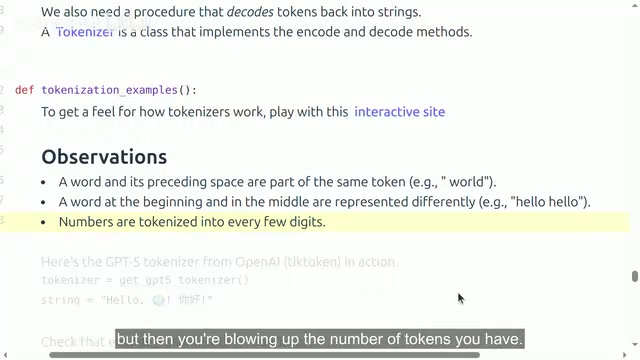
第一周目标是训练一个语言模型。课程从分词器讲起,深入剖析BPE(字节对编码)算法。BPE通过迭代合并最频繁的相邻字节对来构建词表,使常见序列成为单个token,罕见序列拆分为多个token,避免了未知词(UNK)问题。
在模型架构方面,课程涵盖激活函数、位置编码、归一化层的演进,以及减少二次Attention计算的各种方法,包括状态空间模型(如Mamba)和门控Delta网络等混合架构。混合专家(MoE)已成为构建计算高效Transformer的主流范式,课程将专门讨论其训练技术。
训练环节涉及损失函数(从下一token预测到多token预测)、优化器(从Adam到Muon)、初始化、学习率调度等。课程强调,这些看似平凡的超参数,在规模化语境下, principled地设置它们是区分训练崩溃与达到SOTA的关键。
作业一要求学生实现BPE分词器、Transformer、损失函数和优化器,并进行资源核算,理解FLOPs的去向。
BPE(字节对编码) 是一种数据驱动的子词分词算法,最初用于数据压缩,后被引入神经机器翻译和语言模型。其核心思想是:从字符级或字节级词表出发,反复统计语料中相邻符号对的频率,将最高频的符号对合并为新符号,直至词表达到预设大小。这一过程使高频词或词根成为单个token,罕见词则被拆分为多个子词token,从而在词表大小可控的前提下消除未登录词(UNK)问题。对于多语言或代码等开放词表场景,BPE的字节级变体(BBPE)能覆盖任意Unicode字符,成为GPT系列等模型的标准分词方案。
混合专家(MoE) 是一种稀疏激活架构:将Transformer中的前馈网络(FFN)层替换为多个并行的“专家”子网络,并通过一个可学习的路由器为每个token选择性地激活少数专家(如Top-2)。这样模型总参数量可以极大,但每个token的实际计算量仅与激活的专家数成正比,从而在推理成本近似不变的情况下扩展模型容量。MoE的挑战在于负载均衡(防止专家坍缩)、训练稳定性以及专家并行带来的通信开销,这些正是课程系统部分会深入讨论的内容。
系统:榨干硬件性能
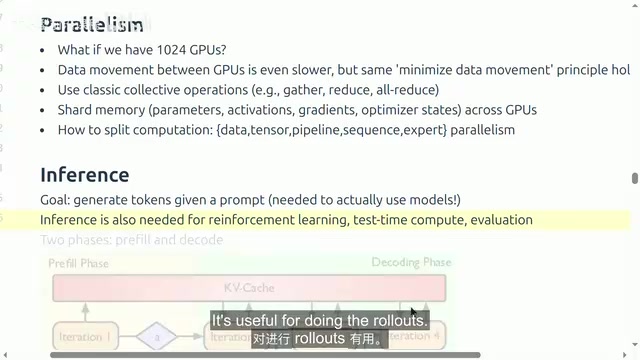
作业二聚焦系统优化。核心原则是最小化数据移动。课程以B200为例:2.25 PFLOPS的BF16算力,8 TB/s的内存带宽。计算单元与内存分离,数据搬运往往是瓶颈。操作融合(operator fusion)和分块(tiling)是减少数据移动的关键技术。
多GPU训练则需理解集合通信操作(gather、reduce、all-reduce),以及参数、激活、梯度和优化器状态的分片策略(数据并行、模型并行、流水线并行、序列并行、专家并行)。推理部分讨论预填充(prefill)与解码(decode)两阶段,以及量化、蒸馏、推测解码等加速技术。
作业二涉及用Triton编写kernel和并行训练。
操作融合(operator fusion) 指将多个细粒度的计算操作合并为一个kernel执行,以避免中间结果在GPU高带宽内存(HBM)与片上缓存之间反复搬运。例如,将LayerNorm的均值、方差计算与后续的缩放平移融合,或将Attention中的softmax与矩阵乘法融合,可显著减少内存读写次数。由于现代GPU的算力增速远超内存带宽增速(即“内存墙”),数据移动往往比计算本身更昂贵,融合因此成为提升实际吞吐的关键手段。
分块(tiling) 是另一种减少数据移动的技术:将大矩阵运算切分为能装入片上共享内存(SRAM)的小块,逐块加载并计算,使数据在被逐出前被尽可能多地复用。FlashAttention正是通过分块与重计算策略,将Attention的内存复杂度从O(n²)降至O(n),同时大幅减少HBM访问。这些技术与Triton等kernel编程语言结合,是作业二中学生亲手实现高性能算子的基础。
扩展定律:预测大规模表现
作业三直面大规模训练的核心难题:给定1E25 FLOPs(数千万美元),该训练什么模型?关键思维转变是:不要只想着训练单个模型,而要设计扩展配方(scaling recipe)——一个从FLOPs预算到超参数配置的映射。通过小规模实验拟合扩展定律,预测目标规模的损失。
“可预测性至少与最优性同等重要。”
课程强调,扩展定律不是自然规律,而是通过精心构建扩展配方“愿力”出来的。超参数迁移(hyperparameter transfer)至关重要:如果学习率在不同规模间跳跃不定,就无法可靠预测。经典的Chinchilla扩展定律指出,对于每个FLOPs预算,扫描不同模型大小并选择最优,拟合出参数量与预算的关系。经验法则:训练token数约为参数量的20倍。但推理成本会改变这一计算,许多模型选择更小规模但训练更多token。
课程团队在Marin项目中实践了预注册(preregistration)结果:先拟合扩展定律预测大规模损失,再实际训练验证。
作业三提供一个训练API,模拟小规模实验,学生需拟合扩展定律并预测给定预算下的模型表现,模拟高风险决策场景。
超参数迁移(hyperparameter transfer) 指让超参数(尤其是学习率、初始化尺度)随模型规模按特定规律缩放,使得在小模型上调优得到的配置可以直接迁移到大模型而不需重新搜索。其理论基础是“μP(最大更新参数化)”等工作:通过调整参数化方式,使最优学习率在宽度扩展时保持稳定,从而支持从小规模代理模型向大规模目标的零样本或少量样本迁移。若缺乏这种可迁移性,小规模实验拟合出的扩展定律将无法可靠外推到目标规模,扩展配方的预测能力也就无从谈起。
数据:模型能力的定义者
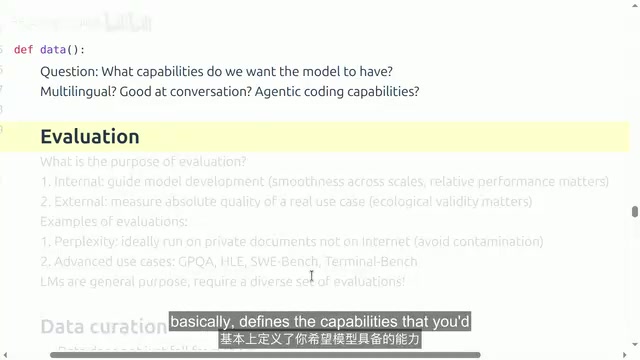
作业四处理数据。数据质量决定了模型能力。课程区分内部评估(如困惑度,利于模型开发,要求跨规模平滑)和外部评估(生态效度,面向用户和审稿人)。数据来源多样(网页、书籍、代码、论文),涉及版权和许可的法律问题。数据处理包括转换、过滤、去重、混合及合成数据生成。预训练、中期训练(高质量数据、长上下文)和后训练数据各有用途。
作业四要求学生从原始网页爬取数据开始,完成过滤、去重和清洗的全流程——课程承认这是“脏活”,但从零构建的完整体验不可或缺。
对齐:弱监督的力量
作业五聚焦对齐。在完成下一token预测的充分监督训练后,模型已具备基本能力,但可通过弱监督进一步提升——批评往往比生成更容易。基本模板是:从模型生成回复,由人类、验证器或AI评判打分,然后更新模型偏好更优回复。可通过PPO、GRPO等RL算法或更简单的DPO实现。
RL的挑战在于不稳定和难调参,大规模RL还面临系统挑战:推理服务器与训练服务器需协同,rollout生成、代码执行环境、离策略问题交织。作业五的具体内容尚在确定中,去年是实现DPO和GRPO并在数学基准上跑通。
贯穿始终的效率视角
课程以效率为统一框架。分词提升计算效率;架构改进微调内存和FLOPs;数据过滤避免在冗余坏数据上浪费梯度更新;扩展定律则是用小模型高效调参。即使未来进入数据受限时代,效率思维依然适用。
课程还采用“可执行讲义”(executable lecture)形式,讲义本身是Python程序,可单步执行代码,直观展示分层结构。
教学创新与AI政策
课程今年引入了AI教学助手政策:提供一个带有教学法倾向的prompt(agents.md),学生使用AI时必须遵循。该prompt会回答代码问题、澄清概念,但不会在学生需要实现Transformer时直接生成代码。这是首次尝试,课程团队期待反馈。
五次作业强度极高。据课程评价,仅第一次作业就相当于CS224N五次作业的总和。课程明确列出不适合选课的情况:想在本季度出科研成果、只想学最新热门技术(课程不深入涉及多模态和Agent)、或想快速在应用领域取得结果。对于后者,课程建议先尝试提示和微调,最后才考虑预训练。
结语
CS336的价值不在于追赶最新技术热点,而在于建立对语言模型全栈的深层理解。从分词、架构、训练、系统到数据和对齐,这门课用高强度的实践锻造研究者的工程肌肉和底层直觉。在AI能力日益强大的今天,这种从零构建的“硬核”训练,恰恰是保持技术自主性和创新深度的关键。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。