思维链真的在推理吗?因果测量揭示CoT忠实度真相

新研究用激活干预发现CoT推理约77%步骤确实因果承重,但行为学测试会系统高估忠实度达11-20个百分点
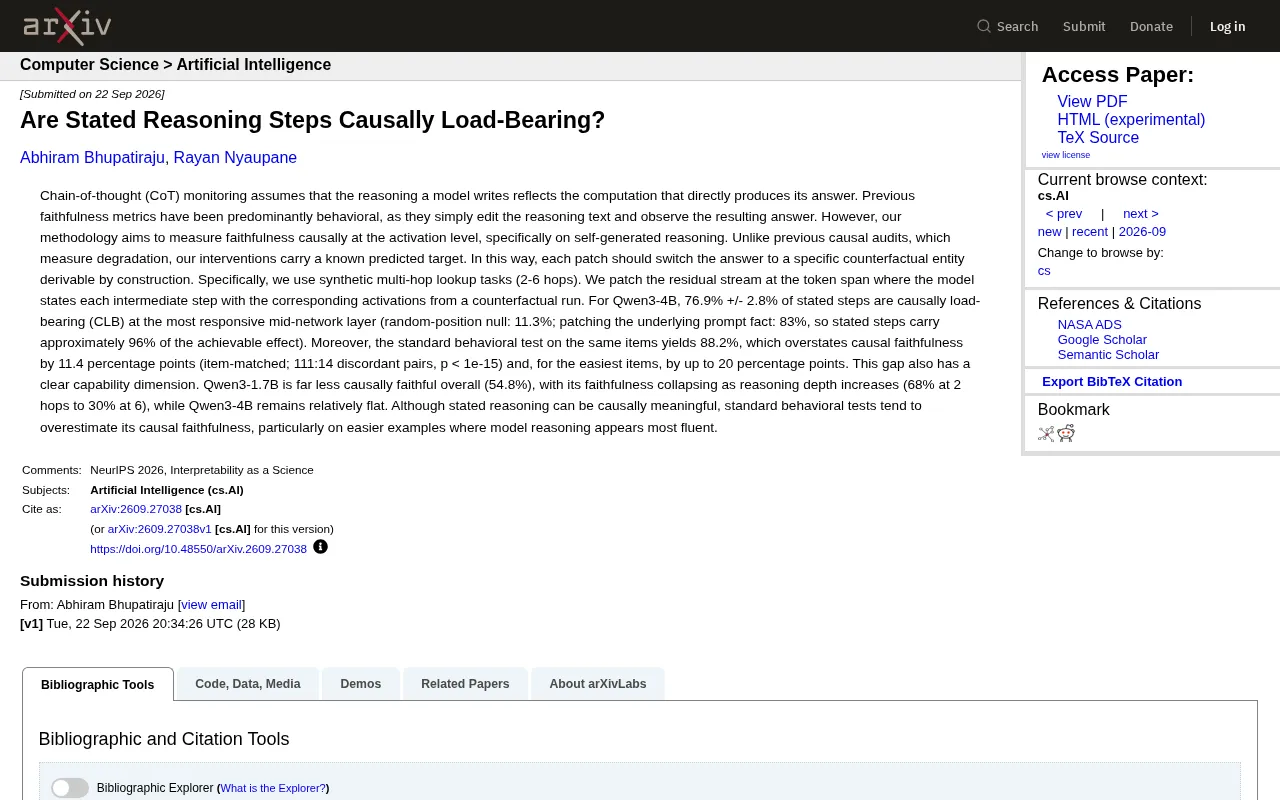
这篇arXiv论文(arXiv:2609.27038)首次在激活层面对大语言模型的思维链忠实度进行了严格的因果测量。研究放弃了传统"编辑文本、观察答案"的行为学方法,转而直接对模型推理token的残差流进行激活修补,并以明确的反事实目标实体作为预测基准。在合成多跳查找任务上,Qwen3-4B有76.9%的陈述推理步骤被证实真正"因果承重",承载了约96%的可实现因果效应,说明CoT并非纯粹的事后合理化。然而,同样的题目在标准行为学测试下忠实度测量值高达88.2%,高出近12个百分点,简单题目上差距更达20个百分点。更小的Qwen3-1.7B整体忠实度仅54.8%,且随推理深度增加急剧下滑。这些发现意味着:依赖行为学CoT监控来做AI安全审查时,在模型推理最流畅的场景下反而最容易产生虚假的安全感。
思维链监控的核心假设正在被质疑
大语言模型的思维链(Chain-of-Thought, CoT)能力常被视为模型可解释性与安全监控的关键抓手。其背后有一个默认假设:模型写出来的推理步骤,真实反映了它内部产生答案的计算过程。换句话说,如果模型说"因为A导致B,所以答案是C",我们默认这段文字就是它得出C的实际依据。
但这个假设站得住脚吗?一篇新发布的arXiv论文(arXiv:2609.27038)对这一问题给出了迄今为止较为严格的因果层面回答。研究的核心结论是:模型陈述的推理步骤确实在相当程度上是"因果承重"的,但传统的行为学测试会系统性地高估这种忠实度,尤其是在那些看起来推理最流畅的简单任务上。
从"行为观察"到"激活干预"的方法升级
过去衡量CoT忠实度(faithfulness)的方法大多是行为学的:研究者编辑模型写出的推理文本,然后观察最终答案是否改变。如果改动某个推理步骤后答案随之变化,就认为这一步是"有用的"。这种方法直观,但只能看到输入输出的关联,无法确认因果关系。
这篇论文的关键创新在于把测量下沉到激活层面(activation level),直接对模型自己生成的推理进行因果审计。具体做法是:在模型陈述某个中间推理步骤的token区间上,将其残差流(residual stream)替换成来自"反事实运行"的对应激活值。
与以往测量"性能退化"的因果审计不同,这里的每次干预都带有一个已知的预测目标——每一次patch理论上都应该把答案切换到一个可以通过构造推导出来的特定反事实实体。这让实验有了明确的对照基准,而不是模糊地观察"变差了多少"。
合成多跳查找任务
为了让因果链条清晰可控,研究采用了合成的多跳查找任务(multi-hop lookup),跳数从2跳到6跳不等。多跳任务的好处在于推理路径明确、中间实体可枚举,便于精确设定反事实目标并验证干预效果。
残差流(residual stream)是Transformer架构中的核心信息传递机制。在标准Transformer中,每一层的注意力头和前馈网络并不直接覆写表示,而是将自身的输出加到一条贯穿全网络的主干向量上——这条主干就是残差流。由于每层的修改都以加法形式叠加,残差流在任意位置的状态理论上包含了此前所有层写入的信息。激活修补(activation patching)正是利用这一结构:研究者在某个特定token位置、特定层,将当前运行的残差流向量替换成来自另一次"反事实"前向传播的对应向量,从而定向地注入不同的信息内容,同时保持其他位置和层的激活不变。这种手术式干预使研究者能够以近乎受控实验的方式追问:模型在生成答案时,究竟有多少计算依赖于某段陈述推理,而非其他来源。
多跳查找任务(multi-hop lookup)的典型形式是一系列链式的键值对查询,例如:已知"实体A的属性是B"、"实体B的属性是C"……以此类推,要求模型从初始实体出发,逐步跳转直至找到第N跳的目标实体。这类任务之所以适合因果审计,原因是推理路径完全透明——每一个中间实体都是可枚举的"地面真值",研究者能够精确构造反事实:只需将某一跳的事实替换为指向不同实体的版本,就能推算出如果模型真正使用了那一步,最终答案应当变成什么。相比之下,自然语言推理任务的中间步骤语义模糊、反事实目标难以精确指定,容易引入测量噪声。使用2到6跳的梯度设计还有一个额外优势:随跳数增加,推理链变长,可以系统考察模型在不同认知负荷下维持忠实度的能力。
Qwen3-4B:约77%的步骤真正"承重"
在Qwen3-4B模型上,研究发现在网络中层最敏感的那一层,76.9%(±2.8%)的陈述步骤是因果承重的(Causally Load-Bearing, CLB)。
这个数字需要几个参照系才能理解其分量:
- 随机位置的null基线只有11.3%——说明干预效果并非随机噪声。
- 直接patch底层提示事实能达到83%的效果上限。
也就是说,模型陈述的推理步骤承载了约96%(76.9%相对于83%)的可实现因果效应。这是一个相当高的比例,说明对于这个规模的模型,写出来的推理并非纯粹的"事后合理化",而是确实参与了答案的生成。
行为学测试高估了忠实度
真正引人深思的是行为学测试与因果测试的差距。在完全相同的题目上,标准行为学测试给出的忠实度是88.2%,比因果测量的76.9%高出11.4个百分点。
这个差距在统计上极为显著(item-matched配对,111:14的不一致配对,p < 1e-15)。更值得警惕的是,在最简单的题目上,这种高估幅度最高可达20个百分点。
这意味着:当模型的推理看起来最流畅、最"言之凿凿"的时候,恰恰是行为学测试最容易被误导的时候。表面的连贯性掩盖了内部计算与陈述文本之间的错位。对于依赖CoT监控来做AI安全审查的场景,这是一个不容忽视的盲点。
这里的"高估机制"值得进一步解释。行为学测试在编辑推理文本后重新输入模型,本质上改变的是整个上下文,而非仅仅替换内部激活。当推理步骤被篡改后,即便模型"看起来"答案随之改变,这种变化可能来自多种混杂因素:编辑引入了语法或语义异常,触发了模型对"奇怪输入"的鲁棒性应对;或者修改后的文本恰好在surface pattern层面与某类训练样本对应,从而直接激活了不同的答案模式。在简单任务上,这种混杂效应尤为突出——答案本身往往有较高的先验概率,行为层面的扰动容易被过度解读为"因果响应",而激活干预绕过了这些surface-level混淆,直接测试内部表示是否参与了计算,因此给出更保守、更准确的估计。
忠实度与模型能力强相关
研究还揭示了忠实度的能力维度。更小的Qwen3-1.7B整体因果忠实度只有54.8%,远低于4B版本。
更关键的是随推理深度的衰减模式:
- Qwen3-1.7B在2跳任务上忠实度为68%,但到6跳时暴跌至30%。
- Qwen3-4B则在不同跳数下保持相对平稳。
换句话说,能力较弱的模型在面对更长的推理链时,其陈述步骤会越来越"名不副实"——它可能在纸面上写满了推理,但实际计算已经与文字脱节。这提示CoT忠实度不是一个固定属性,而是随模型规模和任务复杂度动态变化的。
对AI可解释性与安全的启示
这项研究的价值不在于否定CoT,而在于校准我们对它的信任程度。几个实践层面的启示值得关注:
第一,行为学测试需要谨慎解读。 仅靠编辑文本、观察答案变化,会系统性地高估推理的真实因果作用,尤其在简单任务上。激活层面的因果干预提供了更可靠的标尺。
第二,模型规模影响可信度。 小模型的推理链在深度增加时更容易"失真",对小模型的CoT监控应保持更高警惕。
第三,流畅不等于忠实。 推理越顺畅,越可能让人误以为它反映了真实计算。这对基于CoT的自动化安全审查构成挑战——最需要监控的不确定情形,可能恰恰是文字表述最从容的时候。
随着思维链推理成为前沿模型的标配能力,如何验证"模型说的"与"模型做的"是否一致,将是可解释性研究的长期课题。这篇论文提供了一套可复现的因果测量框架,为后续工作打下了方法学基础。
相关推荐
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。