SJR架构:解耦内容理解与策略学习的多模态内容审核新范式

SJR架构用自然语言解耦多模态理解与策略判断,实现零违规样本冷启动新审核策略。
SJR(Summarize-Judge-Refine)是一种面向内容审核的新型架构,核心思路是将"看懂内容"与"判断违规"拆分为两个独立模型,并以自然语言摘要作为接口。内容模型负责将图片、视频转化为结构化文本描述,策略模型则仅在文本层面完成违规判定。这一解耦设计使策略变更时无需重训昂贵的多模态管线,同时也让原本无法用于多媒体数据的文本增强手段变得可行。通过GRPO协同训练和对抗性摘要生成,SJR在误导广告检测任务上相对零样本CoT基线取得23.6%的非误导F1提升,并在零真实违规样本条件下将违规检测性能损失控制在0.2%以内,为内容安全领域的快速策略迭代提供了一条可行路径。
内容审核系统长期面临一个结构性难题:多模态理解与策略分类深度耦合。每当审核策略调整,整个模型管线就需要重新训练;而多媒体数据难以有效增强,标签稀缺问题始终无解。一篇新的arXiv论文提出的Summarize-Judge-Refine(SJR,即"总结-判断-精炼")架构,试图从根本上重构这一流程。
为什么传统内容审核难以扩展
传统的内容审核模型往往把"看懂内容"和"判断是否违规"这两件事塞进同一个端到端网络。这种设计带来两个致命问题。
第一是策略变更的高昂成本。平台的审核政策是动态的——今天禁止某类误导性宣传,明天可能新增对某种表达形式的限制。在耦合架构下,任何策略调整都意味着对整个多模态管线的重新训练,工程与算力开销巨大。
第二是标签稀缺。文本数据可以通过同义替换、回译等方式做数据增强,但图片、视频这类多媒体内容无法被"有意义地增强"——你不能随意改动一张广告图而保证它仍然代表同一类违规。这导致违规样本天然稀少,模型冷启动困难。
SJR的核心思路:用自然语言做接口
SJR的关键创新在于把内容理解与策略判断解耦成两个独立模型,并用自然语言作为二者之间的接口。
具体来说,架构包含两部分:
- 内容模型(Content Model):一个多模态模型,负责把图片、视频等原始内容转换成结构化的文本摘要。它只关心"这里面有什么",不关心"这是否违规"。
- 策略模型(Policy Model):一个纯文本模型,负责拿着内容模型生成的摘要,对照具体的策略定义进行分类判断。
这种分工的好处很直接:当策略变化时,只需调整或替换纯文本的策略模型,而无需触动昂贵的多模态内容模型。理解层与决策层被彻底隔离开。
协同训练与文本空间数据增强
SJR并非简单地把两个模型拼在一起,而是设计了一个迭代式的协同训练循环(co-training loop)。
系统通过GRPO(Group Relative Policy Optimization)来精炼内容模型,使其生成的摘要更贴合策略判断的需要——也就是产出"策略相关"的摘要,而非泛泛的描述。这一步确保了摘要不会遗漏对违规判定至关重要的细节。
更巧妙的是文本空间的数据增强。既然内容已经被转换成了文本摘要,那么原本在原始多媒体上不可行的增强手段,此刻变得可行。SJR通过生成对抗性的摘要变体,构造出大量训练样本,从而实现少样本(few-shot)策略冷启动。这是原始多媒体数据完全无法提供的增强路径。
GRPO(Group Relative Policy Optimization)是一种基于强化学习的语言模型优化方法,属于RLHF(人类反馈强化学习)的变体。与传统的PPO(Proximal Policy Optimization)不同,GRPO通过对同一输入生成一组候选输出,以组内相对奖励而非绝对奖励信号来更新模型,从而降低了对独立价值网络(critic)的依赖,训练更加稳定。在SJR中,GRPO被用来根据策略模型的判断结果反向优化内容模型的摘要生成行为——如果某次摘要生成导致策略模型做出了错误分类,该摘要就会获得较低的相对奖励,促使内容模型在下一轮学习时生成更聚焦于策略相关细节的描述。这种协同训练的方式使两个解耦模型形成了有效的端到端反馈回路,而无需合并为单一的多模态模型。
实验结果:零违规样本也能启动新策略
在误导性广告检测任务上,SJR的表现相当亮眼。
相比零样本思维链(zero-shot chain-of-thought)基线,SJR在"非误导"类别的F1分数上取得了23.6%的相对提升,并且全面超越了端到端SFT、STaR/RFT以及RLFT等多种训练方法。
最值得关注的一个发现是:论文测试了一个特殊变体——训练时不使用任何真实的违规样本,所有正类数据全部由合成生成。结果这个变体在违规类F1上,与使用全量真实数据的模型差距仅在0.2%相对值以内。
这一结果的意义在于,它证明了新策略可以在完全没有真实违规数据的情况下上线。对于需要快速响应新型违规内容、却又缺乏历史标注数据的平台而言,这几乎是一个理想的冷启动方案。
SFT(Supervised Fine-Tuning,监督微调)、STaR/RFT(Self-Taught Reasoner / Reinforced Fine-Tuning)和RLFT(Reinforcement Learning Fine-Tuning)是论文对比的三类基线训练范式。SFT是最基础的方式,直接在标注样本上最大化正确标签的似然;STaR/RFT引入了"先生成推理链再自我监督"的思路,通过筛选模型自身生成的正确推理路径作为额外训练数据;RLFT则将强化学习信号直接用于微调整个模型的输出分布。这三种方法都作用于端到端或紧耦合的管线,策略变更仍然牵一发而动全身。SJR在这一对比体系下取得全面领先,说明解耦架构本身带来的收益已经超出了单纯优化算法层面的差异。
可解释性作为结构性副产品
SJR还带来一个额外优势:每一个审核决策都建立在人类可读的文本摘要之上。
在许多端到端的黑箱审核系统中,模型为何判定某内容违规往往难以解释。而在SJR架构里,因为判断本身就是基于一段自然语言摘要做出的,审核人员可以直接查看这段摘要,理解决策依据。可解释性不再是需要额外附加的模块,而是架构设计的天然产物。
小结
SJR通过自然语言接口解耦内容理解与策略学习,为多模态内容审核提供了一条兼顾灵活性、数据效率与可解释性的新路径。其"总结-判断-精炼"的三段式设计,既解决了策略变更的重训练成本,也通过文本空间增强绕开了多媒体标签稀缺的瓶颈。尤其是零真实违规样本即可启动新策略的实验结果,对内容安全领域的实际部署具有相当的启发价值。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
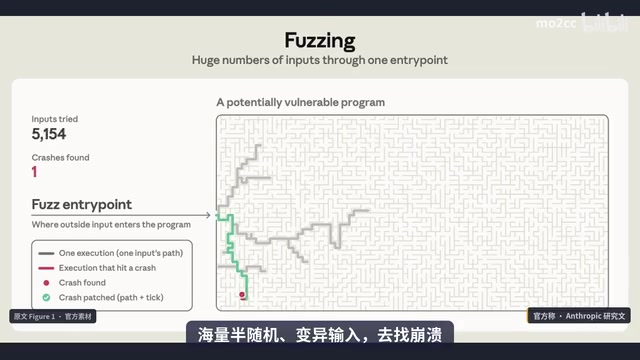
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。