SLVR:用结构化潜在推理提升多模态视觉理解

SLVR为多模态模型引入结构化潜在推理阶段,强制依赖图像而非语言先验,兼顾推理质量与效率。
多模态大语言模型普遍存在"不看图、靠猜测"的顽疾——面对视觉问答时,模型倾向于调用语言先验而非真正分析图像。SLVR(Structured Latent Visual Reasoning)提出一种新训练范式,将视觉推理组织为规划、定位、证据选择、推理整合四个带类型的潜在阶段,每个阶段配以对应的监督信号(如定位阶段对应边界框标注),在不生成显式文本推理链的前提下,赋予隐空间推理清晰的功能分工。训练策略分两步:首先通过遮蔽泄露答案的文本并引入视觉干扰项,从根源上纠正模型依赖语言捷径的习惯;其次施加逐阶段的结构化监督。基于Qwen2.5-VL-7B,SLVR在MMVP基准提升+9.4、BLINK Relation提升+14.2,在空间关系、数学视觉推理、图表理解等多类任务上均有改善,验证了结构化潜在监督能同时兼顾推理质量与推理效率的核心假设。
多模态大语言模型(MLLM)在回答视觉推理问题时,常常依赖语言先验而非真正相关的视觉证据——换句话说,它们更像在"猜"而不是在"看"。一篇来自 arXiv 的新研究提出了 Structured Latent Visual Reasoning(SLVR),试图在显式思维链与潜在推理之间架起桥梁,为细粒度视觉推理提供新的训练范式。
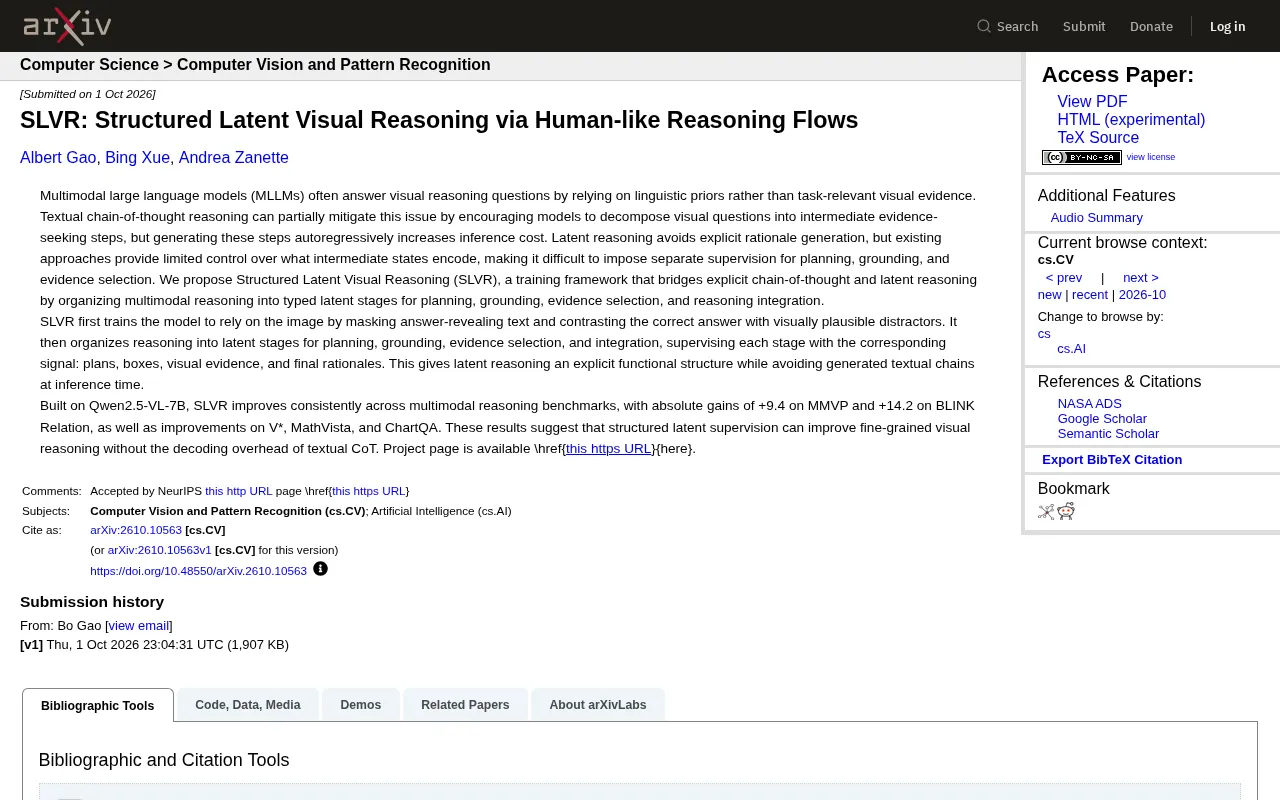
问题的根源:模型为什么不"看"图
当前多模态模型的一个顽疾在于,面对视觉问答任务时,它们倾向于调用语言模型中已有的常识先验来作答,而忽略图像里真正承载答案的证据。比如问"图中的杯子在桌子的左边还是右边",模型可能根据训练语料的统计规律而非实际画面给出答案。
文本思维链(Chain-of-Thought)在一定程度上缓解了这个问题。它鼓励模型把视觉问题拆解成一系列寻找证据的中间步骤,逐步定位、推理。但这种方式有明显代价:中间步骤需要自回归地逐词生成,推理成本随之上升。
潜在推理(Latent Reasoning)走了另一条路——不生成显式的文本理由,而是在隐空间内完成推理,从而避免解码开销。但它的短板同样突出:现有方法对中间状态编码了什么内容缺乏控制,难以针对规划、定位、证据选择等不同环节施加分别的监督。
语言先验问题在多模态模型中有其结构性根源。主流MLLM的架构通常将视觉编码器的输出转化为token序列,再输入语言模型骨干网络处理。由于语言模型在海量文本上预训练,其参数空间中已经存储了大量关于世界的统计规律。当视觉token与语言先验产生竞争时,模型往往在注意力机制层面"偏向"文本侧的证据。这一现象在MMStar、MMVP等专门设计来检测视觉依赖程度的基准上表现尤为明显——这些基准刻意收录了那些凭语言先验无法正确作答的题目,研究者因此得以量化模型"猜测"与"观察"的比例。潜在推理(Latent Reasoning)作为近年兴起的研究方向,其核心思想是让推理过程完全发生在连续的隐向量空间中,跳过自回归的逐token文本生成,从而将推理延迟压缩到接近单次前向传播的水平。代价是中间状态对人类完全不透明,也难以通过标注数据施加精确监督。
SLVR 的核心思路:给潜在推理装上"功能骨架"
SLVR 的创新点在于,它把多模态推理组织成若干个带类型的潜在阶段(typed latent stages),分别对应人类推理中的四个环节:规划(planning)、定位(grounding)、证据选择(evidence selection)和推理整合(reasoning integration)。
这套设计让潜在推理既保留了无需生成文本链的效率优势,又获得了显式思维链那样清晰的功能结构。模型不再是一个黑箱式的隐状态流转,而是每个阶段都有明确职责和对应的监督信号。
两阶段训练策略
SLVR 的训练分为两步走。
第一步是强制模型依赖图像。研究者通过遮蔽文本中会"泄露"答案的部分,并用视觉上看似合理的干扰项与正确答案做对比,迫使模型从图像而非文字捷径中获取信息。这一步从根本上纠正了模型"不看图"的倾向。
第二步是结构化的分阶段监督。推理被组织为规划、定位、证据选择、整合四个潜在阶段,每个阶段用相应的信号监督:规划对应计划,定位对应边界框(boxes),证据选择对应视觉证据,整合对应最终的推理理由。这种逐阶段的监督让隐空间推理具备了可解释的功能分工。
"带类型的潜在阶段"这一设计在实现上通常借助特殊的阶段分隔token或可学习的阶段嵌入,让模型的隐状态在不同推理环节之间产生可识别的结构性转变。这与连续思维链(Coconut)等工作有所不同——后者让模型在隐空间中自由迭代但不施加阶段划分,而SLVR明确要求每个潜在状态与特定的语义功能(规划/定位/证据/整合)对齐。定位阶段对应边界框监督这一设计尤其关键:边界框坐标是空间离散且精确的信号,强迫隐状态必须编码具体的空间位置信息,而非停留在模糊的语义层面。这种"功能骨架"的思路也使得SLVR的推理过程在一定程度上具备可审计性——尽管中间步骤不以自然语言输出,研究者仍可通过解码各阶段隐状态来检验模型是否真正执行了定位或证据选择。
实验结果:多项基准一致提升
SLVR 构建在 Qwen2.5-VL-7B 之上,在多个多模态推理基准上取得了稳定提升。其中最亮眼的是:
- MMVP 上绝对提升 +9.4
- BLINK Relation 上绝对提升 +14.2
此外,在 V*、MathVista、ChartQA 等基准上也有不同程度的改善。这些结果覆盖了空间关系、数学视觉推理、图表理解等多类任务,说明结构化潜在监督的收益并非局限于单一场景。
研究者认为,这组实验验证了核心假设:结构化的潜在监督能够提升细粒度视觉推理能力,同时避免文本思维链带来的解码开销。换言之,鱼与熊掌在一定程度上可以兼得——既要推理质量,也要推理效率。
MMVP(Multimodal Visual Perception)是专门用于衡量模型视觉感知能力的基准,其题目设计的核心原则是:凡是不看图也能答对的题目一律排除,确保每道题的答案必须从图像中直接读取。BLINK是另一个强调视觉感知与空间推理的基准,其Relation子集专注于测试物体间的相对位置、方向等空间关系,这类任务恰恰是语言先验最难发挥作用的场景。在这两个"反先验"设计的基准上取得双位数的绝对提升,是SLVR最具说服力的实验证据,直接支持了其核心主张——强制模型依赖图像证据确实可以提升真实的视觉推理能力而非仅仅刷高总分。Qwen2.5-VL-7B作为基座模型,本身已是当前开源MLLM中视觉理解能力较强的选手,在此之上仍能获得显著提升,说明SLVR的训练范式改变的是推理机制而非单纯弥补基座的短板。
意义与展望
SLVR 的价值在于它找到了显式推理与潜在推理之间的一个平衡点。显式思维链可解释但昂贵,纯潜在推理高效但失控,而 SLVR 通过"带类型的潜在阶段"把两者的优点结合起来。
这种"类人推理流"的思路——先规划、再定位、选证据、最后整合——也呼应了认知科学对人类视觉推理过程的理解。对于希望在部署成本和推理能力之间取得权衡的实际应用而言,这类方法提供了有参考价值的方向。
当然,作为一篇新发布的预印本,SLVR 的泛化能力、在更大规模模型上的表现、以及对不同类型视觉任务的适应性仍有待进一步验证。感兴趣的读者可以访问其项目主页了解更多细节。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。