SMO框架:将自然语言技能编译为可复用图结构
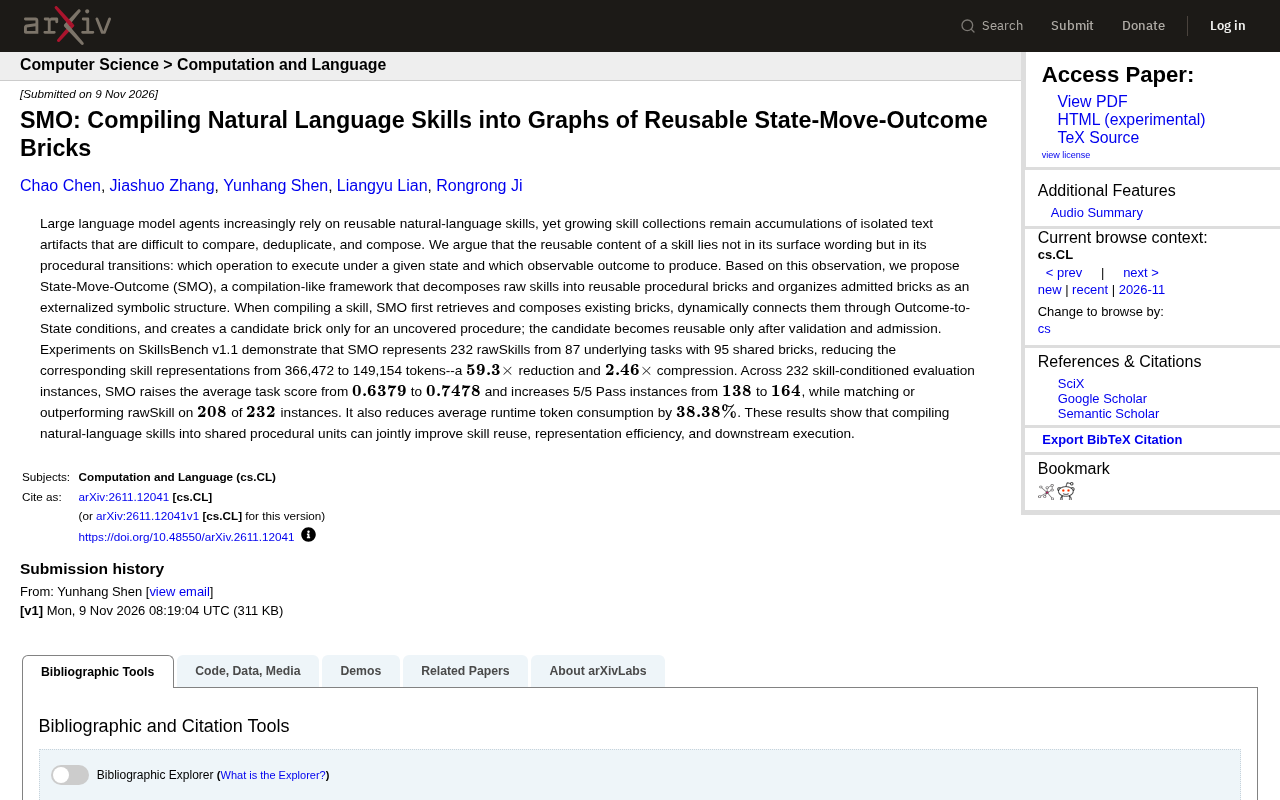
SMO框架将自然语言技能编译为共享过程砖块,实现59.3倍表示缩减并提升任务表现。
大型语言模型智能体的技能库常以孤立自然语言文本堆积,难以比较、去重和组合。研究者提出 State-Move-Outcome(SMO)框架,将技能的可复用内容定义为过程性转换(状态-动作-结果),而非表面措辞。SMO 采用类编译器流程,把原始技能分解为可复用的过程性砖块,并通过 Outcome-to-State 条件动态连接,仅对未覆盖过程创建候选砖块,经准入后成为共享资产。在 SkillsBench v1.1 上,232 个原始技能被压缩为 95 个共享砖块,token 表示从 366,472 降至 149,154,实现 59.3 倍缩减;平均任务得分从 0.6379 提升至 0.7478,5/5 Pass 实例从 138 增至 164,运行时 token 消耗降低 38.38%。这表明符号化技能编译可同时改善复用效率与执行效果。
大型语言模型智能体正越来越多地依赖可复用的自然语言技能,但不断增长的技能库往往只是孤立文本工件的堆积,难以比较、去重和组合。针对这一痛点,研究者提出 State-Move-Outcome(SMO)框架,将原始技能分解为可复用的过程性“砖块”,并组织成外部化的符号结构。实验表明,该方法在技能表示效率和下游任务表现上均带来显著提升。
技能复用的核心矛盾:表面文本 vs. 过程性转换
当前智能体技能库的典型形态是大量自然语言描述的集合,每个技能以独立文本片段存在。这种模式虽然灵活,却导致三个结构性问题:技能之间难以横向比较,重复或近似技能无法自动去重,组合新技能时缺乏可操作的接口。SMO 的核心洞察在于,技能真正可复用的内容并非其表面措辞,而是其过程性转换——在给定状态下执行何种操作,以及产生何种可观测结果。这一观点将技能从“文本工件”重新定义为“状态-动作-结果”的转换单元。
基于此,SMO 设计了一套类似编译器的流程:将原始技能分解为可复用的过程性砖块(brick),并将通过验证的砖块组织为外部化的符号结构。编译一个技能时,系统首先检索并组合已有砖块,通过 Outcome-to-State 条件动态连接它们,仅对未被覆盖的过程创建候选砖块。候选砖块只有经过验证和准入后才会成为可复用资产。这种机制确保了技能库的持续进化和质量可控。
状态-动作-结果(State-Action-Outcome)建模源自经典人工智能中的规划与强化学习框架,其核心是将一个可执行单元形式化为三元组:当前世界状态、可施加的操作、以及操作后观测到的状态变化。在智能体技能语境下,这一建模方式把自然语言描述中隐含的执行语义显式化,使技能之间可以基于状态和结果进行匹配与组合,而非依赖文本相似度。SMO 中的“过程性砖块”正是该三元组的可复用抽象,Outcome-to-State 条件则充当砖块之间的接口契约,保证组合后的技能在状态流上前后衔接。这种符号化建模的优势在于可验证性与可组合性,但也要求对自然语言技能进行结构化抽取,抽取质量直接影响后续复用效果。
实验验证:表示效率与任务表现双提升
在 SkillsBench v1.1 基准上,SMO 对来自 87 个底层任务的 232 个原始技能进行编译,最终用 95 个共享砖块表示全部技能。对应的技能表示从 366,472 个 token 降至 149,154 个 token,实现了 59.3 倍的缩减和 2.46 倍的压缩。这一结果直接回应了技能库膨胀带来的存储与检索开销问题。
在 232 个技能条件评估实例中,SMO 将平均任务得分从 0.6379 提升至 0.7478,5/5 Pass 实例数从 138 增至 164。在 232 个实例中的 208 个上,SMO 的表现匹配或优于原始技能(rawSkill)。同时,平均运行时 token 消耗降低了 38.38%。这些数据表明,将自然语言技能编译为共享过程单元,能够同时改善技能复用、表示效率和下游执行效果。
SkillsBench v1.1 是用于评估智能体技能表示与复用能力的基准测试集,其任务设计强调技能的条件化使用:给定一组可用技能,智能体需选择、组合并执行以完成底层任务。文中“232 个原始技能”来自 87 个底层任务,每个任务对应若干技能变体,评估时以技能条件实例为单位统计得分与 5/5 Pass 率。5/5 Pass 指在五次独立运行中全部成功的实例数,用于衡量技能执行的稳定性而非单次最优表现。该基准同时记录运行时 token 消耗,因此能够同时反映表示压缩带来的检索开销下降与执行效率变化。理解这一基准的构成有助于判断 SMO 结论的适用范围:它主要验证技能表示层面的改进,而非开放域技能发现或跨模态迁移能力。
设计启示:从文本堆叠到符号化技能图
SMO 的实践为智能体技能管理提供了新思路。传统技能库倾向于不断追加文本描述,而 SMO 通过编译过程强制提炼共享结构,将技能间的关系显式化为 Outcome-to-State 条件图。这种符号化表示不仅便于去重和组合,还为技能验证和准入提供了明确接口。对于构建大规模智能体系统的团队而言,这意味着技能库可以从“静态文档集合”转向“可演进的过程知识图谱”,从而降低维护成本并提升执行一致性。
符号化技能图与传统的向量检索式技能库形成对照。后者将技能编码为稠密向量,通过语义相似度召回候选技能,优点是无需人工定义结构,缺点是难以保证组合后的执行一致性,且近似技能容易重复存储。符号化技能图则以显式节点(砖块)和边(Outcome-to-State 条件)组织技能,使去重、组合和准入验证都可以在结构层面操作。这种表示借鉴了编译器中间表示(IR)的思想:原始技能像源代码,砖块像指令,条件图像控制流图,编译过程即是将多样化的表面文本归一化为可复用的中间形式。其代价是需要维护一套符号结构及其验证机制,对技能描述的规范性提出更高要求。
局限与展望
SMO 当前在特定基准上验证了有效性,但其编译过程依赖于对技能过程性内容的准确抽取,这对自然语言描述的规范性提出了一定要求。未来工作可能需要探索更鲁棒的过程抽取方法,以及如何处理跨领域技能之间的语义冲突。此外,将 SMO 扩展到多模态技能或交互式技能学习场景,也是值得关注的方向。
相关推荐
广义转移框架:非二元成分句法分析中的归约域识别
本文介绍一种广义转移框架,用于非二元成分句法分析中的归约域识别,统一了自顶向下、中序和自底向上分析,并在PTB和CTB上验证了有效性。
投机自蒸馏:高效知识内化的新范式
投机自蒸馏(SSD)通过逐token混合策略,让教师仅在学生预测显著分歧时介入,在减少38-69%监督token的同时几乎匹配全策略蒸馏性能,并在遗忘测试中表现最佳,为知识内化设立新帕累托前沿。
RDS-MOPD:用鲁棒优化破解多教师蒸馏的域分配难题
多教师在线策略蒸馏中,按学习进度分配预算无法保障落后领域。本文解读 RDS-MOPD 如何用分布鲁棒优化优先最差领域,并通过噪声阈值、异常界约束和最坏情况重定义三处改动解决信号噪声问题。