Softmax注意力如何学会决策阈值:一项理论动力学研究

理论研究揭示softmax注意力如何通过协调参数发散学习决策阈值,为上下文学习提供可解析的数学框架。
这项理论机器学习研究通过构建极简的双参数softmax注意力模型,分析了梯度预训练如何让注意力机制学会估计决策树桩阈值——一个"定位未知边界"的统计问题。研究的核心结论是:在大分辨率初始化下,梯度下降会产生一个"冻结估计器",其误差可整洁地分解为两项:反映预训练质量的有限样本精度项,以及反映推断阶段定位能力的上下文规模项。内在机制上,注意力尺度以t^(1/4)速率持续增长(即"协调的参数发散"),驱动模型逐步将注意力锐化到决策边界附近的关键样本。研究同时指出单头模型在边界处的结构性缺陷,并论证反射对称化对改善这一局限的理论价值,为理解多头注意力的必要性提供了微观线索。
研究背景:注意力机制如何学会定位边界
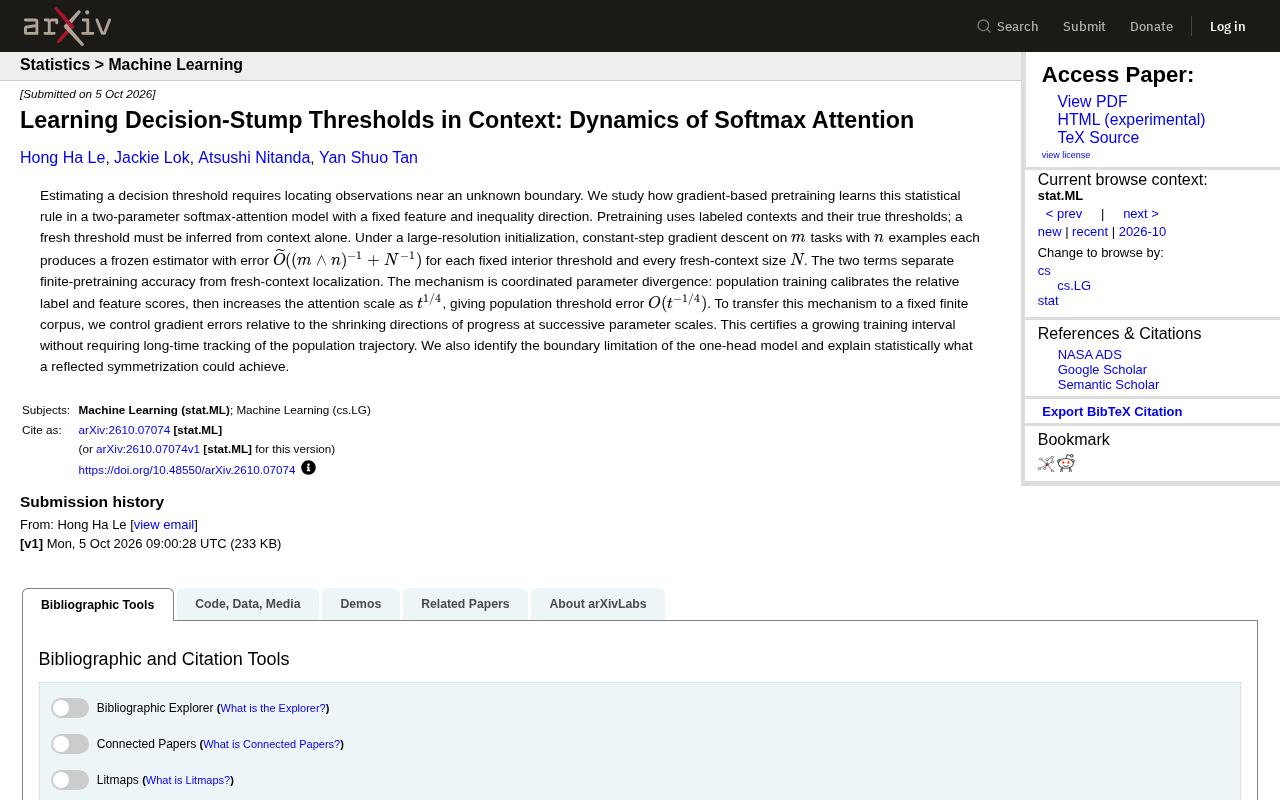
在机器学习中,估计一个决策阈值本质上是定位未知边界附近的观测值。这项发表于arXiv的研究(编号2610.07074v1)聚焦于一个看似简单却极具理论价值的问题:基于梯度的预训练究竟是如何让模型学会这一统计规则的?
研究者构建了一个双参数的softmax注意力模型,固定了特征和不等式方向,用来分析决策树桩(decision-stump)阈值的学习过程。这个高度简化的设定并非为了追求实用性能,而是为了在可解析的框架下,揭示注意力机制内部的学习动力学。
核心设定:预训练与上下文推断的分离
该模型的训练范式颇具启发性。预训练阶段使用带标签的上下文及其真实阈值,而在推断阶段,一个全新的阈值必须仅从上下文中推断出来——这与当下大语言模型的「上下文学习」(in-context learning)范式高度呼应。
研究的核心结论是:在大分辨率初始化条件下,对 $m$ 个任务(每个含 $n$ 个样本)进行恒定步长的梯度下降,会产生一个「冻结估计器」,其误差为 $\widetilde O((m\wedge n)^{-1}+N^{-1})$,这一结论对每个固定的内部阈值和任意的新上下文规模 $N$ 都成立。
误差的两项分解
这个误差界的巧妙之处在于它自然地分离成两项,各自对应不同的来源:
- 第一项 $(m\wedge n)^{-1}$ 反映的是有限预训练的精度,即训练任务数量与每任务样本数的最小值所决定的瓶颈;
- 第二项 $N^{-1}$ 反映的是新上下文的定位能力,即推断阶段上下文规模对阈值定位精度的影响。
这种清晰的分解让我们能够分别理解「学到了多少统计规则」和「在新场景下能定位得多准」这两个相互独立的维度。
「上下文学习」(in-context learning,ICL)是指大语言模型无需更新参数,仅凭推断时输入的少量示例就能完成新任务的能力。这一现象在GPT-3等模型中被广泛观察到,但其内在机制长期缺乏理论解释。一种主流假说认为,预训练阶段模型隐式地学习了某种"学习算法",使其在推断时能执行类似贝叶斯推断或梯度下降的操作。本研究正是在这一框架下,通过将ICL具体化为"从上下文中估计决策阈值"这一可分析的任务,为ICL的机制提供了一个严格的数学切入点。
内在机制:协调的参数发散
研究揭示的核心机制被称为「协调的参数发散」(coordinated parameter divergence)。具体来说,总体训练过程会先校准标签分数与特征分数的相对关系,随后以 $t^{1/4}$ 的速度增大注意力尺度,从而使总体层面的阈值误差以 $O(t^{-1/4})$ 的速率收敛。
这一发现对理解注意力机制为何有效提供了理论视角:注意力尺度的持续增长并非偶然,而是模型逐步「锐化」其对边界附近观测值关注程度的必然结果。随着训练推进,模型越来越能够精确地把注意力集中到决策边界附近的关键样本上。
从总体到有限语料的迁移
理论分析中一个常见的难点是,总体(population)层面的优雅结论未必能直接迁移到有限语料上。研究者通过控制梯度误差——使其相对于各参数尺度上「不断收缩的进展方向」保持可控——解决了这一问题。
这种技术路径的意义在于,它无需对总体轨迹进行长时间的跟踪,就能证明一个不断增长的训练区间是有效的。换言之,研究提供了一种在不依赖理想化连续轨迹的前提下,严格刻画有限样本训练行为的方法。
「决策树桩」(decision stump)是最简单的决策树形式:它只有一个分裂节点,依据某单一特征是否超过某阈值来做二分类。尽管表达能力有限,决策树桩因其结构简洁而被广泛用作理论分析的基准模型——从Boosting(提升法)的早期理论到本研究,都借助它来剥离复杂性、聚焦核心机制。在本研究的语境中,阈值本身是未知的随机变量,模型需通过观测带标签的上下文样本来推断其位置,这在统计学上等价于估计某分布的分位数或边界参数,具有清晰的最优估计理论作为参照基准。
单头模型的边界局限与对称化启示
研究并未回避模型的局限。作者明确指出了单头(one-head)模型在边界处的限制,并从统计学角度解释了「反射对称化」(reflected symmetrization)可能带来的改善。
这一讨论颇具价值:它说明单一注意力头在处理边界情形时存在固有的结构性缺陷,而通过引入对称化机制——本质上是补充相反方向的不等式信息——有望突破这一限制。这也为理解多头注意力的必要性提供了一个微观层面的理论线索。
「反射对称化」在统计估计中是一种常见的方差缩减技巧:对于某个估计量,若将其与关于对称轴翻转后的版本取平均,可消除单侧偏差。在注意力机制的语境下,单头模型天然倾向于从一个方向(如特征值从小到大的排序方向)定位边界,对反方向的边界则存在系统性偏差。通过引入对称化——即同时考虑正向与反向不等式所对应的注意力头——相当于让模型从两侧同时逼近边界,理论上可将误差阶从单侧估计降低至对称估计的水平。这为多头注意力在理论层面的必要性提供了一个具体的统计解释。
研究意义与思考
这项工作属于典型的理论机器学习研究,它不追求在大规模任务上的实测性能,而是通过极度简化的模型,换取对注意力学习动力学的可解析理解。
其价值主要体现在三个方面:一是将抽象的「上下文学习」能力拆解为可量化的误差项;二是揭示了注意力尺度随训练发散这一普遍现象背后的统计意义;三是通过单头模型的局限,反向论证了更复杂结构的合理性。
对于关注Transformer理论基础的研究者而言,这类微观动力学分析是理解大模型涌现能力的重要拼图。尽管从简化模型到真实大模型之间仍有巨大鸿沟,但正是这些扎实的理论工作,让我们对「注意力究竟在学什么」有了更清晰的认识。
需要说明的是,本文基于论文摘要撰写,具体的证明细节、实验验证以及更广泛的适用性边界,仍需参考完整论文。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。