SparkBots AI:秒级提取网页与PDF关键信息

SparkBots AI用可训练的专用小机器人实现亚秒级、不幻觉的网页与PDF信息提取。
SparkBots AI是Product Hunt上新亮相的文档信息提取工具,由Jev提供技术支持。其核心思路是训练针对特定页面类型的专用机器人,而非每次调用通用大模型重新推理,从而在结构相似的网页或PDF上实现不到一秒的响应速度。产品强调答案严格来自页面原文,缺失信息留空,因此不会产生幻觉,适合简历、合同、房源列表和销售线索等模板相对固定的抽取场景。与ChatGPT、Claude相比,它以牺牲通用性换取速度与确定性。该产品在Product Hunt获得78票、排名第14,初步验证了市场需求,但定价、隐私策略、训练流程和版式变化容忍度等关键信息尚未公开,接入核心流程前需用真实文档做小规模测试。
在信息过载的时代,快速从网页或PDF中提取关键细节是许多业务流程的刚需。Product Hunt上刚刚亮相的SparkBots AI(由Jev提供技术支持)试图用“可训练的小型专用机器人”来解决这个问题,号称能在不到一秒内返回答案,并且不会像通用大模型那样产生幻觉。
从通用大模型到专用小模型:SparkBots的定位
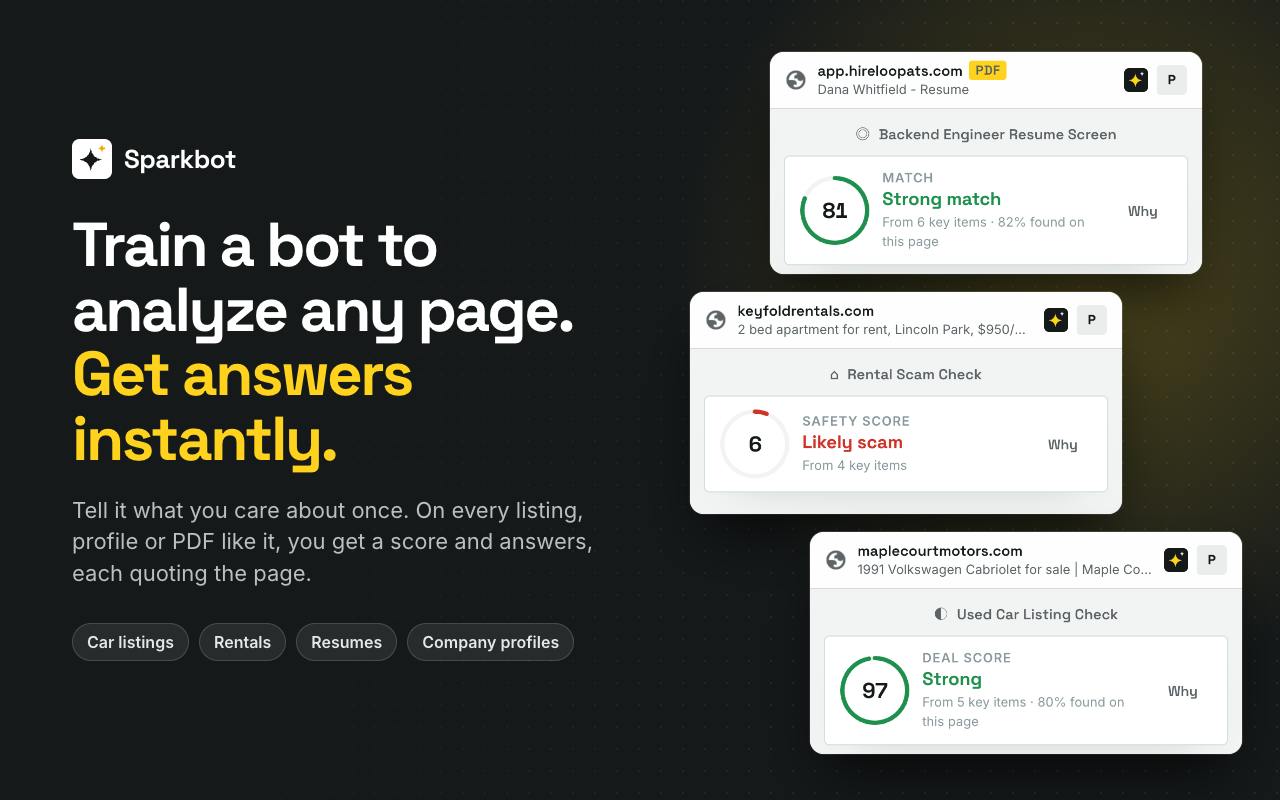
SparkBots的核心思路与Claude、ChatGPT这类通用LLM走的是两条路。根据官方描述,SparkBot可以被“训练”来深度分析任意网页或PDF;一旦训练完成,面对结构相似的页面,它能在不到一秒内给出答案。这个速度指标是产品主打的卖点之一,对于需要批量处理简历、合同、房源列表或销售线索的场景,亚秒级响应意味着可以把提取环节嵌入到实时工作流里,而不是异步排队等待。
产品页面上还特别强调了一点:SparkBot虽然使用AI,但它不是一个“慢速LLM”。它的答案直接来自页面内容,找不到的信息就留空,因此“不会产生幻觉或编造不存在的细节”。这实际上是在回应企业用户对生成式AI最普遍的顾虑——在合同、简历等容错率极低的文档处理中,一个编造出来的字段可能比没有字段更糟糕。
幻觉(Hallucination)是生成式AI领域的专有概念,指模型生成看似合理但与输入事实不符、甚至完全虚构的内容。在大语言模型中,幻觉源于其基于概率预测下一个词的工作机制:模型倾向于输出流畅连贯的文本,而非严格核对事实。对于合同、简历、财报等结构化文档处理场景,幻觉的危害尤为突出——一个被编造出来的合同金额或候选人工作年限,可能直接导致业务决策失误。业界常用的缓解手段包括检索增强生成(RAG)、约束解码和答案溯源,但这些方法只能降低概率,无法从根本上杜绝。SparkBots宣称的“不幻觉”本质上是把抽取任务从生成式范式转为判别式或检索式范式:答案必须能在原文中找到对应片段,找不到就返回空值,从而在机制上规避了编造的可能性。
通用LLM与专用小模型(Small Language Model / Specialized Model)的路线差异,是当前AI应用落地的一个核心分水岭。通用LLM如GPT-4、Claude系列参数量巨大、训练数据覆盖面广,因而具备跨领域的推理、总结和多轮对话能力,但每次推理都需要将完整上下文送入模型,延迟通常在秒级甚至更高,调用成本也随上下文长度线性增长。专用小模型则针对单一任务或单一文档类型进行训练或微调,参数量小、推理路径短,因而能实现亚秒级响应,且在限定任务上的准确率往往不输大模型。代价是泛化能力弱:一旦页面版式或字段定义发生变化,专用模型可能需要重新训练。这种“窄而快”与“广而慢”的权衡,决定了二者在业务流程中扮演不同角色——通用LLM适合探索性、开放性任务,专用小模型适合高频、模板化的批量处理。
可训练、可复用的提取逻辑
SparkBots的工作方式不是每次提问都从头推理,而是先“训练”一个针对特定页面类型的机器人,之后在同类页面上复用它。这种模式在文档信息抽取领域并不陌生,但SparkBots把它包装成了面向业务用户的产品形态,而不是需要写代码的API。官方列举的适用对象包括销售线索、企业信息、简历、房源列表和合同,基本覆盖了中小团队日常需要结构化处理的文档类型。
这种“训练一次、复用多次”的设计也带来了成本上的隐含优势:相比每次调用大模型重新阅读整篇文档,专用机器人在重复性任务上的单次开销理论上更低。不过产品页面没有披露具体的定价、训练所需样本量或支持的文件格式范围,这些是评估其实际可用性时绕不开的问题。
文档信息抽取(Document Information Extraction)是自然语言处理中的成熟研究方向,目标是从半结构化或非结构化文档中识别并抽取出预定义的字段,如发票号、合同甲方、简历中的工作经历等。传统方案依赖规则模板或正则表达式,维护成本高且对版式变化敏感;深度学习方法则通过标注样本训练序列标注或问答式模型,具备一定的版式鲁棒性。近年来,基于视觉的文档理解模型(如LayoutLM系列)进一步将文本与版面布局联合建模。SparkBots所描述的“训练一次、复用多次”,在产品层面接近于为特定页面类型构建一个轻量抽取器,其技术实现可能是基于少量样本的少样本学习或模板匹配加语义校验。理解这一背景有助于判断其能力边界:它对“结构相似”的页面有效,但对版式剧烈变动或扫描质量差的PDF,效果需要实测验证。
与通用LLM的取舍
把SparkBots和ChatGPT、Claude对比,能更清楚地看到它的适用边界。通用LLM的优势在于开放域的推理、总结和对话能力,适合处理没有固定模板的内容;代价是响应延迟较高,且在事实性抽取任务上存在幻觉风险。SparkBots选择牺牲通用性换取速度与确定性,答案严格限定在页面已有内容内。
这种取舍意味着它更适合“字段明确、模板相对固定”的抽取任务,而不是开放式分析。官方把它定位为“深度分析”工具,但从描述看,它的能力边界更接近高精度的结构化信息提取,而非理解性推理。对于需要判断合同条款风险或综合评价候选人这类任务,专用机器人能提供原始字段,判断逻辑仍需人来完成。
市场反响与待观察之处
SparkBots AI在Product Hunt上获得了78个投票,排名第14位,评论数为5条。这个成绩说明它切中了一部分用户的痛点,但距离现象级产品还有距离,样本量也还不足以判断长期口碑。Maker为Malcolm(Hello Spark AI),官网链接指向Product Hunt的跳转页。
目前公开信息中缺失的关键项包括:训练机器人的具体操作流程、支持的页面结构变化容忍度、数据隐私与存储策略,以及定价模式。对于要把客户合同或简历交给第三方处理的团队来说,后两项尤其重要。SparkBots提出的“不幻觉、亚秒级”承诺很有吸引力,但这些承诺需要在真实、杂乱的实际网页和PDF上验证——毕竟产品页面上的演示环境通常比真实数据干净得多。
对于正在寻找文档信息提取方案的团队,SparkBots值得列入观察名单,尤其是那些已经厌倦了为大模型幻觉做人工复核的业务线。但在把它接入核心流程之前,建议先用自己手上的真实文档做一轮小规模测试,重点验证两点:训练后的机器人在页面版式微调后是否仍然稳定,以及留空策略在关键字段缺失时的表现是否符合预期。
相关推荐

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。

Cedric AI:替你开会讲PPT的AI代理
Cedric AI 是 Product Hunt 上发布的会议 AI 代理,能替你进入 Zoom、Meet、Teams 会议演示幻灯片、用实时数据回答问题,并在会后生成待审批的笔记与跟进事项。本文解析其三层能力、差异化设计与适用场景。