Step-5-preview实测:对比DeepSeek V4.1 Flash等三款模型
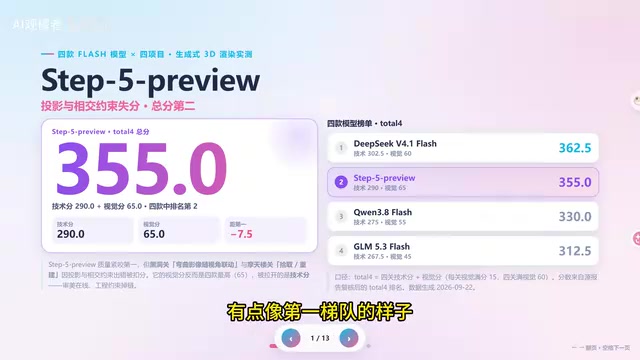
四项实战演示评测显示,Step-5-preview视觉最佳但技术细节略逊,整体与DeepSeek V4.1 Flash同属第一梯队。
本文通过黑洞引力透镜、光追玻璃美术馆、参数化摩天大楼、虚拟城市疏散四个实战演示项目,对阶跃星辰Step-5-preview与DeepSeek V4.1 Flash、千问3.8 Flash、GLM5.3 Flash进行横向评测。评测由GPT-6 Astra统一出题并打分,力求客观。总分上,Step-5-preview落后DeepSeek V4.1 Flash仅7.5分,两者同属第一梯队;Step-5-preview视觉得分排名第一,技术得分排第二,短板集中于实现细节(如比例变形)。GLM5.3 Flash综合最弱,千问3.8 Flash则存在严重的耗时过长问题,平均响应时间是其他模型的2-3倍。结论是:追求视觉效果可选Step-5-preview,综合稳定首选DeepSeek V4.1 Flash,速度敏感场景需警惕千问3.8 Flash。
近日,阶跃星辰推出了新模型 Step-5-preview,在官方发布的 AA 榜(Artificial Analysis)上挤进了较为靠前的位置,甚至进入开源榜前列。但官方跑分是一回事,实际动手表现又是另一回事。本文通过四个实战演示项目,将 Step-5-preview 与近期同样热门的三款 Flash 模型——DeepSeek V4.1 Flash、千问3.8 Flash、GLM5.3 Flash(GRM5.3)——放在一起横向评测,看看它究竟处于什么水平。
评测方法与四大实战项目
本次评测的公平性设计值得先交代清楚。四套提示词由 GPT-6 Astra(评测中简称 Astra)统一生成,让每个模型分别产出四个演示页面;最终评分也由 Astra 根据视觉表现和原始代码统一打分,而非评测者个人主观感受,力求客观。
四个项目分别对应不同的技术难点:
- 黑洞引力透镜:考验物理公式实现与光学演示,是测评博主的常见项目。
- 光追玻璃美术馆:涉及光线追踪、玻璃折射与反射,考验模型对材质认知、光照真实度的实现,难度最高。
- 参数化摩天大楼:两个模型可互相扭动、抛面、分离组合,考核几何生成与资源启动稳定性。
- 虚拟城市疏散:考验动态人群疏散仿真。
这套设计的好处在于,它覆盖了物理、光学、几何、动态仿真等多个维度,虽然不能全面描绘模型的完整能力,但足以给出一个相对可靠的定位参考。
AA榜(Artificial Analysis)是一个独立的AI模型基准测评平台,综合评估模型在推理能力、代码生成、数学等维度的表现,并提供速度与价格的性价比参考。与MMLU、HumanEval等单一学术榜单不同,AA榜试图提供更贴近实际使用场景的横向比较。然而,静态榜单得分与动态生成任务之间存在天然落差——榜单题目往往是封闭式选择或固定格式输出,而代码生成、可视化演示等开放任务需要模型在创意、结构与工程细节上同时发挥,这正是本文实战评测的价值所在。
总分排名:Step-5-preview 落后 DeepSeek 仅7.5分
尽管官方宣称 Step-5-preview 性能强劲,但实测总分显示它略弱于 DeepSeek广告 V4.1 Flash。不过差距并不大——两者总分仅相差 7.5 分,可以说属于同一梯队。
有意思的是分项数据:在技术得分上,Step-5-preview 排第二;而在视觉得分上,它反而排第一。也就是说,Astra 认为 Step-5-preview 在四个项目里的视觉表现是四款模型中最好的,主要的分差来自基础技术分。
相比之下,Step-5-preview 与 DeepSeek V4.1 Flash 组成的“第一梯队”,对千问3.8 Flash 和 GLM5.3 Flash 的领先幅度更明显。后两款模型的成绩又比较接近,处于第二梯队。
逐项拆解:谁在哪里失分
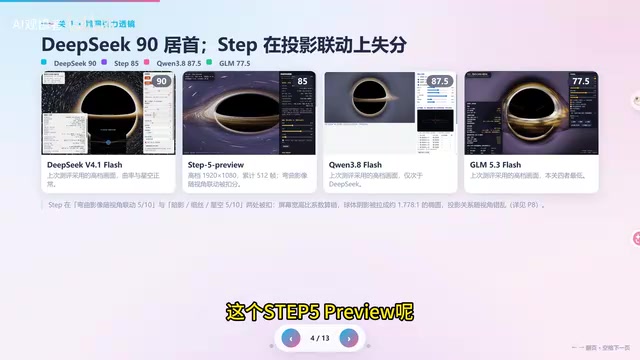
黑洞演示
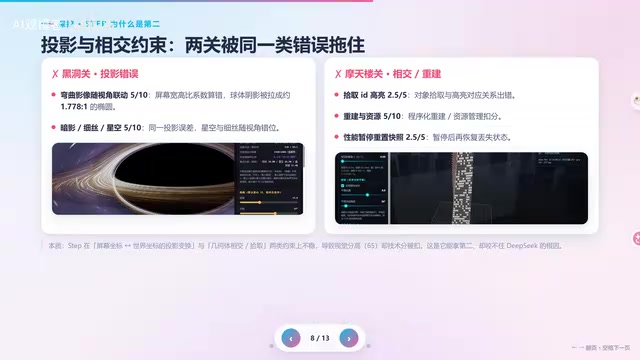
仅从截图看,DeepSeek V4.1 Flash 做得最好,拿到 90 分名副其实。Step-5-preview 表现也还行,但尺寸比例略有变形、显得有点扁,主体阴影被拉成了椭圆形,不过代码实现、引力透镜参数、公式演示等方面均无大问题。千问3.8 Flash 排第三,展示稍显简陋但无大毛病;GLM5.3 Flash 垫底,画面偏糙,数学公式演示也出现了问题。
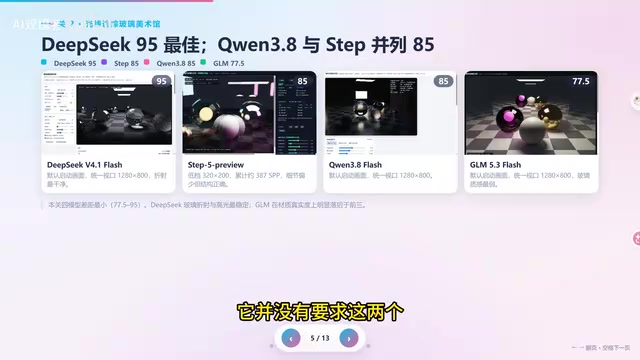
光追美术馆(难度最高)
这一关最能拉开差距。DeepSeek V4.1 Flash 影线幅度大、独树一帜。Step-5-preview 和千问3.8 Flash 大体没问题、细节略有瑕疵。值得一提的是,评测者发现 Step-5-preview 的玻璃球与金属球会相互融合、缺乏碰撞关系,专门就此询问 Astra,但 Astra 表示提示词中并未要求两球具备材质碰撞关系,因此不算扣分项。GLM5.3 Flash 则在光线折射上出现错误,成为扣分点。
光线追踪(Ray Tracing)是一种通过模拟光线在场景中的物理传播路径来生成图像的渲染技术。其核心在于计算光线与物体表面的交点,并递归模拟反射(Reflection)、折射(Refraction)和阴影(Shadow)等光学效应。玻璃材质的实现尤为复杂,需要同时处理折射率(通常使用斯涅尔定律)、全内反射临界角以及菲涅尔方程描述的反射/折射能量分配。在纯代码(如WebGL或Canvas 2D)中实现光线追踪,要求模型对这些物理公式有准确的编程映射能力,因此该项目被列为本次评测难度最高的任务。
摩天大楼
各家表现都不错,Astra 认为 Step-5-preview 在这一项各方面实现最佳。较明显的短板是千问3.8 Flash,做得偏简陋。
城市疏散
Step-5-preview 与 DeepSeek V4.1 Flash 并列第一,千问3.8 Flash 和 GLM5.3 Flash 差距不大。
四款模型的最终定位与特点
综合四个项目,可以给出各模型清晰的画像:
- DeepSeek V4.1 Flash:领先幅度明显,四个项目上基本没有明显短板,综合最强。
- Step-5-preview:有一些小短板,如投影变形、比例偏扁等,但视觉表现最优,整体位居第二梯队第一。
- 千问3.8 Flash:整体尚可,但在摩天大楼项目上扣分较重。需特别注意的是,它是四款模型中耗时最久的,平均单个项目可能是其他模型的两到三倍,“过度思考”问题严重。
- GLM5.3 Flash:整体最弱,尤其在光追美术馆里扣分严重。
需要强调的是,四款模型的视觉分其实差别不大,最大的差距来自基础技术分。此外,部分项目存在帧率不高、启动较慢的小问题,但只要能正常启动,并未计入扣分。
"过度思考"(Overthinking)是指推理型大模型在链式思考(Chain-of-Thought)过程中生成冗余推理步骤,导致响应延迟大幅增加而最终输出质量并未等比例提升的现象。这在Flash系列等轻量快速模型中尤为值得关注,因为此类模型本应以低延迟为核心卖点。千问3.8 Flash耗时达到其他模型2-3倍,意味着其思维链长度可能远超必要,对于需要实时交互或批量调用的场景,这一问题会显著影响实用价值和API成本。
结论
对于关注国产模型进展的开发者来说,这次评测的核心信息是:Step-5-preview 虽然官方跑分亮眼,但在实际的物理/工程演示生成任务中,它与 DeepSeek V4.1 Flash 属于同一梯队、略逊一筹,其中视觉表现甚至更胜一筹,短板集中在技术实现的细节上。
当然,四个演示项目无法全面描绘一款模型的全方位性能,本文更多是提供一个横向参考坐标。如果你的应用场景偏重视觉呈现,Step-5-preview 值得一试;若追求综合稳定,DeepSeek V4.1 Flash 仍是更稳妥的选择;而对速度敏感的用户,则需警惕千问3.8 Flash 的耗时问题。
相关推荐
AI验收裁判的四种病与证据健康闸实战解析
AI验收裁判也会说谎?本文解析AI checker的四种典型故障——假红、畸形惧判、失联与最危险的假pass,并给出可当天落地的证据健康闸机制:工具白名单、token地板与diff引用三道检查,帮你看住验收流水线上的裁判。
在ChatGPT一个窗口搞定AI视频:Astra调用Higgsfield实测
实测在ChatGPT一个窗口内通过MCP协议调用Higgsfield生成AI视频:产品广告、公寓漫游、短片三个案例,展示Astra如何自主规划、生成、审查并修复,把用户从操作员变成导演。
DeepSeek Harness入门:Node.js环境配置全流程详解
DeepSeek Harness 入门第一步:完整拆解 Node.js 安装与环境变量配置,包括非 C 盘安装、Add to PATH 勾选、npm prefix 与 cache 目录设置,帮助零基础用户为 AI 任务自动化打好环境基础。