Strata启动器一键部署Qwen3.8 Flash Next,免费不限量Token

50KB 启动器用国内镜像一键部署 Strata 与量化 Qwen 模型,降低网络门槛但硬件门槛仍在。
文章介绍了 B 站 UP 主开发的 Strata Launcher,一个约 50KB 的引导工具,用于简化开源项目 Strata 的本地部署。它针对国内用户的核心痛点——GitHub 与 Hugging Face 访问不稳定——改为从魔搭社区拉取权重、依赖走国内镜像并自动获取源码。部署流程包括源码下载、硬件检测与模型选择、KV Cache 量化与多模态/局域网配置、引擎与权重下载、启动及显存预留五步。作者以 Tesla T4、32GB 内存的云电脑实测,选择较小的量化 Coder 模型,指出接入 Agent 工具需 64K 以上上下文、建议 8 比特 KV Cache、磁盘至少预留 100GB。实际体验可跑通,但小量化模型文本质量有限,适合低成本体验与 Agent token 供给。
最近,一个名为 Strata 的项目在开发者圈子里热度很高,它允许用户在本地免费、不限量地调用大模型。但 Strata 的部署流程并不简单:从 GitHub 拉源码、配置 Python 环境、下载模型权重……每一步都可能卡住新手。B站有 UP 主专门做了一款名为 Strata Launcher 的启动器工具,号称“一键搞定” Strata 与 Qwen3.8 Flash Next 模型的部署。本文基于该视频内容,梳理这套方案的实际操作流程与关键细节。
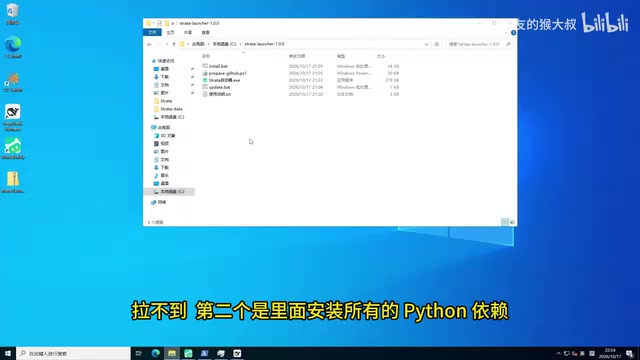
Strata Launcher 解决了什么痛点?
Strata 本身是一个开源项目,但它的安装过程对国内用户并不友好。UP 主在视频中明确指出,很多人在第一步“拉源码”时就会失败——因为 Strata 的代码托管在 GitHub 上,部分网络环境无法访问。
Strata Launcher 的核心价值就在于此。这个压缩包只有 50KB 左右,不包含任何源码或权重文件,纯粹是一个引导工具。它替用户做了三件事:
- 从国内魔搭社区拉取模型权重,避免 Hugging Face 连接不稳定的问题;
- 所有 Python 依赖走国内镜像源,减少因网络问题导致的安装失败;
- 自动拉取 Strata 源码,并在本地目录下完成组织,用户无需手动操作 GitHub。
换句话说,它把 Strata 部署中最容易“劝退”的环节——网络访问——用国内镜像和自动化流程消化掉了。
部署流程:从硬件检测到模型启动
启动器的使用方式很直接:解压后运行可执行文件,首次启动会读取当前目录下的配置文件,然后进入安装向导。
第一步:源码与依赖自动下载
点击“安装/修改”后,启动器会自动下载 Strata 源码。UP 主提醒,下载速度取决于网速,需要耐心等待。源码就位后,程序自动进入下一步,无需人工确认。
第二步:硬件检测与模型选择
启动器会检测当前电脑的显卡和内存情况。UP 主使用的是一张特斯拉 T4 显卡(通过腾讯云广告租用的云电脑),内存 32GB。检测完成后进入模型选择界面,Strata 官方推荐的是效果最好的模型,但 UP 主本地跑不起来,于是选择了较小的 Coder 模型——也就是视频标题中的 Qwen3.8 Flash Next 的量化版本。
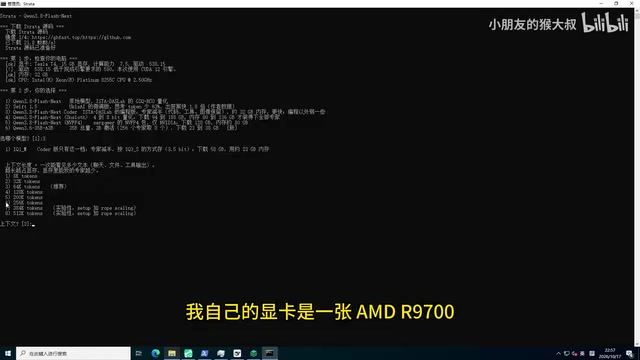
这里有一个重要限制:UP 主在另一台配置为 AMD 9700 + 32GB 显存 + 64GB 内存的机器上实测,能跑 56K 上下文;但如果要接入 WorkBuddy广告 这类 Agent 工具,上下文最低需要 64K,因为 WorkBuddy 自身的提示词长度已经超过 32K。上下文选小了,Agent 根本没法用。
上下文长度(Context Length) 指模型在一次推理中能够同时“看到”的 token 总量,包含系统提示词、历史对话和当前输入。它决定了模型能记住多长的对话、能处理多长的文档,也直接影响显存占用——KV Cache 的大小与上下文长度成正比。Agent 工具之所以要求 64K 以上,是因为其系统提示词、工具描述和多轮中间结果本身就会消耗大量 token,若上下文窗口不足,历史信息会被截断,Agent 的规划与工具调用就会失效。因此选型时上下文长度往往比模型参数量更关键。
第三步:量化与缓存配置
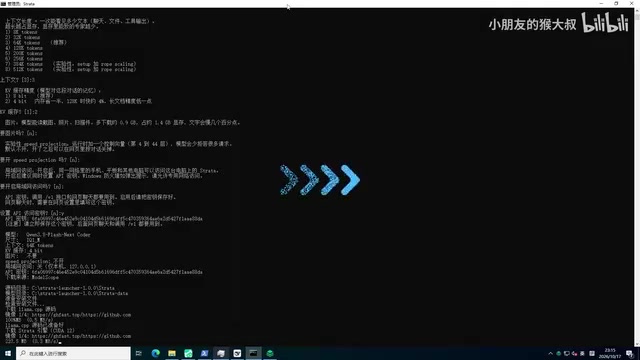
KV Cache 的量化位数直接影响对话质量。UP 主建议选择 8 比特,因为 4 比特量化压缩太厉害,会导致对话质量明显下降。但他自己因为显存不足,只能选 4 比特。
多模态功能默认关闭,开启后会额外下载一个约 0.9B 的模型。局域网访问和 API Key 则根据使用场景决定:如果只在本地用,保持关闭即可;如果开启局域网访问,务必同时开启 API Key,否则同网络下任何人都能访问你的服务。
KV Cache 是 Transformer 推理时缓存每一层注意力中已生成 token 的 Key 和 Value 张量,避免重复计算,从而让逐 token 生成保持高效。它的显存占用随上下文长度、层数、注意力头数和批大小线性增长,在长上下文场景下甚至可能超过模型权重本身。对 KV Cache 做量化(如 8 比特或 4 比特)可以显著压缩这部分显存,代价是注意力计算结果出现误差,位数越低,长对话中细节丢失和语义漂移越明显。这也是文中建议 8 比特、慎用 4 比特的原因。
第四步:下载引擎与模型权重
启动器会先下载 numcpp 源码,再下载 Strata 的推理引擎(约 200 多 MB)。UP 主特别强调:磁盘至少预留 100GB 空间,否则模型权重会下载失败。权重文件从魔搭社区拉取,如果本地已有权重,启动器会自动识别并跳过下载。
模型权重(Weights) 是训练完成后保存的神经网络参数文件,通常以 safetensors 或 GGUF 等格式分发,体积由参数量和精度共同决定:一个 7B 参数的模型在 FP16 下约需 14GB,量化到 4 比特可压缩到 4GB 左右。下载后的权重需要完整落盘再加载,若磁盘空间不足会在写入中途失败,且大文件写入对机械硬盘尤为缓慢。魔搭社区(ModelScope)是国内的模型托管平台,镜像了主流开源模型,可规避 Hugging Face 的访问问题,这也是启动器选择它作为权重源的原因。
第五步:启动与显存预留
模型启动时会将权重加载到显存和内存,整个过程电脑会非常卡,机械硬盘的读取速度尤其慢。启动成功后会自动弹出 Strata 的 Web 监控页面。UP 主因为机器配置低,需要手动修改一个显存预留参数,留出 3GB 显存给后续对话使用,否则一对话就会爆显存。
显存预留(VRAM Reserve) 是在加载权重后主动留出一部分显存不分配,供推理过程中的 KV Cache、激活值和临时张量使用。若权重几乎占满显存,首次对话时分配 KV Cache 就会触发显存不足(OOM),表现为服务崩溃或请求直接失败。预留量需根据上下文长度和并发数估算:上下文越长、并发越多,所需预留越大。手动调低预留可让更大的模型勉强加载,但代价是可用对话长度被压缩,稍长输入即会爆显存。
实际体验:能跑,但别期待太高
UP 主将部署好的模型接入了 DeepSafe、Hanis 和 Codex 等工具,在 Strata 监控页面能看到推理状态:预填充(V 顶)阶段速度不快,Token 生成阶段则持续输出。
但他也坦率地指出,因为这个模型量化比较厉害,而且部署的是最小的 Coder 模型,所以“在文本方面还是差点意思”。换句话说,这套方案适合想低成本体验本地大模型、或者给 Agent 工具提供一个免费 token 来源的用户,但如果追求高质量文本生成,小量化模型的表现有限。
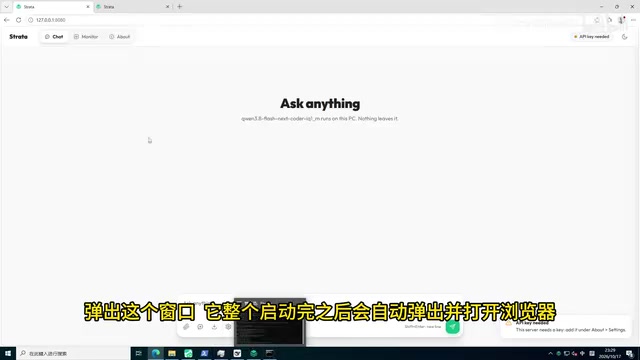
后续使用时,用户可以直接从启动器页面启动 Strata 服务、复制 API 密钥和模型调用地址,也可以重新安装、修改配置或更新 Strata 版本。启动器支持最小化到系统托盘,在后台保持运行。
适合谁用?
这套方案的核心受众很明确:有本地或云显卡资源、想绕过网络障碍快速跑起 Strata、并且需要一个免费不限量 token 来源的开发者。如果你的显存和内存足够,可以选更大的上下文和更高的量化精度,体验会好不少;如果配置有限,就要在模型大小、上下文长度和量化位数之间做取舍。Strata Launcher 把部署门槛降到了“点几下鼠标”的程度,但硬件门槛依然存在——这一点视频里没有回避。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。