Strata神项目实测:12G显卡本地跑176B千问大模型

开源项目Strata通过整机协同调度,让12G显卡本地运行176B参数MoE大模型成为现实。
Strata是一个开源大模型推理项目,核心创新在于将GPU显存、CPU内存和SSD组成三层存储体系,配合MoE模型每次仅激活极少数专家的稀疏特性,让一张12G显存的游戏本显卡得以流畅运行176B参数体量的Qwen3.8 Flash Next模型。实测数据显示,5070 12G配64G内存的配置下,短聊天速度可达93 token/s,128K长上下文也有74 token/s。项目还集成了MTP投机解码带来1.6-1.8倍额外提速,并根据用户内存自动推荐Q2至iQ2XS等量化档位,开箱即用且自带OpenAI兼容API接口。项目上线不足10天已逼近5000 Star,但目前仍不支持并发批处理,首条长消息读取需要一定等待时间。
一张12G显卡,撬动176B大模型
本地部署大模型长期被显存墙卡住脖子。一张12G或16G的游戏本显卡,面对动辄上百亿参数的大模型往往束手无策。而一个名为 Strata 的开源项目正在改变这个局面——根据B站UP主的实测分享,只要你手里有一张12G显存的显卡,不管是游戏本还是普通PC,都能流畅跑起1250亿参数(整体176B体量)的 Qwen3.8 Flash Next 大模型。
这个项目上线不到10天就逼近5000 Star,作者更新频率极高,几乎每天都有新版本推出。UP主直言,Strata 和另一个项目是他今年用起来体验最好的两个工具。
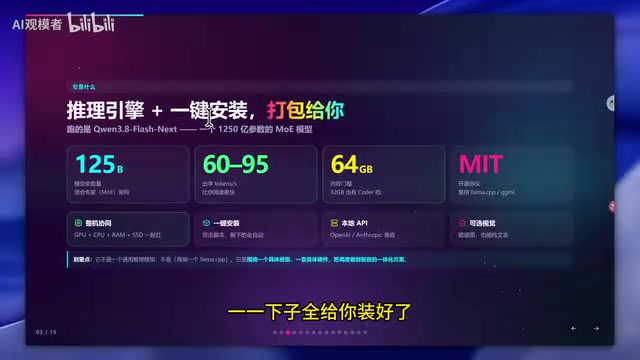
从实测数据看,在5070 12G显卡配合64G内存的配置下,短聊天场景速度可达93 token/s,即便是128K长上下文也有74 token/s。这个速度对于一个176B体量的MoE模型来说,已经完全可用。
Strata到底解决了哪三堵墙
本地部署大模型主要卡在三个痛点上,Strata逐一给出了答案。
显存墙 是最核心的障碍。当前显存价格高企,大部分用户只能用上12G或16G档位的显卡,而要装下125B量级的模型,中间差了至少一个数量级。即便MoE模型激活参数少,传统方案也需要把全部专家加载进显存才能运行。
部署门槛 是第二堵墙。小白直接上手 llama.cpp 这类工具,仍要面对编译、依赖、量化格式乃至几十GB的下载流程,很多人看到这些就直接劝退。
生态缺失 是第三堵墙。即便模型勉强跑起来,如果没有标准API接口,模型就无法接入工具链,只能聊聊天,实用价值大打折扣。
Strata的定位正是针对这三点:既是推理引擎,又能一键打包安装,还默认给你选好了几个不错的量化版本——输入一个数字,它就帮你下载并本地部署好,同时提供兼容OpenAI的本地API。
核心技术:三层存储的整机协同
Strata能让12G显卡跑动176B模型,关键在于它采用了GPU+CPU+内存+SSD的整机协同思路,并通过独家调度策略把速度提了上来。
显存里存放的是最关键的内容:Router、共享专家、输出头以及KV Cache,剩余空间全部拿去填专家缓存,而且这个缓存会边聊边自适应——它会记住当前对话中哪些专家被调用最多,动态优化。
内存里常驻2万多个专家,显卡未命中的专家由CPU通过 AVX512 或 AVX2 指令集就地运算,两边同时计算。SSD则存放28.8G的N-gram查找表,这部分对速度要求不高,放在固态硬盘也不影响整体表现。
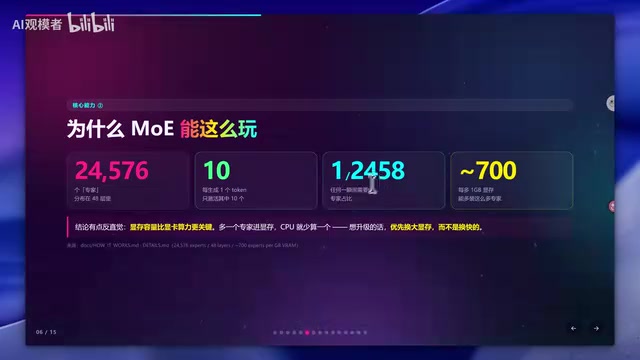
这套玩法之所以成立,根本原因在于 Qwen3.8 Flash 是MoE模型。它内部分了24576个专家、48层,但每生成一个token只激活其中约10个专家。换句话说,任何一瞬间需要的专家只占全部的极小部分,根本不需要全员进显存。
由此得出一个重要结论:在MoE架构下,显存容量比显卡算力更关键。每多一个专家进显存,CPU就少算一个。所以部署MoE大模型时,优先提升的应该是显存,而不是GPU算力。如果换成 Qwen3.8 27B 这类Dense模型,这套三层存储的玩法就行不通了。
MoE(Mixture of Experts,混合专家)是一种稀疏激活的神经网络架构。与传统的Dense(稠密)模型不同,MoE模型将前馈网络层拆分为大量独立的"专家"子网络,并由一个轻量的路由器(Router)在每次计算时决定调用哪几个专家。以Qwen3.8 Flash为例,它虽然总参数量达到176B,但每生成一个token时只有约10个专家被激活,实际参与计算的参数量远小于总量。这种设计使得模型在拥有超大总容量的同时,单步推理的计算量与小得多的Dense模型相当。正因如此,MoE模型天然适合"按需调度"的异构存储策略——绝大多数专家权重可以常驻在内存甚至SSD中,只有被路由器选中的少数专家才需要临时调入显存或由CPU计算,从而绕开显存容量的硬性限制。
MTP投机解码与长文本加速
除了整机协同,Strata还集成了MTP(Multi-Token Prediction)投机解码技术。这是一种嵌入模型内部的加速方案,而Strata实现的MTP命中率比普通推理框架高出不少,整体能带来1.6到1.8倍的提速。
长文本读取同样经过优化。在32K prompt输入下,Q2量化的读取速度可从572 token/s逐步提升到1290 token/s,Q3也能从383提升到1208 token/s。需要说明的是,这里的"读得快"指的是处理速度快,而非上下文容量无限。
投机解码(Speculative Decoding)是一种通过"先猜后验"来提升生成速度的推理加速技术。传统自回归生成每次只能输出一个token,而投机解码利用一个轻量的草稿模型(或内嵌的预测头)一次性猜测多个候选token,再由主模型并行验证其正确性——验证正确的部分直接采纳,验证失败的部分回退重生成。由于验证可以并行化而猜测成本很低,整体吞吐量得以大幅提升。MTP(Multi-Token Prediction)是DeepSeek广告等模型原生引入的一种变体,将多token预测头直接训练进模型权重中,命中率通常高于外挂草稿模型的方案。Strata利用了Qwen3.8 Flash模型本身内置的MTP结构,因此命中率比通用推理框架更高,最终实现了1.6到1.8倍的实测提速。
按硬件选量化档位
Strata会根据你的内存自动推荐量化档位,这对小白尤其友好。
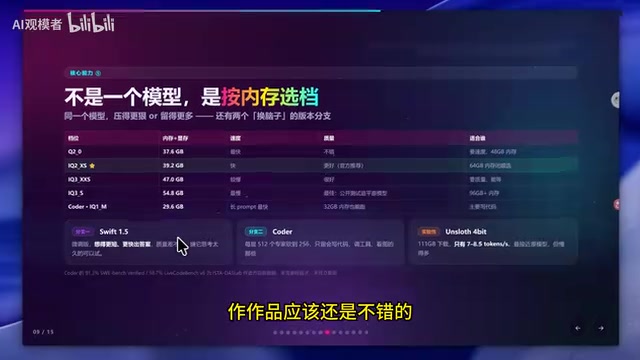
- 内存+显存仅37.6G:选Q2即可。在Qwen3.8这一代上,Q2量化已经达到可用标准,尤其配合优秀量化作者的成果。
- 接近40G:推荐 iQ2XS,带矩阵校准,性能更好,这也是官方推荐档位。
- 64G及以上:可直接选更高档位。
- 编程场景:项目单独提供了针对编程优化的 Coder IQ1 版本,即便只有32G内存也能达到可用状态。
项目还提供了多个分支,包括省思考长度的 Swift 1.5 后训练版本,以及原汁原味的原版量化。原版体量最大但性能最均衡,后训练版本则在省token的同时尽量不损失性能。
从作者实测数据看,5070 12G短聊天93 token/s、128K长上下文74 token/s;提高到 iQ3S 高量化档位后,短聊天53 token/s、长上下文46 token/s,同样完全够用。若换成24G显存的3090(哪怕落后两代),速度可达100到140 token/s;48G的4090体验会更好。
量化(Quantization)是将模型权重从高精度浮点数(如FP16/BF16,每个参数占2字节)压缩为低位整数表示的技术,目的是在尽量保留模型性能的前提下大幅缩减存储和显存占用。常见档位如Q2、Q3表示每个参数仅用2位或3位存储,相比原始FP16可节省8倍以上空间。iQ系列(如iQ2XS)是GGUF格式中的"重要性量化"变体,通过对不同权重层分配不同的量化精度并加入矩阵校准,在相同文件体积下比普通均匀量化保留更多模型性能。量化不可避免地引入精度损失,档位越低损失越大,但在MoE架构配合优秀量化作者的调校下,Q2在实际对话任务中的性能下降已被压缩到可接受范围内。
上手极简:扔给编程智能体就行
Strata最大的亮点之一是开箱即用。普通用户按照提示操作即可,而完全不懂的小白还有更省事的办法。
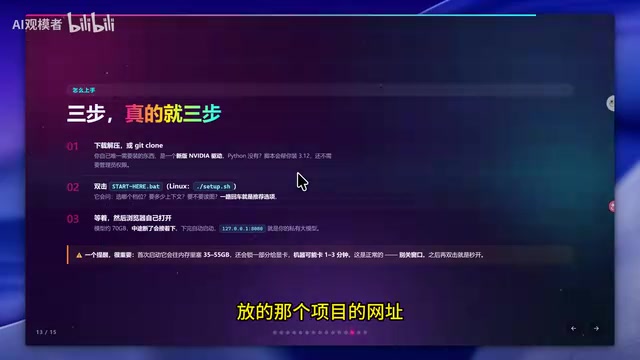
UP主给出的建议是:直接把项目网址丢给 Codex、Claude Code、Qwen Coder 这类编程智能体,让它自己帮你装好,你只需等着双击脚本运行即可。部署完成后浏览器会自动打开Web UI界面,可以方便地调整和查看模型状态。
必须认清的局限
这个项目并非万能魔法,仍有几点需要注意:
- 只能单请求处理:目前没有并发批处理。不过12G/16G显卡用户本身也不太会去搞多人并发,影响有限。
- 首条长消息要整段读完:比如30K token大约需要一分钟,之后转为增量处理,追问基本秒回。
- 部分功能处于实验性阶段:项目上线时间短,少数能力可能不太稳定。
写在最后
Strata证明了一件事:MoE大模型的实际门槛,很大程度上取决于调度是否精细。只要把整机资源调动好,配置较弱的机器也能扛住中大体量模型。
Qwen3.8 Flash Next 的性能确实能打,千问官方甚至把它放进订阅计划对外售卖API,而27B版本尚未单独出售。如今一张12G或16G显卡就能在本地跑起这个级别的模型,这在过去是不敢想象的事。对于想体验真·中大体量本地大模型的用户,Strata值得一试。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。