速度帖泛滥,社区需要怎样的推理性能分享?

社区速度帖只晒 tokens/s 却缺 KLD 等质量基准,透明分享才是正道。
文章由社区中泛滥的“300 t/s”推理速度截图切入,指出这类帖子往往只展示吞吐量,却省略了 KLD 质量基准、完整测试条件和复现方法。作者分析了贪婪解码、TAIL_SKIP、Q1_XXXS REAP 极端量化等常见提速手段:它们本身是合理的工程取舍,但组合起来刷出的漂亮数字若不加说明,容易误导经验不足的读者。文章主张有价值的性能分享应同时包含硬件配置、量化方案、解码参数、KLD 或困惑度等质量数据以及可复现脚本,让“快了多少”和“质量掉了多少”一起呈现,从而维护社区讨论的深度与可信度。
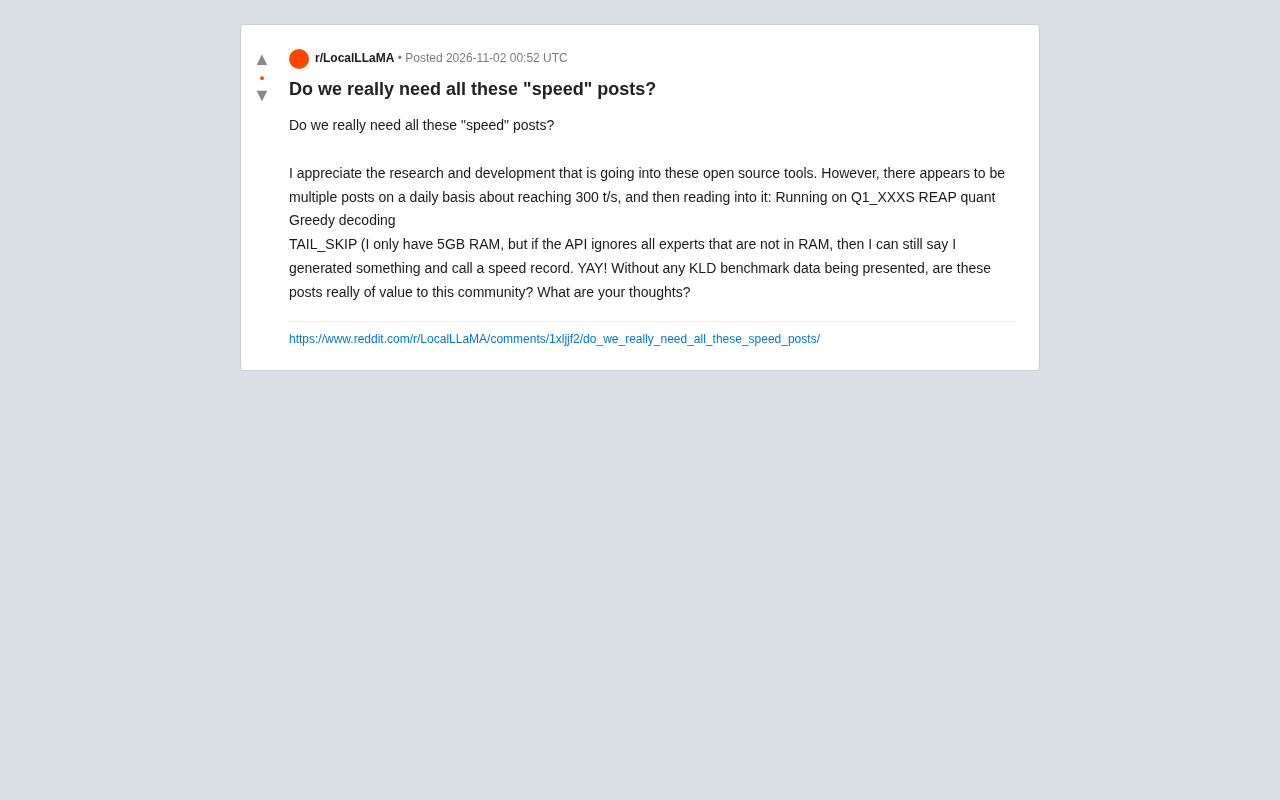
每天打开社区,总能看到有人晒出 300 t/s 的推理速度截图。这些帖子往往附带一长串参数:Q1_XXXS REAP 量化、贪婪解码、TAIL_SKIP 技巧。对于内存只有 5GB 的玩家来说,这看起来像是一场胜利——直到你发现,这些数字背后可能藏着不少水分。
速度帖的繁荣与隐忧
开源推理工具的进步有目共睹。从量化方案到专家卸载,社区开发者不断压榨硬件极限,让大模型在消费级设备上跑起来。但问题在于,当“速度”成为唯一的炫耀点,讨论就容易变味。
原帖作者提出了一个尖锐的质疑:如果一篇帖子只展示 tokens/s,却不提供 KLD(KL 散度)基准数据,那它到底有多少参考价值?KLD 衡量的是量化模型与原始模型输出分布的差异,是判断量化是否“伤质量”的关键指标。缺少这个数据,速度纪录就像没有刹车成绩的零百加速——快是快,但能不能安全上路是另一回事。
KLD(KL 散度) 全称 Kullback-Leibler Divergence,信息论中用来衡量两个概率分布差异的指标。在模型量化场景下,它通常计算为:让原始全精度模型和量化后模型对同一批文本分别输出下一个 token 的概率分布,再求这两个分布之间的 KL 散度,最后对整个数据集取平均。数值越低,说明量化模型的行为越接近原模型;一般认为平均 KLD 在 0.1 以下时质量损失较小,超过 0.5 则可能明显退化。相比困惑度(perplexity),KLD 对分布形状的变化更敏感,因此成为量化社区(如 llama.cpp 的量化讨论)中判断“量化是否伤质量”的常用基准。不过 KLD 也有局限:它依赖参考模型和校准数据集的选择,不同实验之间的数值不能直接横向比较。
那些“聪明”的加速技巧
仔细看这些速度帖的配置,你会发现一些共同点:
- 贪婪解码:不采样,直接选概率最高的 token。这确实能提速,但输出多样性大打折扣,实际体验和评测场景可能天差地别。
- TAIL_SKIP:跳过部分计算步骤。原帖作者调侃说,自己只有 5GB 内存,但如果 API 忽略所有不在内存中的专家,那也能“生成点什么”并宣称打破纪录。
- 极端量化:Q1_XXXS REAP 这类量化把模型压到极低比特,速度上去了,但质量损失往往没有量化评估。
这些技巧本身不是错,工程上各有用途。问题在于,当它们被组合起来刷出一个漂亮数字,却不说明代价,就容易误导社区里经验不足的读者。
贪婪解码(greedy decoding) 是解码策略中最简单的一种:每一步都直接选取概率最高的 token,不做随机采样,因此结果完全确定、可复现,速度也略快于采样。但它有两个明显代价:一是输出缺乏多样性,同一提示词永远得到相同回答,容易陷入重复循环;二是它并不等同于“更准确”,在开放式生成任务中,贪婪解码的表现常常不如温度采样或 beam search。评测时使用贪婪解码,相当于把模型能力压缩到一条确定性路径上,得到的分数与实际交互体验可能存在偏差。此外,贪婪解码会掩盖采样参数(temperature、top-p)带来的质量波动,使速度对比失去一部分可比性。
TAIL_SKIP 并非某个标准化的学术术语,而是社区中对一类“跳过部分计算”优化技巧的俗称,常见于混合专家(MoE)模型的推理实现中。其思路是:当某些专家权重不在显存或内存中时,不再等待加载,而是直接跳过这些专家的计算,用剩余专家完成前向传播。这在内存极度受限的设备上确实能让推理“跑起来”,但代价是输出与完整模型产生偏差,且偏差大小随跳过比例上升而急剧增加。类似的技巧还包括只计算部分层、提前退出等。它们属于工程上的取舍手段,本身有其适用场景,但如果在性能报告中不注明跳过比例和对应质量损失,读者就无法判断这个速度数字的真实含义。
社区需要怎样的性能分享?
原帖的讨论指向一个核心诉求:透明。一份有价值的性能报告,至少应该包含:
- 完整的测试条件:硬件配置、量化方案、解码参数、使用的提示词或数据集。
- 质量基准:KLD 数据、困惑度(perplexity)或下游任务准确率,证明速度不是靠牺牲质量换来的。
- 可复现性:别人能不能用同样的配置跑出相近的结果。
这并不是要否定速度优化的价值。恰恰相反,只有把“快了多少”和“质量掉了多少”放在一起看,社区才能判断一项技术是否真正值得采用。单纯刷数字的帖子多了,反而会稀释真正有深度的技术讨论。
结语
开源推理工具的进步值得喝彩,但社区的注意力是稀缺资源。与其每天发一张 300 t/s 的截图,不如多花几分钟附上 KLD 曲线和复现脚本。速度纪录可以吸引眼球,但只有透明的数据才能赢得信任。
你觉得呢?欢迎在评论区分享你的看法。
背景补充
理解这类讨论还需要区分几个常被混用的指标。tokens/s 衡量的是吞吐量,即单位时间生成的 token 数,它受硬件、批大小、量化精度、上下文长度等多重因素影响,脱离配置谈速度没有意义。困惑度(perplexity) 是语言模型对测试文本的负对数似然的指数,数值越低表示模型越“不意外”,但它对量化造成的分布偏移不如 KLD 敏感。下游任务准确率 则直接反映模型在具体任务上的表现,最贴近实际体验,但评测成本高、覆盖有限。三者的关系是:速度决定可用性,KLD 和困惑度反映质量风险,下游准确率验证真实效果。一份可信的性能报告应当同时给出速度与至少一项质量指标,并说明测试所用的上下文长度和批大小,否则数字之间无法比较。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。