Superpowers:狂揽31万星的AI编程方法论

Superpowers用强制技能工作流让AI先想清楚再写代码,GitHub获31万星。
Superpowers是一个在GitHub上收获超31万星、2.7万fork的开源AI编程方法论项目,用Shell编写并遵循MIT许可。它针对大多数AI编程工具“一句话直接吐代码”导致的返工问题,把沟通与拆解前置,以“技能”形式固化为一套强制工作流:brainstorming在任何代码写出前激活,通过复述理解让开发者纠正需求偏差;writing plan把方案拆成标注文件路径和验证步骤的字节级任务;subagent-driven development为每个任务派发全新代理,保证上下文干净;Code Review则对照计划检查产出,使计划成为客观验收基准。其核心洞察是让AI写得更对而非更快。
AI写代码早已不稀奇,难的是让AI在写代码之前先想清楚要做什么。一个名为Superpowers的开源项目,用一套强制性的工作流把这件事做到了极致——它在GitHub上收获了超过31万颗星和2.7万次fork,用Shell编写,遵循MIT许可。
它到底解决什么问题
大多数AI编程工具的默认姿势是:你给一句需求,它直接吐代码。结果是代码也许能跑,但和你想的不是一回事,返工成本高。Superpowers的思路是把“沟通”和“拆解”前置,逼AI在动手前先和你对齐。这套方法论以“技能(skill)”的形式组织,每个技能负责流程中的一个阶段,环环相扣。
据YouTube频道的介绍,它的完整链路依次是:头脑风暴 → 写计划 → 子代理驱动开发 → 代码审查。值得逐个拆开看。
第一步:头脑风暴,先别写代码
Superpowers的第一个技能叫brainstorming,在任何代码被写出来之前就会激活。它会主动问你:你到底想构建什么?
关键设计在于“复述”:它不会听完就埋头干活,而是把自己的理解反射回给你,让你有机会纠正偏差。这个看似简单的动作,实际上把需求歧义消灭在了最便宜的阶段——改一段描述,远比改一堆代码便宜。
对开发者来说,这相当于AI替你当了一次产品经理,逼你把模糊的想法说具体。
第二步:写计划,拆到“字节级任务”
设计被确认后,writing plan技能接手,把方案拆成一粒一粒的小任务。每个任务都标明确切的文件路径和清晰的验证步骤。
这一步的价值在于可执行性。传统AI编程里,“帮我实现登录功能”这种粒度会让模型自由发挥,结果不可控。而拆到“改哪个文件的哪一段、怎么验证改对了”的粒度,AI的自由度被收窄,可预测性大幅提升。验证步骤内置在计划里,也意味着每个任务自带验收标准。
第三步:子代理驱动开发
计划获批后,subagent-driven development登场:每一个任务都派发给一个全新的代理去执行。
“每个任务一个新鲜代理”是个有意思的选择。长期对话的上下文会越滚越脏,早期信息干扰后期判断;而每个代理只面对一个边界清晰的小任务,上下文干净,注意力集中。这相当于把一个大工程切给一群各管一摊的工人,而不是让一个人扛完所有活。
与此配合的是Code Review环节——它先拿每个任务的产出对照计划检查,而不是脱离计划自由评审。计划成了唯一的验收基准,评审也就有了客观依据。
子代理(Subagent) 指的是由主代理派生出的、拥有独立上下文窗口的从属代理实例。在主流 AI 代理框架中,主代理负责任务编排与状态维护,子代理则专注于执行某个具体子任务并返回结果。由于子代理不共享主对话的历史消息,它的上下文是“干净”的,这正好避免了长对话中常见的上下文污染与注意力稀释问题。代价是子代理缺少全局视野,因此必须依赖足够详尽的任务描述和验收标准——这也是前一步“字节级任务拆解”成为必要前提的原因。子代理返回后,主代理负责汇总、校验并决定下一步动作,形成“编排-执行-校验”的闭环。
安装:一条命令的事
安装方式取决于你用的代理工具。据视频介绍,Clawed Code可以通过官方插件市场用一条命令装好,其他受支持的工具也走类似路径。项目在GitHub上的地址是abra/superpowers,同样支持一条插件命令安装。
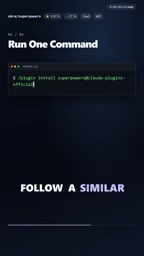
低门槛安装加上MIT许可,是它能在开源社区快速扩散的重要原因——31万星和2.7万fork的数字,本身就说明了开发者对这套流程的认可。
文中提到的“技能(skill)”可以理解为一种可被代理自动调用的结构化提示词包:它通常包含触发条件、执行步骤、输入输出约定以及检查清单,以文件形式存放在项目仓库中。与普通提示词不同,技能强调何时激活与按序执行,代理在识别到当前任务阶段后加载对应技能,从而把一套方法论固化为可复用的流程单元。这种组织方式的优势在于可组合、可版本管理、可被社区贡献和审查,也便于针对不同代理工具做适配,而不必把全部逻辑塞进一段超长系统提示里。
为什么这套方法论值得关注
Superpowers的核心洞察不是让AI写得更快,而是让AI写得更对。它把软件工程里被反复验证的实践——需求澄清、任务拆解、代码评审——搬进了AI协作流程,并用技能的形式固化成强制步骤。
对于习惯“一句话生成整个应用”的开发者,这套流程初看会觉得啰嗦;但当你被AI的自由发挥坑过几次之后,就会明白前置对齐和细粒度计划的性价比。视频结尾抛出的问题也很实在:你会先试哪个技能?如果只能选一个,brainstorming大概是最值得先体验的。
相关推荐

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。

2B参数模型本地跑音频与视觉:LFM3实测揭秘
海外博主在 MacBook Air 上实测 Liquid AI 的 LFM3 Audio 2B 与 Omni 2B:2B 参数离线跑语音与视觉,工具调用超预期,但噪声转录与幻觉问题明显。