Swift1.5-Qwen3.8-Flash-Next实测:推理提速60%,质量几乎无损
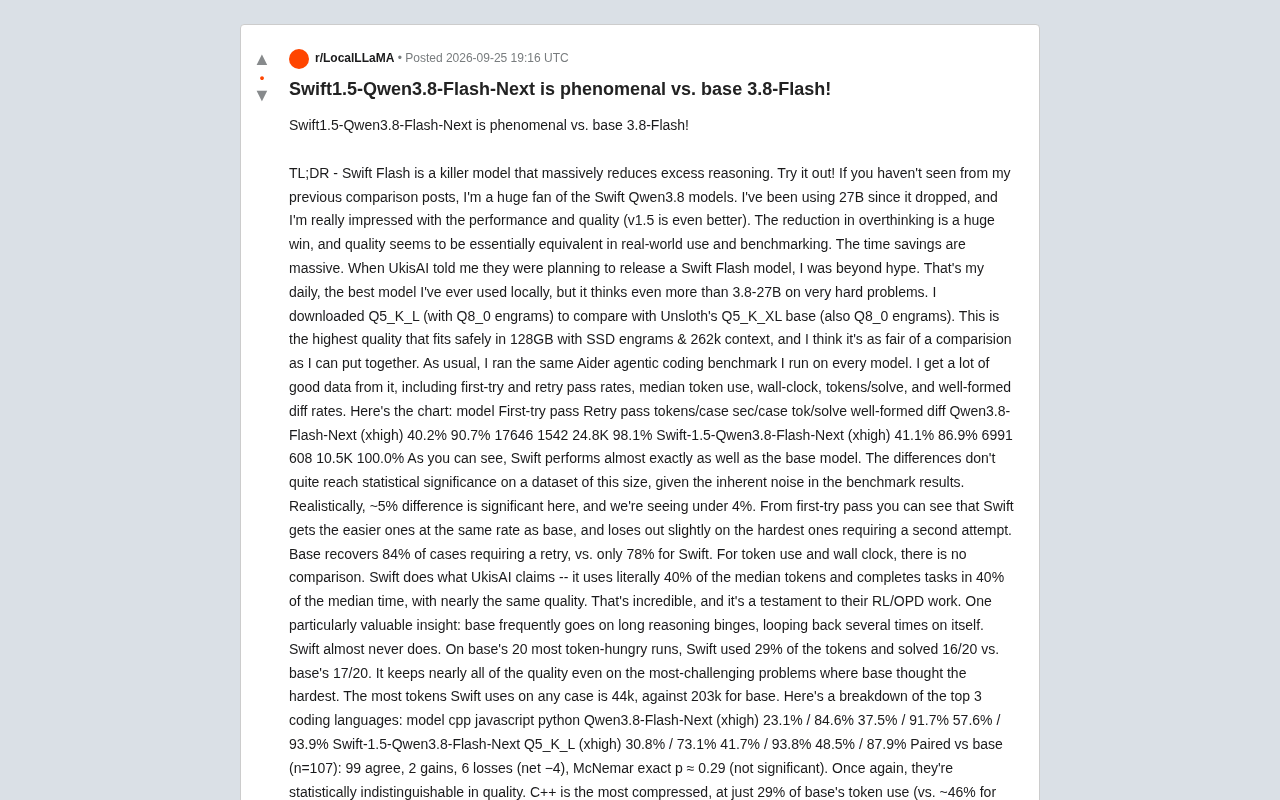
Swift-1.5版Qwen3.8-Flash通过RL优化削减过度推理,token用量和耗时压缩至基础版40%,质量几乎不变。
Swift-1.5-Qwen3.8-Flash-Next是UkisAI团队通过强化学习优化推理行为的产物,旨在解决本地思维链模型"想太多"的通病。一位Reddit用户用Aider智能体编程基准对其与基础版进行了系统对比,结果显示:Swift版中位token消耗和墙钟时间均仅为基础版的40%,首次通过率(41.1%)甚至略高,重试通过率略低(86.9% vs 90.7%),但差距未达统计显著。在极端费token的20个案例中,Swift仅用29%的token即解出16/20题,单案例最高token上限为44K,远低于基础版的203K。C++语言下压缩最激进,也带来了最多的质量损失,值得重度C++开发者注意。整体结论是"质量统计上难以区分,效率提升显著",为本地部署用户提供了一条实用的提速路径。
本地大模型社区近日热议的Swift-1.5-Qwen3.8-Flash-Next,凭借对"过度推理"的大幅削减引发关注。一位长期使用Swift系列模型的Reddit用户,用一套Aider智能体编程基准对它与基础版Qwen3.8-Flash-Next做了系统对比,结论相当鲜明:Swift版在保持几乎同等质量的前提下,把推理token消耗和耗时都压缩到了原来的40%左右。
核心结论:更少思考,同等质量
Swift版本最大的卖点是解决了本地推理模型的通病——"想太多"。基础版Qwen3.8-Flash虽然是这位测试者眼中"本地跑过最好的模型",但在遇到难题时会反复陷入冗长的推理循环,甚至比更大参数量的27B版本还啰嗦。
Swift-1.5正是针对这一点做了强化学习优化。从整体基准数据看,两者的通过率几乎持平:
| 模型 | 首次通过 | 重试通过 | tokens/案例 | 秒/案例 | tokens/解 | 有效diff率 |
|---|---|---|---|---|---|---|
| Qwen3.8-Flash-Next (xhigh) | 40.2% | 90.7% | 17646 | 1542 | 24.8K | 98.1% |
| Swift-1.5-Flash-Next (xhigh) | 41.1% | 86.9% | 6991 | 608 | 10.5K | 100.0% |
首次通过率上,Swift(41.1%)甚至略高于基础版(40.2%),说明简单任务两者水平相当。差距主要出现在需要二次尝试的最难题目上——基础版能挽回84%的重试案例,Swift为78%。但测试者强调,在这个规模的数据集上,考虑到基准本身的噪声,只有约5%以上的差异才具备统计意义,而实际差距不足4%,尚未达到显著水平。
Swift系列模型由UkisAI团队基于强化学习(Reinforcement Learning,RL)训练而来,核心思路是对推理模型的"思考链"(Chain-of-Thought)长度施加惩罚信号,引导模型在不损失答案正确率的前提下缩短内部推理步骤。这与蒸馏或量化等压缩手段有本质区别:蒸馏和量化针对模型权重本身,而Swift的优化发生在推理行为层面——模型参数量不变,但"想多久"的习惯被重新塑造。"过度推理"(overthinking)是当前思维链模型的常见问题:模型会在已经得出正确方向后继续自我质疑、反复验证,产生大量对最终答案贡献极小的冗余token,拖慢响应速度并消耗更多上下文窗口。
效率提升才是真正的杀手锏
如果说质量是打平,那效率就是碾压。Swift的中位token使用量仅为基础版的40%,任务完成的墙钟时间同样只有40%。这意味着同样的编程任务,本地部署时能省下超过一半的等待时间。
更能说明问题的是极端案例的表现。测试者挑出基础版消耗token最多的20次运行做对比:Swift只用了其中29%的token,却依然解出了16题,与基础版的17题几乎持平。换句话说,即便在模型"最费脑"的硬骨头上,Swift也几乎不掉队。
最直观的一个数字是token上限:Swift在任何单个案例上最多用44K token,而基础版最高飙到了203K。这种量级的差异,对于显存和上下文长度都吃紧的本地部署场景意义重大。
分语言表现:C++需要留意
测试者进一步拆分了C++、JavaScript、Python三种主流语言的表现:
| 模型 | C++ | JavaScript | Python |
|---|---|---|---|
| Qwen3.8-Flash-Next | 23.1% / 84.6% | 37.5% / 91.7% | 57.6% / 93.9% |
| Swift-1.5-Flash-Next Q5_K_L | 30.8% / 73.1% | 41.7% / 93.8% | 48.5% / 87.9% |
JavaScript和Python上,Swift的token压缩约为基础版的46%,质量基本持平。C++则是压缩最狠的语言,token用量仅为基础版的29%,但代价是6次质量损失中占了3次。
从配对统计看(n=107):99例结果一致,2例Swift更优,6例更差,净差-4,McNemar精确检验p≈0.29,同样未达显著。整体结论是两者质量"统计上难以区分"。不过对于重度C++开发者,这个压缩幅度带来的质量波动值得警惕——可以适当放宽推理预算以求稳。
测试条件与可复现性
为保证公平对比,测试者选用了能在128GB内存中安全容纳、并支持262K上下文的最高质量量化配置:Swift版为Q5_K_L(Q8_0 engrams),基础版为Unsloth的Q5_K_XL(同样Q8_0 engrams),均使用SSD存放engrams。两者都跑同一套Aider智能体编程基准,采集首次/重试通过率、中位token、墙钟时间、每解token数以及有效diff率等多维指标。
这套评测方法论的价值在于它不只看"对不对",还看"多快、多省",对本地部署用户尤其实用。有效diff率上Swift达到了100%,意味着它生成的代码补丁格式完全规范,这对智能体自动应用改动的可靠性是加分项。
Aider智能体编程基准(Aider Polyglot Benchmark)是一套专为评估LLM代码编辑能力设计的基准,测试模型在真实代码库中完成"读取现有代码 → 理解需求 → 生成合法diff补丁"的全流程。与单纯的代码生成题不同,它要求模型输出格式严格符合unified diff规范,以便Aider工具能自动将修改应用到文件中——这就是"有效diff率"指标的由来。Q5_K_L与Q5_K_XL均属于GGUF量化格式中的混合精度方案:Q5_K表示大部分权重以5-bit存储,_L/_XL后缀则表示注意力层(attention engrams)保留了更高精度(Q8_0),在压缩率与精度之间取得平衡。这类配置在128GB统一内存的Apple Silicon机器上可完整容纳8B级别模型并支持超长上下文。
对本地模型用户意味着什么
Swift-1.5-Qwen3.8-Flash-Next的实测结果,印证了UkisAI团队在RL和推理路径优化上的宣传并非虚言。对于把大模型跑在本地的开发者而言,"质量不变、速度翻倍、token减半"几乎是理想中的升级路径——它直接缓解了本地推理最痛的延迟与资源占用问题。
当然,这终究是单一用户在特定基准下的测试,数据集规模有限,多项差异未达统计显著。C++场景的质量波动也提醒我们,激进的推理压缩并非在所有任务上都零成本。但从趋势看,通过训练手段削减无效推理、而非单纯堆参数,正在成为提升本地模型实用性的重要方向。对追求效率的本地部署者来说,Swift系列值得一试。
相关推荐
Jev从Agent框架到Computer Use的转向实践
Jev从Agent框架到Computer Use的转向实践
Jev最初为AI Agent设计,团队却将其转向Computer Use场景。本文分析Agent框架与计算机操作自动化的技术关联及对开发者的启示。
Show HN 项目 Jevgpt:素材不足的观察记录
Hacker News 上的 Show HN 项目 Jevgpt 以"用另一个轮子重新发明轮子"自嘲命名,暗示与 GPT 类 AI 工具相关。本文梳理目前有限的公开信息与待观察要点。
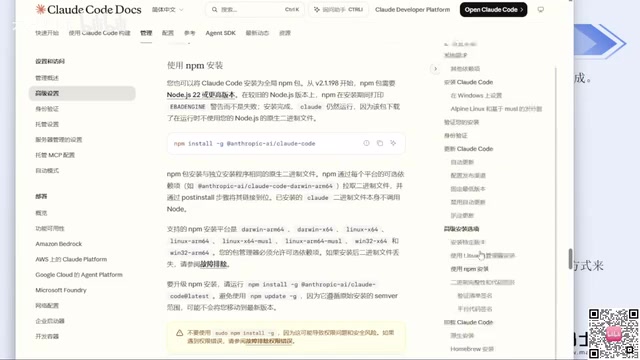
Claude Code入门实战:安装配置与防封号完整指南
Claude Code 保姆级入门教程:涵盖 NPM 安装配置、Node.js 与 Git 前置准备,重点讲解如何用 CC Switch 绕过账号登录规避封号风险,以及权限模式等核心技巧,帮助国内程序员高效上手 AI 编程工具。