AI搜索+1350款开源软件目录:付费应用替代方案一键查找
为付费软件寻找开源替代的痛点
对于许多开发者和技术爱好者来说,寻找付费应用的开源替代品几乎是一种日常需求。然而,这个过程往往比想象中更加繁琐——你需要翻阅各种论坛推荐列表、GitHub 仓库、社区讨论,逐一比对功能、活跃度和部署方式。信息分散且质量参差不齐,让整个搜寻过程变得相当耗时。
这种困境的根源在于开源软件生态的碎片化特征。截至 2024 年,GitHub 上托管的公开仓库已超过 3 亿个,但其中真正活跃且具备生产可用性的项目只占极小比例。开源软件的碎片化不仅体现在数量上,更体现在分发渠道的分散性。与商业软件有统一的应用商店和营销渠道不同,开源项目散落在 GitHub、GitLab、SourceForge、Codeberg 等多个代码托管平台上,有些甚至只在开发者个人网站上发布。传统的开源替代品推荐渠道——如 AlternativeTo(成立于 2009 年,依赖用户投票和标签系统)、Awesome Lists(GitHub 上由社区维护的分类清单,遵循特定格式规范)、Hacker News 讨论帖——虽然各有优势,但都存在信息更新滞后、缺乏结构化数据、主观评价偏差等问题。这些渠道各自解决了发现问题的一个切面,但都无法提供完整的评估视角。用户往往需要在多个信息源之间反复跳转,才能对一款开源工具形成全面判断。这种信息不对称导致了一个悖论:优秀的开源替代品可能已经存在,但潜在用户根本不知道它的存在。
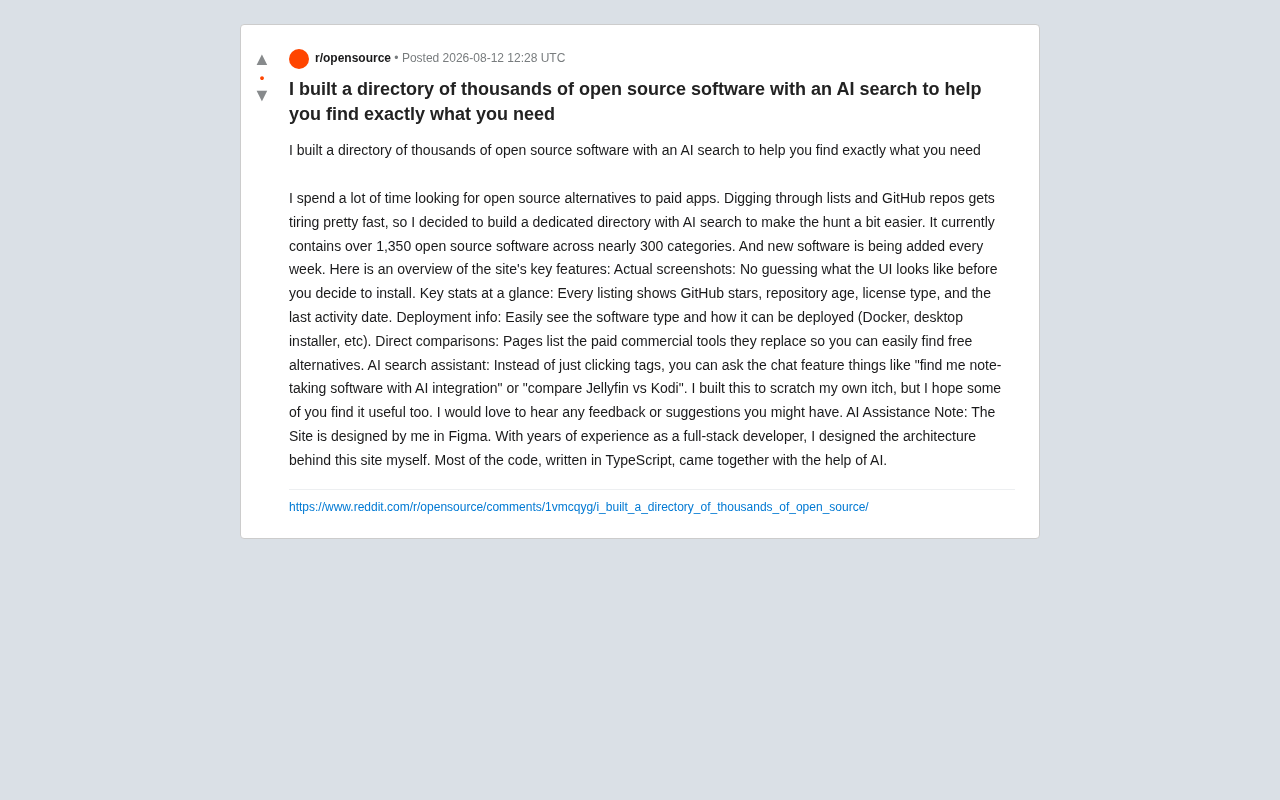
正是基于这样的痛点,一位拥有多年经验的全栈开发者在 Reddit 上分享了他的最新项目:一个专门收录开源软件的目录网站,并集成了 AI 搜索助手。据其介绍,该目录目前已经收录了超过 1350 款开源软件,覆盖近 300 个分类,并且每周都在持续增加新的条目。
核心功能:不只是一个链接列表
与传统的"开源替代品清单"不同,这个目录在信息呈现上做了不少精细化设计,试图解决"找到软件后仍需大量二次调研"的问题。
真实截图与关键数据一目了然
作者强调,每个软件条目都配有真实的界面截图,用户无需在安装前对 UI 效果进行猜测。这一点对于评估软件的成熟度和使用体验相当实用——许多开源项目虽然功能强大,但界面设计粗糙,而另一些项目则在 UI/UX 上已经达到甚至超越了商业软件的水平。真实截图让用户在投入安装和配置时间之前,就能直观感受到软件的设计品质。
除此之外,每条记录都会在显眼位置展示一系列关键数据:
- GitHub Stars:反映项目的社区认可度
- 仓库年龄:判断项目的成熟程度
- 许可证类型:帮助用户确认使用与商用的合规性
- 最后活跃日期:评估开源项目是否仍在维护的关键指标
这些数据的集中呈现,帮助用户快速过滤掉那些已经停止维护或社区冷清的项目,避免在已废弃的项目上浪费时间。
GitHub Stars 与开源项目健康度评估
GitHub Stars 是开源社区中最直观的人气指标,代表着有多少开发者将项目加入收藏。虽然 Star 数不能完全等同于代码质量,但它确实反映了项目的关注度和影响力。一般来说,超过 1000 Stars 的项目通常意味着有一定的用户基础,5000+ Stars 则表明项目在特定领域已具备较高认可度,而超过 50000 Stars 的项目(如 VS Code、Next.js、Docker)已经属于行业基础设施级别的存在。
然而,评估开源项目健康度还需要结合其他指标:Fork 数反映开发者参与度,Issue 响应速度体现维护者的活跃程度,Commit 频率则显示项目的开发节奏。近年来,一些项目通过买 Star 等方式刷数据,甚至出现了专门的「Star as a Service」灰色产业,因此需要综合多个维度判断项目真实状况。开源社区为此发展出了更科学的评估体系——Linux 基金会旗下的 CHAOSS(Community Health Analytics for Open Source Software)项目定义了一整套标准化指标,涵盖社区多样性、响应速度、代码审查效率等多个维度。
对于企业级应用,还需关注项目的贡献者分布——如果核心代码由单一开发者维护(即所谓的"Bus Factor = 1"问题),存在较高的维护风险。历史上,OpenSSL 的 Heartbleed 漏洞和 Log4j 的 Log4Shell 漏洞都暴露了关键开源项目维护资源不足的系统性问题,促使业界更加重视开源供应链安全。
开源许可证:从 MIT 到 GPL 的选择困境
开源许可证决定了软件的使用、修改和分发权利,是开源软件合规使用的法律基础。最宽松的 MIT 和 Apache 2.0 许可证允许商业使用和闭源修改,适合企业集成;GPL(GNU General Public License)系列则要求衍生作品也必须开源,被称为"Copyleft"("病毒式")许可证,这使得许多商业公司对 GPL 项目保持警惕。
近年来流行的 AGPL(Affero GPL)更进一步,即使通过网络提供服务也要求开源,这对 SaaS 公司构成挑战——正是 AGPL 的存在,促使 AWS 等云厂商在使用开源数据库时不得不重新审视其商业模式。还有一些项目采用双重许可策略:社区版使用 GPL,商业版则提供专有许可,MySQL、Qt 等知名项目都采用了这一模式。Mozilla Public License(MPL)则在两者之间取得平衡,只要求修改部分开源。
值得关注的是近年来涌现的新型许可证浪潮。MongoDB 于 2018 年从 AGPL 切换到自创的 SSPL(Server Side Public License),Elastic 于 2021 年将 Elasticsearch 从 Apache 2.0 更改为 SSPL 和 Elastic License 双许可,HashiCorp 于 2023 年将 Terraform 从 MPL 更改为 BSL(Business Source License)。这些变更都引发了社区激烈争议,甚至催生了分叉项目——OpenSearch 就是 Amazon 对 Elasticsearch 许可证变更的回应,OpenTofu 则是社区对 Terraform 变更的抗议。OSI(开源倡议组织)明确表示 SSPL 和 BSL 不符合开源定义,这些许可证变更实质上是商业公司在开源价值捕获与社区信任之间的艰难博弈。
选择错误的许可证可能导致法律纠纷,2022 年就有多起因违反 GPL 而被诉讼的案例,因此在引入开源组件前务必仔细审查其许可证条款。企业中通常需要借助 FOSSA、Snyk 等软件组成分析(SCA)工具自动化扫描许可证合规性。
部署信息与商业软件对标
目录还清晰标注了每款软件的类型及其部署方式,例如是否支持 Docker、是否提供桌面安装包等。对于自托管(self-hosted)爱好者而言,这类信息往往决定了一个工具是否值得尝试。
Self-hosted 与 Docker:开源部署的技术门槛
Self-hosted(自托管)是指用户在自己的服务器上部署和运行软件,而非依赖第三方云服务。这种模式的核心优势是数据完全由用户掌控,避免了隐私泄露和供应商锁定风险。在 GDPR 等数据保护法规日趋严格的背景下,以及近年来多起 SaaS 服务突然关停(如 Google 关闭多项服务、Notion 调整定价策略)的事件催化下,自托管运动正在经历一波显著增长。Reddit 上的 r/selfhosted 社区已拥有超过 35 万成员,成为交流自托管经验的核心阵地。
Docker 的出现极大降低了自托管的技术门槛——通过容器化技术,开发者可以将应用及其依赖环境打包成标准化的镜像,用户只需一条 docker run 命令即可启动服务,无需处理复杂的依赖安装和环境配置。Docker 的核心理念源于 Linux 内核的 cgroups 和 namespace 技术,它将进程隔离在独立的容器中运行,每个容器拥有自己的文件系统、网络和进程空间,但共享宿主机的内核,因此比传统虚拟机轻量得多——容器通常在毫秒级启动,内存开销仅为虚拟机的几分之一。Docker Compose 更进一步简化了多容器应用的部署,通过一个 YAML 文件定义整个技术栈——例如一个典型的博客系统可能包含 Web 应用、数据库和反向代理三个容器,Docker Compose 让它们的编排变得声明式且可复现。
然而,自托管也意味着用户需要承担服务器维护、安全更新、备份恢复等责任。近年来出现的 Kubernetes 适合更大规模的部署,但其学习曲线陡峭,被戏称为"YAML 工程"。对于个人用户,Portainer、CasaOS 等可视化管理工具提供了更友好的入口,让非专业人士也能享受自托管的好处。更近一步,Coolify、Dokploy 等新兴项目试图打造"自托管版的 Vercel/Heroku",让用户通过简单的 Web 界面即可一键部署 GitHub 仓库中的应用,将自托管的技术门槛降到了前所未有的低点。
更具实用价值的是直接对标功能——每个页面都会列出该开源软件所能替代的付费商业工具。这意味着,当你想摆脱某款订阅制软件时,可以直接反向查找它的开源替代方案,大大降低了搜寻门槛。这种设计精准击中了"订阅疲劳"(Subscription Fatigue)这一日益普遍的用户痛点。订阅疲劳是近年来 SaaS 行业面临的一个显著趋势反弹——2010 年代,软件行业大规模从一次性购买转向订阅模式,这为软件公司带来了可预测的经常性收入(ARR),但也让用户的累积支出不断攀升。据 Gartner 数据,全球企业在 SaaS 上的年支出在 2023 年已超过 1970 亿美元。对个人用户而言,从创意工具(Adobe Creative Cloud 约 $55/月)、笔记应用(Notion 约 $10/月)、密码管理器(1Password 约 $3/月)到云存储(Dropbox 约 $12/月),月度订阅开支很容易突破 $100。这种经济压力催生了对开源自托管方案的需求增长——用户愿意用技术投入换取经济自由和数据主权。一些社区甚至发展出了完整的"去订阅化"(De-SaaS-ification)运动,致力于为每一款主流 SaaS 工具找到可自托管的替代方案。
AI 搜索助手:用自然语言找到合适的开源工具
这个项目最大的亮点,在于其内置的 AI 搜索助手。传统目录网站通常只能通过点击标签或分类进行筛选,而这里用户可以直接用自然语言提出需求。
作者举了两个典型使用场景:
- "帮我找一款带 AI 集成的笔记软件"
- "对比一下 Jellyfin 和 Kodi"
这种交互方式的转变,本质上是把"检索"升级为"咨询"。用户不再需要预先知道正确的分类名称或关键词,而是可以像与人对话一样描述自己的模糊需求,由 AI 来理解意图并给出精准推荐或横向对比。对于开源软件这种品类繁多、命名各异的领域来说,AI 搜索的价值尤为突出。
自然语言搜索与向量数据库技术
传统搜索引擎依赖关键词匹配和布尔逻辑,而基于 AI 的自然语言搜索通过理解语义来检索内容。其核心技术是 Embedding(向量嵌入)——将文本转换为高维空间中的数字向量,语义相近的文本在向量空间中距离更近。例如,"笔记应用"和"知识管理工具"在传统关键词搜索中毫无关联,但在向量空间中它们的距离会非常接近。这一技术的理论根基可以追溯到 2013 年 Google 发布的 Word2Vec 模型,但真正让向量搜索走向大规模应用的是 2017 年 Transformer 架构的出现——以 BERT、GPT 为代表的预训练语言模型能够生成包含丰富上下文语义的文本向量,使得语义理解的精度发生了质的飞跃。
当用户输入"带 AI 集成的笔记软件"时,系统会将查询转换为向量,然后在向量数据库(如 Pinecone、Weaviate、Qdrant、Milvus)中进行相似度搜索(通常使用余弦相似度或欧几里得距离),返回语义最接近的结果。这些向量数据库采用了近似最近邻(ANN)搜索算法,如 HNSW(Hierarchical Navigable Small World)或 IVF(Inverted File Index),能在亿级向量数据中以毫秒级延迟完成搜索——这种近似算法牺牲了极少量精度,但将搜索复杂度从线性降至对数级别。这种方式能够理解同义词、上下文和隐含意图,即使用户不知道准确的技术术语也能找到相关内容。
在实际工程中,纯向量搜索存在"精确匹配"能力不足的问题——例如用户搜索特定项目名称"Obsidian"时,传统关键词搜索反而更精准。因此业界普遍采用混合搜索(Hybrid Search)策略,将向量检索与传统 BM25 关键词检索结合,再通过重排序模型(Reranker,如 Cohere Rerank、bge-reranker)对初步结果进行二次排序,以兼顾语义理解和精确匹配。
大型语言模型(LLM)如 GPT、Claude 的接入使得系统不仅能检索,还能进行推理和对比分析——这正是"对比 Jellyfin 和 Kodi"这类查询的技术基础。实现这类功能通常需要采用 RAG(Retrieval-Augmented Generation,检索增强生成)架构:先从向量数据库中检索相关文档片段,再将其作为上下文注入 LLM 的提示词中,让模型基于真实数据生成回答,而非仅依赖预训练知识。RAG 架构解决了 LLM 的两大核心问题:一是知识截止日期导致的信息过时,二是"幻觉"(Hallucination)问题——即模型在缺乏真实数据时会编造看似合理但实际错误的信息。通过将检索到的真实数据作为上下文提供给模型,RAG 大幅提升了回答的准确性和可靠性。LangChain、LlamaIndex 等框架简化了这一流程的开发。成本方面,向量化和 LLM 调用的计算开销远高于传统搜索,但用户体验的质的飞跃使其成为现代内容平台的标配。
AI 辅助开发:一个人如何完成千级规模的内容产品
值得一提的是,作者在分享中主动披露了这个项目的开发方式,这本身也是当下软件开发趋势的一个缩影。
他表示,网站的整体设计由自己在 Figma 中完成,背后的架构也依托其多年的全栈开发经验独立设计。Figma 是一款基于浏览器的协作设计工具,2016 年正式发布后迅速颠覆了由 Sketch 和 Adobe XD 主导的 UI 设计工具市场。其核心创新在于实时多人协作和云端优先的架构——设计文件无需本地保存和手动同步,多名设计师可以同时编辑同一个画布。2022 年 Adobe 宣布以 200 亿美元收购 Figma,但该交易最终因反垄断审查未能通过。对于独立开发者而言,Figma 的免费层级功能已足够完成产品设计,其组件系统和自动布局功能让设计到开发的交接更加顺畅。值得一提的是,Figma 本身也面临开源替代品的挑战——Penpot 是目前最知名的开源设计工具,由西班牙公司 Kaleidos 开发,基于 SVG 标准构建。
而在具体的代码实现层面——主要使用 TypeScript 编写——则大量借助了 AI 的协助完成。
TypeScript 在全栈开发中的地位
TypeScript 是 JavaScript 的超集,通过添加静态类型系统解决了 JavaScript 在大型项目中类型不安全、难以重构、IDE 支持有限等可维护性问题。自 2012 年由微软的 Anders Hejlsberg(同时也是 C# 和 Delphi 的创造者)发布以来,TypeScript 已成为现代前端开发的事实标准——根据 Stack Overflow 2023 年调查,超过 38% 的专业开发者使用 TypeScript,在 GitHub 语言排名中位列前五。
其核心优势在于编译时类型检查,能在代码运行前发现大量潜在错误,IDE 的智能提示也更加精准——这对于 AI 辅助编程尤为重要,因为类型信息为 AI 代码生成提供了更丰富的上下文,使生成的代码更准确。在全栈开发中,TypeScript 实现了前后端类型共享:通过 tRPC、GraphQL Code Generator 等工具,API 的类型定义可以自动同步到客户端,消除了接口文档不一致的问题。这意味着后端修改一个接口的返回类型,前端会在编译时立即报错,而非等到运行时才发现数据格式不匹配。
主流框架如 React、Vue、Angular、Next.js、Nuxt 都提供了一流的 TypeScript 支持。后端方面,Nest.js 借鉴了 Angular 的装饰器模式提供了企业级的 TypeScript 后端框架,Hono 和 Elysia 则代表了轻量级的新一代选择。然而 TypeScript 也增加了学习成本和构建复杂度,类型体操(Type Gymnastics)有时会让简单问题变得过度复杂化。近年来 Bun、Deno 等新运行时原生支持 TypeScript,无需编译步骤,进一步简化了开发流程。配合 Zod 等运行时校验库,TypeScript 构建了从编译到运行的全链路类型安全体系,使得独立开发者能够以更低的犯错成本构建复杂应用。
AI 辅助编程的工作流革命
AI 编程助手的出现正在重新定义软件开发流程。以 GitHub Copilot、Cursor、Claude 为代表的工具,已从简单的代码补全进化到能够理解需求、生成完整功能模块甚至进行架构建议。这一趋势在 2024-2025 年进一步加速——Andrej Karpathy 将这种高度依赖 AI 的编程方式命名为"Vibe Coding"(氛围编程),即开发者主要通过自然语言描述意图,由 AI 完成大部分代码生成工作,开发者更多扮演审查者和引导者的角色。
典型的 AI 辅助工作流是:开发者负责系统设计、技术选型和核心逻辑,AI 负责样板代码、API 调用、测试用例等重复性工作。GitHub 的研究数据显示,使用 Copilot 的开发者完成任务的速度提升了约 55%,而对于独立开发者,这一效率提升尤为显著——原本需要团队协作才能完成的产品,一个人借助 AI 即可在数周内交付。Y Combinator 2025 冬季批次中,已有多家由单人或双人团队运营、大量使用 AI 辅助开发的初创公司。
然而这种模式也带来新的挑战:过度依赖 AI 可能导致代码质量下降,生成的代码可能包含安全漏洞或不符合最佳实践,开发者需要具备审查和优化能力。另一个争议是版权问题——AI 训练数据来源的合法性仍存在争议,多起针对 GitHub Copilot 的集体诉讼尚在进行中。更深层的影响是职业技能的转变:纯编码能力的重要性相对下降,系统设计、问题分解、代码审查、提示词工程(Prompt Engineering)的能力变得更加关键。
从工具角度,不同 AI 工具各有所长:Cursor 支持多文件上下文理解,擅长项目级别的代码修改;Claude 在长上下文理解、代码解释和重构方面表现突出;GPT-4 在算法实现和多语言支持上有优势;而 Windsurf、Aider 等工具则专注于终端级别的编码辅助。开发者需要根据任务特性选择合适的工具组合,形成自己的"AI 工具链"。
这种"人类主导架构与设计,AI 辅助代码实现"的模式,正在成为越来越多独立开发者的标准工作流。它既保留了开发者在系统设计上的把控力,又通过 AI 大幅提升了编码效率,让一个人独立完成一个内容丰富的产品变得更加可行。这个项目从某种意义上说,既是开源工具的目录,也是 AI 编程实践的一个实例。
开源软件目录的长期价值在哪里
作者坦言,这个项目最初是为了解决自己的实际需求而构建的,但他也希望它能对社区其他人有所帮助,并公开征集反馈与建议。
从产品角度看,这类聚合型内容站的护城河,往往不在于技术本身,而在于数据的质量、完整度与持续维护。1350+ 软件、近 300 个分类的规模已经具备相当的实用价值,而"每周更新"的承诺则考验着后续的运营投入。AI 搜索是加分项,但真正让用户留下来的,仍然是背后那些经过筛选、结构化处理的可靠数据。
这一点在内容聚合领域有着反复验证的规律。Product Hunt 之所以成为新产品发现的首选平台,不是因为其网站技术多么先进,而是因为其社区驱动的策展机制确保了内容质量。同样,开源软件目录的持续价值取决于几个关键因素:数据的时效性(开源项目状态变化快,去年的热门项目今年可能已经停止维护)、覆盖的全面性(长尾分类中的小众但优质项目往往最难发现)、以及评估的客观性(避免成为项目方的营销渠道)。如果能在这些维度上持续投入,结合 AI 搜索带来的交互体验升级,这类项目有潜力成为开源生态中不可或缺的基础设施。
对于经常需要寻找开源替代方案的用户而言,这样一个集截图、数据、部署信息、商业对标于一体,并支持自然语言查询的目录,无疑提供了一条更高效的路径。
核心要点
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。