TatBLiMP:首个鞑靼语语法能力评测基准解读
TatBLiMP是首个鞑靼语语言学最小对立对基准,证明专项训练比参数规模更能提升低资源语言的语法能力。
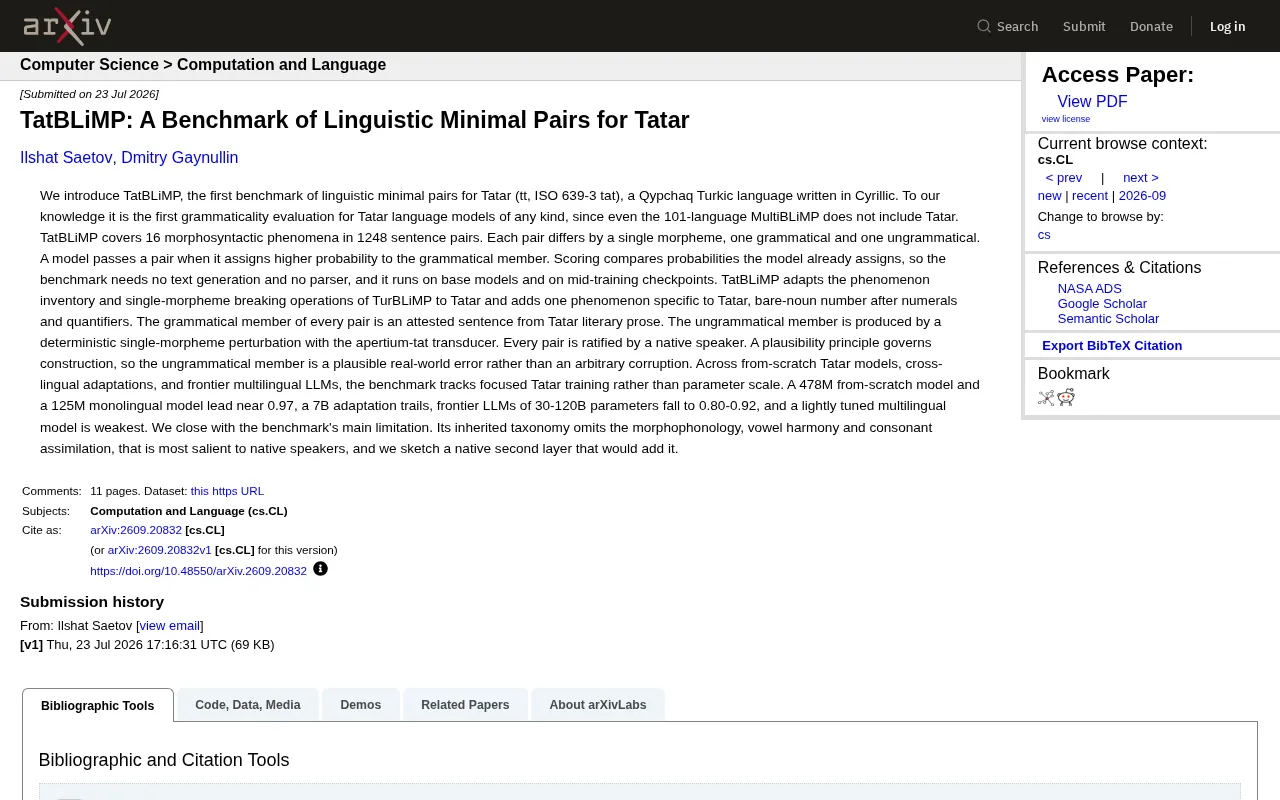
TatBLiMP填补了主流多语言评测对鞑靼语的空白,构建了涵盖16种形态句法现象的1248对最小对立对句子集。评测方法仅依赖模型输出的概率,无需生成或解析,可直接应用于基座模型及训练检查点。测试结果颠覆了"参数越大越强"的直觉:478M参数的鞑靼语专项训练模型以接近0.97的得分领先,而参数量达30B至120B的前沿多语言大模型得分仅在0.80至0.92之间。论文同时指出,继承自TurBLiMP的分类体系遗漏了鞑靼语特有的元音和谐与辅音同化等音系现象,并提出了母语者主导的扩展方案。TatBLiMP为低资源语言模型评测提供了可复制的方法论参考。
一个被主流评测遗漏的语言
在大语言模型席卷全球的今天,绝大多数评测资源都集中在英语等高资源语言上。即便是号称覆盖101种语言的MultiBLiMP,也没有把鞑靼语(Tatar,ISO 639-3 tat)纳入其中。鞑靼语是一种使用西里尔字母书写的钦察突厥语支语言,长期处于自然语言处理研究的边缘地带。
TatBLiMP的出现填补了这一空白。据论文介绍,这是首个针对鞑靼语的语言学最小对立对(linguistic minimal pairs)评测基准,也是目前已知的第一个对鞑靼语模型进行语法性(grammaticality)评估的工具。
鞑靼语主要由俄罗斯联邦鞑靼斯坦共和国约500万使用者说话,属于阿尔泰语系突厥语族钦察语支,与哈萨克语、巴什基尔语有较近亲缘关系。作为一种黏着语(agglutinative language),鞑靼语通过在词根上叠加大量后缀来表达语法意义,一个词可同时携带格、数、人称、时态等多种语法信息,这使其形态复杂度远超英语。在NLP研究中,鞑靼语长期属于"低资源语言"(low-resource language)——可用的数字化语料、标注数据和语言学工具都极为匮乏,严重制约了该语言的模型训练与评测。
什么是最小对立对评测
最小对立对是一种巧妙的语言学评测方法。每一对句子只在单个语素(morpheme)上存在差异——一个符合语法,一个不符合语法。评测的逻辑非常直接:如果模型给符合语法的句子分配了更高的概率,就算通过该对测试。
这种方法有一个显著优势:它不需要文本生成,也不需要句法分析器(parser),只需比较模型本身已经分配的概率。这意味着基准可以直接运行在基座模型(base models)乃至训练中期的检查点(mid-training checkpoints)上,极大降低了评测门槛,也让研究者能够追踪模型在训练过程中的语法能力演变。
覆盖范围与构造方法
TatBLiMP覆盖了16种形态句法现象,共包含1248对句子。它在设计上借鉴了土耳其语基准TurBLiMP的现象清单和单语素破坏操作,并针对鞑靼语额外增加了一个特有现象:数词和量词后的裸名词数(bare-noun number after numerals and quantifiers)。
每一对中的语法正确句子都取自真实存在的鞑靼语文学散文,而不合语法的版本则通过apertium-tat转换器进行确定性的单语素扰动生成。更重要的是,构造过程遵循"合理性原则"(plausibility principle),确保不合语法的句子是现实中可能出现的真实错误,而非任意的随机破坏。此外,每一对句子都经过母语者的审核确认。
最小对立对方法(Minimal Pairs)源自行为语言学评测框架BLiMP(Benchmark of Linguistic Minimal Pairs),最初由Warstadt等人于2020年针对英语提出。其核心思想是将语言模型视为一个"语法知识探针":通过比较模型为合法句与非法句分配的条件概率(或困惑度),可以在无需任何监督标注的情况下量化模型对特定语法结构的内化程度。这一范式被称为"概率语法评测"(probabilistic grammaticality judgment),与传统的人工判断任务不同,它直接利用模型的语言建模目标,因而理论上适用于任何能够输出序列概率的语言模型架构。
意外的评测结果:训练聚焦胜过参数规模
TatBLiMP在多类模型上进行了测试,包括从零训练的鞑靼语模型、跨语言适配模型,以及前沿的多语言大模型。结果颇具启发性:基准追踪的是针对鞑靼语的专门训练,而非单纯的参数规模。
具体数据显示,一个478M参数的从零训练模型和一个125M参数的单语模型表现领先,得分接近0.97;而一个7B参数的适配模型反而落后;参数量高达30B到120B的前沿大模型得分只落在0.80到0.92之间;一个轻度微调的多语言模型表现最弱。
这一结果对"大力出奇迹"的普遍认知提出了挑战。对于低资源语言而言,专注的、有针对性的训练数据似乎比堆砌参数规模更能带来语法能力上的提升。这也为资源受限环境下的语言模型开发提供了现实参考。
局限与未来方向
论文作者也坦率地指出了基准的主要局限。由于TatBLiMP继承自TurBLiMP的分类体系,它遗漏了对母语者而言最为突出的形态音系现象——元音和谐(vowel harmony)与辅音同化(consonant assimilation)。
针对这一缺陷,作者勾勒了一个由母语者主导的"第二层"扩展方案,用以补充这些音系层面的评测内容。这一思路也提示了低资源语言评测的一个普遍难题:直接移植高资源或相近语言的评测框架,往往会忽略目标语言最具特色的语言学特征。
元音和谐(vowel harmony)是突厥语族语言中最具标志性的音系规则:词根中的元音音色(前/后、圆唇/非圆唇)会制约所有后续后缀必须选用匹配的元音变体。在鞑靼语中,这一规则还与辅音同化(consonant assimilation,即相邻辅音在发音位置或清浊上相互同化)共同构成形态音系的核心约束。这类现象属于"语音形态交界"(morphophonology)层面的规则,普通形态句法框架往往难以覆盖,而母语者在产出或判断句子时会将其违反视为极明显的错误信号。这也解释了为何直接沿用TurBLiMP体系会造成系统性遗漏。
结语
TatBLiMP不仅是鞑靼语NLP研究的一块重要基石,也为低资源语言的模型评测提供了一套可复制的方法论。它证明了即便在缺乏大规模数据的语言上,通过精心设计的最小对立对,仍然可以对模型的语法能力进行严谨、低成本的量化评估。对于关注语言多样性和公平AI的研究者来说,这是一项值得关注的工作。
相关推荐
Asana AI产品负责人分享AI Agent最佳实践
Asana AI产品负责人分享AI Agent最佳实践,涵盖职责边界设定、人在回路设计、数据模型锚定以及评估迭代方法,为产品团队落地Agent提供可参考的原则。
日本互联网巨头GMO遭黑客泄密:云服务漏洞致客户数据外泄
日本GMO Internet证实云服务遭黑客攻击,客户数据疑被公开。公司正核实泄露数据真实性,事件凸显云服务安全风险与供应链攻击威胁。

苹果为Pages、Keynote、Numbers加入AI助手
苹果为Keynote、Pages、Numbers引入AI助手,基于苹果与OpenAI模型,可理解文档上下文,在Keynote中设计动画幻灯片、在Pages中起草和重构文档,生产力套件AI竞争升级。