TechCrunch Disrupt 2026:Startup Battlefield 200评委阵容揭晓

TechCrunch Disrupt 的 Startup Battlefield 200 评审团即将成型,200家精选初创公司即将同台竞技。
TechCrunch Disrupt 年度赛事 Startup Battlefield 200 进入最终阶段,随着最新五位风险投资人评委名单公布,评审团阵容接近完整。本届赛事从数千份全球申请中经多轮严格筛选,最终遴选出200家初创公司入围。Startup Battlefield 作为 TechCrunch 的招牌环节,历史上孕育了多家知名科技公司,入围本身即是行业认可的信号。对参赛创业者而言,在资深投资人面前展示项目并接受尖锐问答,既是宝贵历练,也是获取曝光和资源的重要机会。对行业观察者而言,哪些赛道公司入围、评委关注哪些问题,均可作为读取当下投资风向的现场样本。
Startup Battlefield 200 进入决赛阶段
经过数千份申请、多轮评审,以及数百小时对全球创业公司的评估,TechCrunch Disrupt 备受瞩目的 Startup Battlefield 200 终于进入最激动人心的阶段。随着最新一批评委名单的公布,本届评审团阵容已接近完整。再过几周,200 家经过精挑细选的初创公司将齐聚一堂,争夺这一创业竞技舞台的最高荣誉。
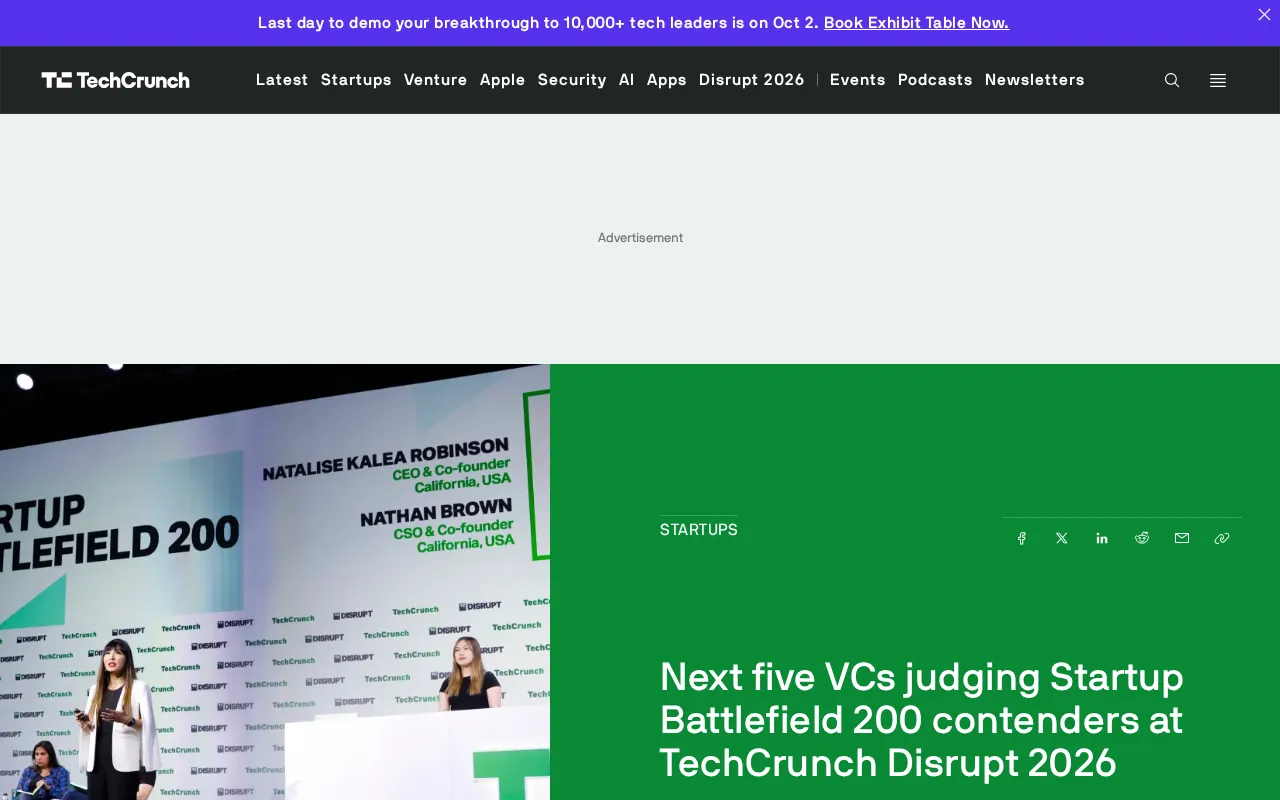
Startup Battlefield 是 TechCrunch Disrupt 的招牌环节,多年来见证了众多知名科技公司的起步。对参赛的早期创业者而言,能够站上这个舞台,本身就是一种被行业认可的信号。
评委阵容的分量
本次公布的五位风险投资人(VC)加入评审团,意味着完整的评委名单即将成型。在 Startup Battlefield 的赛制中,评委不仅仅是打分者——他们代表着投资界对创业项目的真实判断标准。
对创业者来说,能在这些资深投资人面前展示产品、回答尖锐提问,是极为宝贵的历练。评委的背景和投资偏好,往往会影响他们对不同赛道项目的关注重点,这也是参赛团队需要提前研究的功课。
风险投资人(VC,Venture Capitalist)是科技创业生态中的关键角色。他们管理着由机构投资者或高净值个人出资组成的基金,专门投资于具有高增长潜力的早期或成长期公司,以换取股权。VC的投资决策不仅影响初创公司的融资命运,其关注赛道的变化也往往预示着下一个技术周期的走向。在 Startup Battlefield 的评审场景下,资深VC的提问角度通常聚焦于市场规模(TAM)、商业模式可持续性、团队执行力以及竞争壁垒,这些维度也是创业者在路演(Pitch)中最需要充分准备的核心议题。
为什么 Startup Battlefield 值得关注
从筛选流程可以看出这项竞赛的严谨程度:数千份申请、多轮审核层层过滤,最终仅有 200 家公司脱颖而出。这种高门槛保证了参赛项目的整体质量,也让这个舞台成为观察全球创业趋势的重要窗口。
对于关注科技创业生态的从业者、投资人和媒体而言,Startup Battlefield 200 不只是一场比赛,更是一份关于新兴技术方向和市场机会的现场样本。哪些赛道的公司入围、评委们对哪些问题最感兴趣,往往能反映出当下投资界的风向。
Startup Battlefield 自2007年创办以来,已成为早期创业公司最具影响力的展示平台之一。历届参赛或获奖公司中,不乏后来成长为行业巨头的名字,例如 Dropbox、Mint、Yammer 均曾在此亮相。对于尚未建立品牌知名度的早期团队而言,入围本身就能带来显著的媒体曝光和投资人关注。比赛结构通常分为初赛、半决赛和决赛,每轮面对不同的评委小组进行现场演示(Demo)与问答,最终胜出者除获得奖金外,更重要的是获得全球科技媒体和投资圈的集中关注。这种赛制设计使得即便未能夺冠的参赛团队,也往往能在赛事期间积累到有效的人脉资源和市场反馈。
结语
随着评审团的即将集结,TechCrunch Disrupt 的 Startup Battlefield 200 已经蓄势待发。对创业者而言,这是一次难得的展示机会;对整个科技行业而言,这场竞赛所呈现的项目和判断,都将成为值得留意的信号。完整评委名单和更多赛事细节,值得持续关注。
相关推荐
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。