TensorRT Edge-LLM实测:Jetson AGX Thor跑MLPerf边缘Agent基准快6.4倍
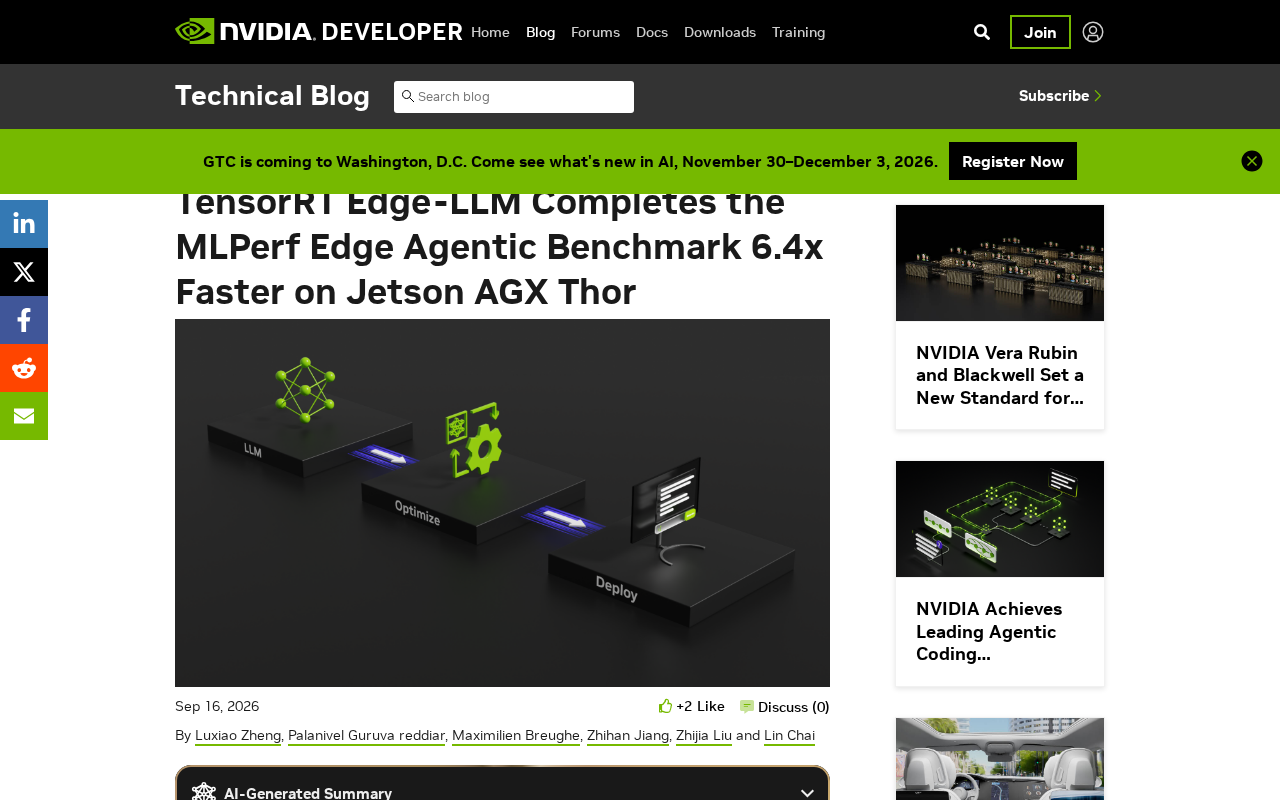
TensorRT Edge-LLM与Jetson AGX Thor协同优化,使边缘智能体推理速度提升6.4倍。
AI智能体正从云端向车辆、机器人等边缘设备迁移,其多步骤链式推理模式使延迟在每轮调用中不断累积,对边缘硬件提出了远超单轮推理的苛刻要求。NVIDIA公布的测试结果显示,基于TensorRT Edge-LLM软件栈与Jetson AGX Thor硬件平台的深度协同优化,在MLPerf边缘Agentic基准测试中实现了6.4倍的速度提升。MLPerf Agentic基准专为多步骤智能体工作负载设计,比传统单轮吞吐量基准更能反映真实部署效果。这一成果表明,随着推理软件栈和专用边缘硬件的持续进步,原本依赖云端算力的智能体功能正逐步具备在本地设备上实时运行的条件,为自动驾驶、工业机器人等场景的低延迟、强隐私保护的边缘智能体落地提供了重要参考。
AI智能体正从云端数据中心加速向车辆、机器人等边缘设备迁移。与只回答单次提问的聊天机器人不同,智能体需要在多步骤链路中持续调用模型进行推理、规划和执行——这对边缘硬件的推理效率提出了远超以往的要求。NVIDIA近期公布的一项成果显示,基于TensorRT的Edge-LLM在Jetson AGX Thor上完成MLPerf边缘Agentic基准测试的速度达到了6.4倍的提升,为边缘侧智能体部署提供了新的参考标杆。
从云端到边缘:Agent工作负载的本质变化
理解这次性能提升的意义,先要理解边缘智能体与传统推理任务的差异。一个聊天机器人接收提示、生成回复即告完成,属于典型的单轮推理。而智能体则要在完成一项任务的过程中反复思考、调用工具、评估结果并决定下一步动作,整个流程往往包含多次模型调用。
这种「链式」工作模式意味着,任何单次推理的延迟都会在多步骤中被放大。云端可以依靠大规模GPU集群和充足的功耗预算来消化这种开销,但当智能体被搬到车辆、机器人这类边缘设备上时,算力、内存和功耗都受到严格约束。如何在有限资源下把每一步推理都做到足够快,成为边缘智能体能否落地的关键瓶颈。
智能体的「链式」推理模式在技术上通常以ReAct(Reasoning + Acting)或类似框架实现:模型在每一步生成思考过程(Thought)、决定调用何种工具(Action),接收工具返回结果(Observation)后再进入下一轮推理,直至任务完成。一个中等复杂度的智能体任务往往需要5到20次模型调用,若每次调用延迟为500毫秒,端到端完成时间便可能达到2.5至10秒。在云端这属于可接受范围,但对于需要实时响应的自动驾驶或工业机器人场景,这种累积延迟可能直接影响安全性或生产节拍,这也是边缘推理效率成为关键瓶颈的根本原因。
MLPerf边缘Agentic基准的意义
MLPerf作为业界广泛认可的机器学习性能评测体系,其边缘Agentic基准专门针对智能体在边缘设备上的实际工作负载设计。相比只测量单次推理吞吐量的传统基准,Agentic基准更贴近智能体真实运行时的多步骤特征,能够反映端到端任务完成的整体效率。
在这类基准上取得优异成绩,意味着相关软硬件组合不仅在纸面峰值算力上表现良好,更能在复杂、连续的推理链路中保持稳定高效。这对于评估边缘智能体的实际可用性具有更高的参考价值。
TensorRT Edge-LLM与Jetson AGX Thor的协同
这次6.4倍的性能提升,来自TensorRT Edge-LLM软件栈与Jetson AGX Thor硬件平台的深度协同。TensorRT是NVIDIA面向推理优化的核心工具链,通过算子融合、精度量化、内核自动调优等手段压榨硬件性能;而Edge-LLM则是针对边缘场景下大语言模型部署所做的专门优化路径。
Jetson AGX Thor作为面向机器人和自动化场景的边缘计算平台,提供了远超前代的算力密度。当经过深度优化的推理软件栈运行在专为边缘AI设计的硬件之上时,二者的叠加效应使得原本对边缘设备而言颇具挑战的多步骤智能体工作负载变得可行。6.4倍的加速幅度,正是软硬件协同优化的直接体现。
TensorRT的核心优化技术值得进一步说明。算子融合(operator fusion)将多个连续的计算操作合并为单一内核调用,减少显存读写和调度开销;精度量化(quantization)则将模型权重从FP32或FP16降低至INT8甚至INT4表示,在可接受的精度损失范围内大幅压缩内存占用和计算量;内核自动调优(auto-tuning)会在目标硬件上实际运行多种算子实现并选择最优方案,确保优化效果与具体硬件特性紧密匹配。Jetson AGX Thor搭载了NVIDIA下一代GPU架构与专用深度学习加速器,其片上内存带宽和功耗比(TOPS/W)相比上一代Jetson AGX Orin有显著提升,能够在不超过60W的功耗包络内提供数百TOPS的AI算力,这正是支撑多步骤智能体链路在边缘实时运行的硬件基础。
对边缘智能体落地的启示
这一结果对正在探索边缘AI部署的开发者和企业具有实际意义。智能体应用要真正走出云端、进入物理世界,边缘设备必须能够以可接受的延迟和功耗支撑起完整的推理链路。此前,多步骤智能体在边缘运行常常因为延迟累积而难以满足实时性要求。
随着推理软件栈的持续优化和专用边缘硬件的迭代,边缘侧智能体的性能天花板正在被不断抬高。对于自动驾驶、工业机器人、智能终端等场景,这意味着更多原本只能依赖云端的智能体功能,有望逐步下沉到本地设备执行,从而带来更低的延迟、更好的隐私保护以及更强的离线可用性。
结语
TensorRT Edge-LLM在Jetson AGX Thor上实现的6.4倍加速,展示了边缘智能体推理优化的进展方向。当AI智能体从对话框走向真实世界的车辆与机器人,推理效率不再只是吞吐量数字,而是决定应用能否落地的现实门槛。软硬件协同优化正在把这道门槛逐步降低,边缘智能体的规模化部署也因此更近了一步。
相关推荐
突破1.58比特极限:三元LLM如何逼近信息论边界
三元大模型(ternary LLM)的1.58-bit并非真正下限。本文解析为何利用权重稀疏分布与熵编码可以突破这一信息论壁垒,以及其对低比特量化与端侧部署的工程意义。
DACA-GRPO:为扩散语言模型强化学习引入去噪感知信用分配
DACA-GRPO 是一种为扩散语言模型强化学习设计的去噪感知信用分配方法,解决时序信用分配缺失与似然估计偏差两大问题,可即插即用地增强任何GRPO训练器。
可解释的智能体检索:让RAG不只是"猜对答案"
纯向量RAG的智能体虽能检索内容却无法解释推理来源。本文探讨基于Neo4j知识图谱、向量与图混合检索、多步验证实体抽取的可解释智能体检索方案,实现可追溯、有来源支撑的AI Agent答案。