提示词工程入门:从写指令到系统化设计

提示词是单次指令,提示词工程是可复用流程,二者差距巨大且各有边界。
文章基于B站提示词工程教程第一课,系统梳理了提示词与提示词工程的核心框架。提示词是控制AI最直接的手段,承担沟通桥梁、任务导航、风格控制和边界约束四层作用;提示词工程则是一套不靠灵感靠方法的系统化流程,包含需求拆解、设计方案、执行测试、评估效果、策略迭代、沉淀复用六步,追求准确率、低幻觉、稳定性和低成本四大目标。文章同时强调提示词并非万能钥匙,存在能力上限、输出不稳定、幻觉、上下文长度受限、无长期记忆等硬性局限,企业级落地需提示词与代码结合,并警惕token成本陷阱。
很多人以为提示词就是给AI发消息,其实远不止于此。B站上有一套被观众称为"全程干货无废话"的提示词工程教程,开篇就从最基础的认知讲起,把提示词、提示词工程以及它们之间的差距一次说清楚。这篇文章基于该教程第一课的内容,梳理其中的核心框架,并补充一些自己的理解。
提示词到底是什么
提示词就是我们对AI发出的任何指令——无论是一个问题、一段描述,还是一条完整的任务说明。教程用了一个很形象的比喻:提示词像你给AI发送的神经元信号,发什么信号,AI就往哪个方向思考。它是我们控制AI最直接的手段。
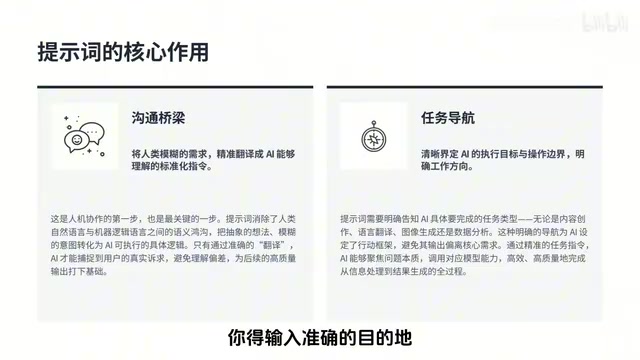
同样一个模型,有人只能拿来写小学生作文,有人却能写出专业的行业报告。差别不在AI本身,而在输入。提示词的具体作用可以拆成四层:
- 沟通桥梁:把脑子里模糊的需求翻译成AI能听懂的明确指令。就像点外卖不能只说"来份吃的",要说清楚菜品、辣度、加不加饭。
- 任务导航:告诉AI明确的目标和边界。"帮我处理一下这份文件"是无效指令,AI不知道你要统计分析、可视化还是写总结,只能随便选一个。好的提示词像导航输入准确目的地,否则AI就会到处乱开。
- 风格控制:这是最容易被忽略的一层。商务邮件和朋友圈文案的风格天差地别,AI默认输出的是不偏不倚的"通用体",通过提示词可以让它切换成鲁迅风格、小学生语气或严谨学术语言,省去大量后期修改。
- 边界约束:对付AI"胡说八道"最有效的方法之一。不设限的AI能从一个点扯到十万八千里外,还会编造不存在的东西。明确什么可以说什么不能说,输出才会聚焦。
教程给了一个直观对比:让AI写春天的文章,基础提示词只说了"写一篇关于春天的文章",没交代南北、文体、字数、风格,AI只能瞎猜,结果千篇一律;优化后的提示词先给身份(你是一名散文作家),再定字数(800字)、场景(江南的春天)、风格(语言优美、抒情、着重写烟雨朦胧的水乡意境)。从模糊要求变成可执行规则,输出质量立刻不同。
提示词工程的真正含义
这两个概念常被混为一谈,教程强调差别非常大。提示词工程不是"会写几个好提示词",而是一套完整方法:不修改AI本身的代码和参数,只通过设计输入指令,让AI稳定输出想要的结果。它是让通用模型解决具体业务问题的关键,也是一种与AI高效协作的核心能力。
两者对比很清楚:提示词是单次的,像写一行代码执行一次解决一个问题,这次好用下次换个问题可能就失效——所谓"万能提示词"并不存在,只有适合特定场景的提示词。提示词工程则是一套流程,不靠灵感靠方法,从分析问题到设计方案、测试效果、持续优化,最后沉淀成可复用的资产。它解决的不是一个问题,而是一类问题。
具体执行可以拆成六步:需求拆解(把复杂问题拆成AI能解决的小问题)、设计方案(为每个子问题设计提示词和角色)、执行测试(实际跑一遍看效果)、评估效果(用具体标准判断结果好坏)、策略迭代(不好的地方持续改)、沉淀复用(把好方案保存下来供类似场景直接调用)。这套流程和软件开发很像,只不过写的是自然语言。
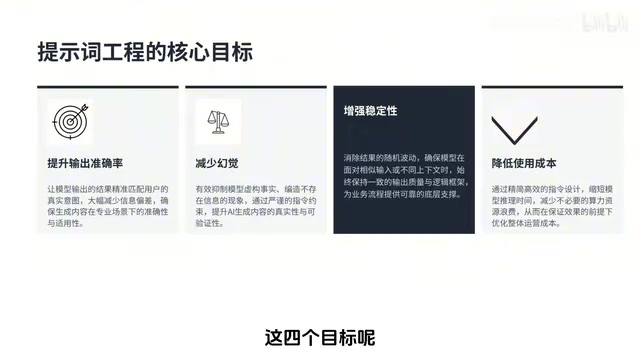
做提示词工程最终追求四个目标,它们也是评价方案好坏的标准:提升准确率、减少幻觉、增强稳定性(谁用、什么时候用,结果都差不多)、降低成本(用最少的token拿到最好的效果)。如果四点都做到,方案就是成功的。
token 是大模型处理文本的基本单位,可以粗略理解为“词片”——一个汉字、一个英文单词或标点往往对应一个或多个 token。模型按输入和输出的 token 总量计费,上下文窗口(即模型一次能“记住”的最大 token 数)也以此衡量。这就是为什么提示词越长越贵、聊得太久模型会“忘事”:超出窗口的早期内容会被截断或压缩。理解 token 有助于在写提示词时主动做减法,用更精炼的表达换取更低的成本和更稳定的上下文保留。
为什么现在值得学
教程提到一个数据:超过90%的用户只会用AI做基础问答。这就像买了跑车却只用一档开。当前模型能力已经很强,瓶颈在用户侧——不会把能力发挥出来。
提示词工程的门槛极低:不需要编程,不需要懂算法,只要会说话、能把事情说清楚就能学。收益却很直接。效率上,原来一天的事可能一小时做完,还能处理以前AI搞不定的任务,比如写专业报告、做复杂数据分析。商业价值同样可观:帮企业和自媒体优化提示词或生成内容,利用碎片时间就能做;创业时一个人干原来一个团队的活,试错成本低,想法能快速验证;做自媒体可以用AI快速产出内容积累粉丝。教程的定位是:这不只是技能,而是AI时代的一个机会。
上下文窗口(Context Window) 是模型单次对话能处理的最大 token 数量,可类比为工作记忆的容量。窗口越大,模型能同时参考的材料越多,适合长文档分析和多轮复杂任务;但窗口并非无限,且随着对话推进,早期内容可能被挤出或稀释,导致模型“忘记”最初设定的角色和要求。实践中常见的应对方式是在长任务中定期复述关键约束、把重要信息放在开头或结尾,或将任务拆分成多个短会话分别处理,以规避窗口限制带来的信息衰减。
提示词的局限:它不是万能钥匙
课程最后花了不少篇幅讲局限性,这部分反而最值得认真对待。
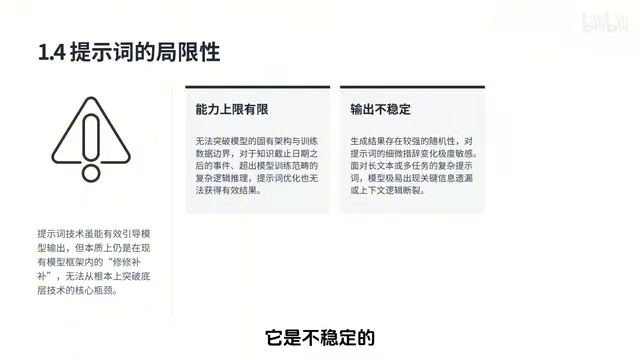
能力上限无法突破。 AI训练数据有截止时间,问它之后发生的事它不知道;再复杂的数学题算不出来,优化提示词也没用。
输出不稳定。 有时改一个字结果就完全不一样;提示词太长AI会"忘事",前面说的后面就不记得。
幻觉只能减少不能消除。 只要是大模型就一定会编瞎话,重要事项必须自己核实。
技术层面还有三个硬约束:上下文长度受限,像手机运行内存,开太多应用会清理后台,聊太久AI会忘掉最初的要求;复杂多步骤任务不稳定,容易跳步骤、断逻辑,必须先拆成小任务;没有真正的长期记忆,每次对话都是全新的,记不住偏好和背景,只能靠外部数据库解决。这三个问题由技术底层决定,提示词无法根治。
落地层面还有三个坑。一是安全与对齐限制,违法违规内容绝对不能生成,但完全合法的需求也可能被误判拦截,这是所有大模型的通病。二是纯提示词没法工程化,自己用没问题,做成产品给几百上千人用就不行,版本管理、问题回溯、大规模批量任务都扛不住,企业级应用一定是提示词加代码结合。三是成本陷阱,AI按token收费,提示词越长越贵,而且成本不是线性增长,高频调用时隐性成本会高得吓人,写提示词必须简洁。
把这四点认知建立起来,比记住任何一条"神级提示词"都更有价值。提示词是好工具,但不是万能钥匙,该人工做的事还得人工做。
幻觉(Hallucination) 指大模型生成看似合理、实则与事实不符或凭空捏造的内容。其根源在于模型本质上是基于概率预测下一个 token,而非检索事实数据库,因此当训练数据缺失或问题超出其知识范围时,它会“顺畅地编造”而非承认不知道。常见缓解手段包括:要求模型标注不确定之处、提供参考资料让其基于给定材料回答(检索增强)、以及用外部工具核验关键数据。但这些都只能降低发生概率,无法从机制上消除,所以涉及数字、法规、引用等高风险信息时,人工复核仍是必需环节。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。