条件扩散模型学习跳跃-扩散过程转移核:理论与实证新进展
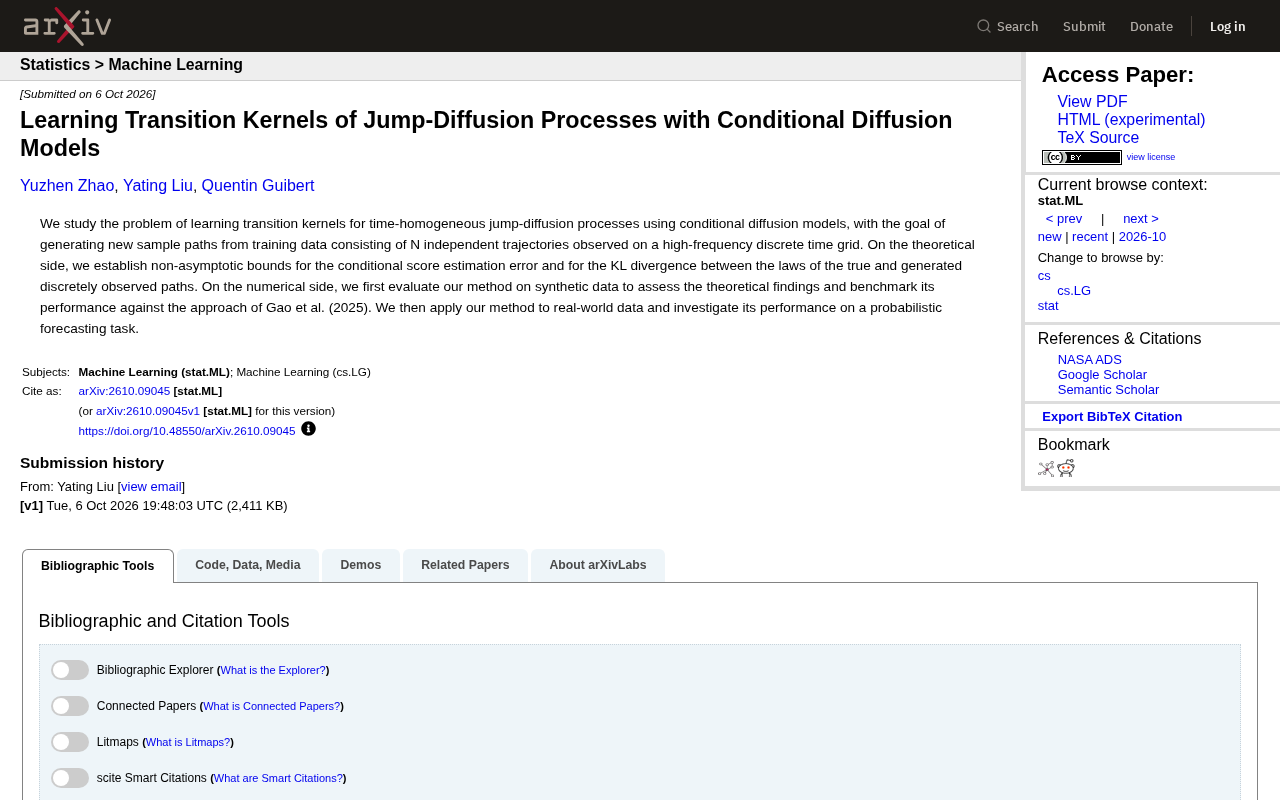
用条件扩散模型非参数地学习跳跃-扩散过程转移核,并给出严格非渐近误差保证。
这篇arXiv预印本提出用条件扩散模型对时间齐次跳跃-扩散过程的转移核进行数据驱动学习,核心目标是从有限观测轨迹中生成符合同一随机动力学的新样本路径。与传统参数化建模不同,该方法无需预设跳跃分布或扩散系数的具体形式,以逐步去噪的方式隐式捕捉复杂的混合连续-离散动力学。研究在理论层面建立了条件得分估计的非渐近误差界,以及生成路径与真实路径分布之间KL散度的收敛保证,为方法提供了坚实的数学基础。数值实验分合成数据基准测试与真实数据概率预测两阶段展开,验证了理论与实践的一致性。这项工作为生成式AI与随机过程理论的交叉提供了兼具理论深度与应用潜力的范例。
研究背景:跳跃-扩散过程为何难以建模
跳跃-扩散过程(Jump-Diffusion Processes)是金融、物理和生物等领域中描述系统随机演化的重要工具。它在连续的布朗运动基础上叠加了离散的跳跃成分,能够刻画资产价格的突发暴涨暴跌、神经信号的脉冲放电等现实现象。然而,这类过程的建模长期面临一个核心难题:如何从有限的观测轨迹中准确学习其转移核(transition kernel),即系统从一个状态演化到下一个状态的概率规律。
传统方法往往依赖对过程参数形式的强假设,一旦真实数据偏离假设,模型表现便大打折扣。这篇发表于 arXiv 的研究(arXiv:2610.09045v1)提出了一个新思路:借助近年在生成式 AI 领域大放异彩的条件扩散模型(Conditional Diffusion Models),以数据驱动的方式学习时间齐次(time-homogeneous)跳跃-扩散过程的转移核,并据此生成全新的样本路径。
跳跃-扩散过程最具代表性的经典模型是 Merton(1976)提出的跳跃-扩散期权定价模型,其中资产价格由几何布朗运动与复合泊松跳跃叠加而成。转移核的学习难度主要来自两个方面:其一,跳跃事件的随机性使得过程在同一时间步内可能经历截然不同的状态迁移,条件分布呈现多峰、重尾等复杂形态,难以用有限参数族捕捉;其二,在离散观测设置下,连续时间路径中发生了多少次跳跃、何时发生均无法直接得知,形成所谓的「隐跳跃」问题,使得基于似然函数的估计在大多数情形下没有解析表达式,只能依赖计算代价高昂的数值积分或 MCMC 方法。时间齐次(time-homogeneous)这一假设虽然限制了过程的时变性,却使得来自不同时间段的观测片段可以被视为对同一转移核的独立采样,大幅降低了统计估计的复杂度,是理论分析得以展开的重要前提。
方法概览:用生成模型生成随机路径
该研究的目标设定清晰:给定 N 条在高频离散时间网格上观测到的独立轨迹作为训练数据,模型需要学会生成符合同一分布规律的新路径。这里的关键在于「条件」二字——扩散模型并非无条件地生成样本,而是基于当前状态作为条件,预测下一时刻状态的分布,从而逐步拼接出完整的时间序列。
这种思路巧妙地将序列生成问题转化为对转移核的学习。扩散模型通过逐步去噪的方式对复杂的条件概率分布进行建模,相比传统参数化方法,它无需预设跳跃分布或扩散系数的具体形式,具备更强的表达能力。对于兼具连续扩散与离散跳跃的混合动力学,这种非参数化的灵活性尤为可贵。
条件扩散模型(Conditional Diffusion Models)是去噪扩散概率模型(DDPM)的扩展形式。标准 DDPM 通过前向加噪过程将数据逐步破坏为高斯噪声,再训练神经网络执行反向去噪以恢复数据分布;条件版本则在去噪网络的输入中额外注入条件信息(此处为系统当前状态),使模型输出特定条件下的样本。在转移核学习的语境中,模型以 $X_t$ 为条件生成 $X_{t+\Delta t}$ 的样本,通过在大量观测片段 $(X_t, X_{t+\Delta t})$ 上反复训练,神经网络隐式地学到了条件分布 $p(X_{t+\Delta t} \mid X_t)$ 的完整形态,而无需对该分布的函数形式作任何参数化假设。这与传统卡尔曼滤波或粒子滤波方法的核心区别在于:后者需要显式给定状态转移方程,而扩散模型将这一先验知识的需求转移到了数据量与模型容量上。
理论贡献:误差界的严格刻画
研究在理论层面给出了两项重要结果,这也是该工作区别于纯工程实践的核心价值所在。
条件得分估计的非渐近界
扩散模型的训练本质是学习数据分布的「得分函数」(score function,即对数密度的梯度)。研究建立了条件得分估计误差的非渐近界(non-asymptotic bounds)。所谓非渐近,意味着这些界限在有限样本量下即成立,而非仅在样本量趋于无穷时的渐近性质。这对实际应用更具指导意义,因为真实数据总是有限的。
得分函数(score function)$\nabla_x \log p(x)$ 是基于得分的生成模型的核心概念,由 Hyvärinen(2005)在得分匹配框架中系统引入。直觉上,它指向数据密度上升最快的方向,使得沿朗之万动力学迭代采样的粒子能够向高密度区域聚集。在条件扩散模型中,网络实际学习的是加噪后中间变量的条件得分 $\nabla_{x_\tau} \log p_\tau(x_\tau \mid x_0)$,其中 $\tau$ 为扩散时间步。非渐近界的建立通常需要对得分网络的函数类(如 Sobolev 类或 Besov 类)、训练数据的分布正则性以及网络近似误差作出具体假设,并通过统计学习理论中的覆盖数或 Rademacher 复杂度工具推导样本复杂度与估计误差之间的定量关系。这类结果近年来在 Chen et al.(2023)等工作中得到快速发展,本文将其推广至跳跃-扩散的条件设置,技术挑战在于处理跳跃引入的分布不连续性。
KL 散度的收敛保证
更进一步,研究量化了真实离散观测路径的分布与模型生成路径分布之间的 KL 散度(Kullback-Leibler divergence)界限。KL 散度衡量两个分布的差异程度,这一结果从理论上保证了:只要得分估计足够准确,生成路径的统计规律就能逼近真实过程。这为「用扩散模型模拟跳跃-扩散过程」提供了坚实的数学背书,而非仅停留在经验层面的「看起来相似」。
KL 散度 $D_{\mathrm{KL}}(P | Q) = \mathbb{E}_P[\log(P/Q)]$ 是信息论中衡量两个概率分布差异的标准工具,其非负性和对尾部分布的敏感性使其在生成模型评估中被广泛采用。将得分估计误差传播为路径分布 KL 散度的关键工具是 Girsanov 定理与随机微积分中的 Fokker-Planck 方程:得分估计误差本质上引入了反向 SDE 漂移项的偏差,该偏差随时间累积后造成生成路径分布对真实分布的偏离,而 KL 散度可以通过对偏差的 $L^2$ 范数进行积分来上界估计。对于含跳跃的过程,路径空间上的测度变换需要引入补偿泊松随机测度(compensated Poisson random measure)等更精细的工具,理论推导的复杂度显著高于纯扩散情形,这也是本文理论贡献的难点所在。
实证评估:合成数据与真实数据的双重检验
研究的数值实验分为两个阶段,逻辑层层递进。
第一阶段在合成数据上进行,目的是在已知真实分布的受控环境下验证理论发现。研究将自己的方法与 Gao et al. 的既有方法进行基准对比(benchmark),考察在误差界预测下的实际表现是否吻合。合成数据的优势在于真值可知,能够清晰地检验方法的收敛行为与理论界限的紧密程度。
第二阶段将方法应用于真实世界数据,并聚焦于一个概率预测(probabilistic forecasting)任务。与点预测只给出单一数值不同,概率预测要求模型输出未来状态的完整分布,从而刻画不确定性。这恰恰是跳跃-扩散过程建模的用武之地——金融风险管理、极端事件预警等场景都高度依赖对尾部分布和突发跳跃的准确刻画。
意义与展望
这项工作的价值在于,它为生成式 AI 与随机过程理论之间架起了一座桥梁。一方面,它把扩散模型从图像、文本生成的热门舞台,拓展到了结构化随机动力学的严谨建模;另一方面,它没有止步于「能跑通」的工程演示,而是补齐了理论分析这块往往被忽视的拼图。
对于从事量化金融、时间序列预测的研究者和实践者而言,这意味着一种新的建模范式:无需为每类过程手工设计参数模型,而是让扩散模型从数据中自行捕捉复杂的转移规律,同时还能获得误差可控的理论保证。随着扩散模型在连续时间随机过程上的进一步探索,未来有望在更广泛的高频金融数据、物理仿真和气候建模等领域看到类似方法的落地。
当然,作为一篇预印本研究,其方法在高维状态空间、非时间齐次过程以及计算效率方面仍有待验证与拓展。但它所展示的「理论界限 + 实证基准 + 真实应用」三位一体的研究框架,为后续工作树立了值得参考的标杆。
相关推荐
AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。
@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。
ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。