条件熵加持的EDL:青光眼检测的不确定性量化新突破
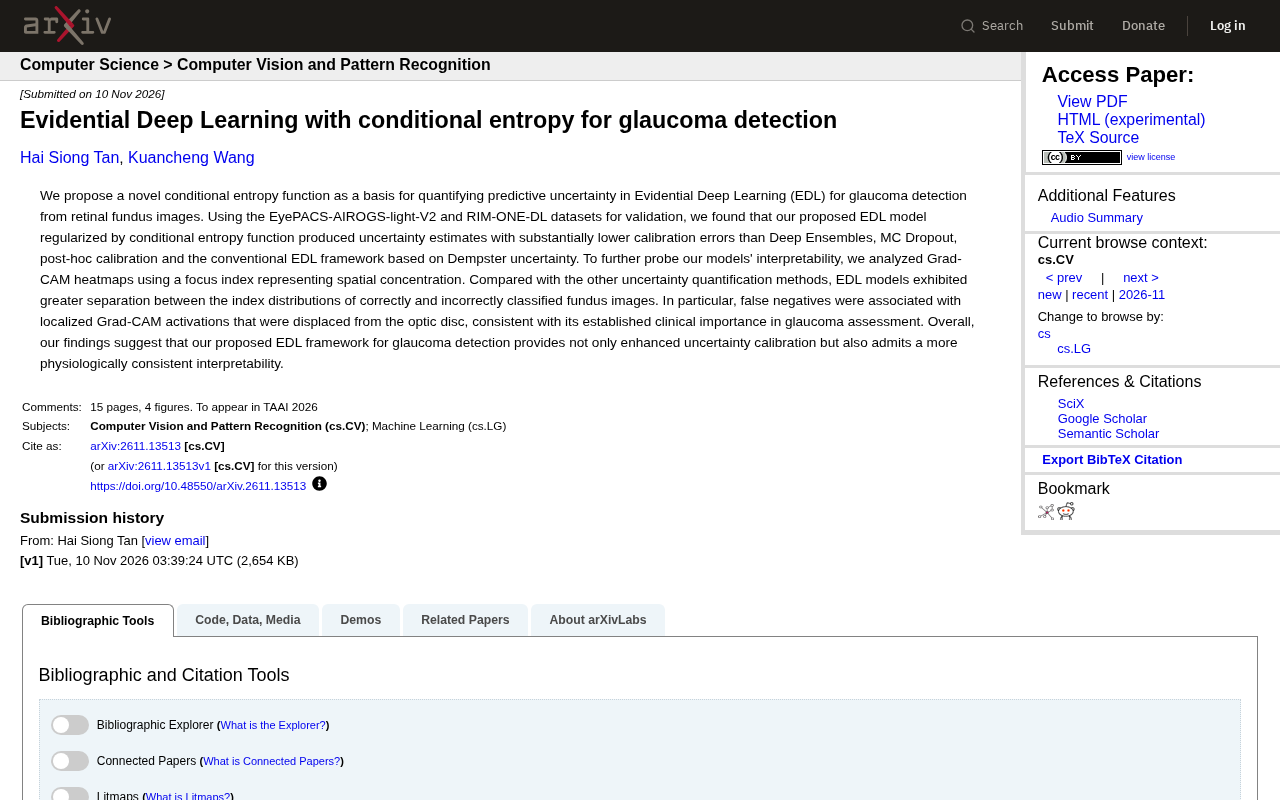
条件熵正则化的证据深度学习显著提升青光眼筛查模型的不确定性校准与注意力一致性。
文章介绍了一项针对青光眼眼底图像筛查的不确定性量化研究。传统深度学习分类器常无法可靠表达置信度,高置信度的错误预测在临床中危害尤大。该研究提出基于条件熵正则化的证据深度学习(EDL)框架,在EyePACS-AIROGS-light-V2与RIM-ONE-DL两个数据集上,其校准误差显著低于Deep Ensembles、MC Dropout、事后校准及基于Dempster不确定性的传统EDL。作者还引入Grad-CAM焦点指数,发现EDL模型在正确与错误样本间注意力分布分离度更大,假阴性样本的激活常偏离视盘。文章同时指出该工作仅限两个公开数据集、缺乏多中心与读者研究验证,并讨论了其单次前向推理的效率优势与向其他医学影像任务迁移的潜力。
为什么青光眼筛查需要更好的不确定性量化
青光眼是不可逆性失明的主要原因之一,视网膜眼底图像是其筛查的关键手段。然而,深度学习模型在分类这些图像时,往往无法可靠地表达“自己有多确定”。一个高置信度的错误预测,在临床场景中可能导致漏诊或误诊。
据近期发表的研究,一种基于条件熵(conditional entropy)正则化的证据深度学习(Evidential Deep Learning, EDL)框架,在青光眼检测任务中显著改善了预测不确定性的校准质量。该研究使用EyePACS-AIROGS-light-V2和RIM-ONE-DL两个数据集进行验证,发现所提出的EDL模型在校准误差上大幅低于深度集成(Deep Ensembles)、MC Dropout、事后校准以及基于Dempster不确定性的传统EDL框架。
这一结果的意义在于:不确定性量化不再只是“附加功能”,而可能成为医学影像模型安全部署的核心组件。
校准(Calibration) 是不确定性量化中的核心概念,指模型输出的置信度是否与其实际正确率相匹配。一个经过良好校准的模型,当它声称"有90%把握"时,在大量同类预测中应确实约有90%是正确的。常用度量是期望校准误差(ECE),即把预测按置信度分桶后,计算各桶内平均置信度与平均准确率之差的加权和。校准差的模型会系统性高估自己(过度自信),在临床筛查中这尤其危险,因为一个自信的错误判断很难被下游流程拦截。
Deep Ensembles 通过训练多个独立初始化的模型并对输出取平均来估计不确定性,通常校准表现优秀,但训练与推理成本随模型数量线性增长。MC Dropout 则在推理阶段保持Dropout开启、多次前向采样以获得预测分布,实现简单但采样次数与估计质量之间存在权衡。这两类方法都属于"采样型"不确定性估计,是EDL等单次前向方法的主要对照基线。
条件熵如何改进EDL的不确定性估计
传统EDL框架通常依赖Dempster-Shafer证据理论中的不确定性度量,将模型输出的证据量转化为对预测的置信分布。但该研究指出,这种度量方式在某些情况下无法充分反映预测的校准质量。
作者提出了一种新的条件熵函数作为正则化项,直接约束证据分布的行为。条件熵在此处的作用是衡量在给定类别预测下剩余不确定性的集中程度,从而引导模型在正确分类时给出更锐利的证据分布,在不确定时保留足够的模糊性。
实验结果显示,这种正则化带来了更低的校准误差。与Deep Ensembles和MC Dropout等基于采样的方法相比,EDL模型在不确定性估计的可靠性上具有明显优势——后者通常需要多次前向传播,计算成本更高,而EDL仅需单次前向即可输出不确定性。
Dempster-Shafer证据理论 用"证据"而非概率来描述信念:模型对每个类别输出一个非负证据量,证据越多则该类别的可信度越高。将证据转换为Dirichlet分布后,其参数总量(即总证据加类别数)反映了模型掌握的信息量,总证据越少代表越不确定。传统EDL的不确定性度量常取类别数的比值形式,即"未分配证据"占全部信念质量的比例。
这种度量的局限在于它是一个聚合标量,只反映证据总量的多少,却无法刻画证据在各类别之间的分布形态——而校准质量恰恰取决于这种分布是否与真实正确率对齐。条件熵的思路不同:它以给定预测类别为条件衡量剩余类别的熵,能够感知证据是集中在某一类还是均匀铺开,因而可作为正则项直接塑造证据分布的形状。
可解释性分析:Grad-CAM焦点指数揭示模型行为
除了校准指标,研究团队还引入了一个名为“焦点指数”(focus index)的指标来分析Grad-CAM热图的空间集中度。该指数用于量化模型关注区域是分散还是集中在局部。
分析发现,与其他不确定性量化方法相比,EDL模型在正确分类和错误分类的眼底图像之间,焦点指数的分布分离度更大。这意味着EDL模型在“做对”和“做错”时,其空间注意力模式存在更清晰的差异。
尤其值得关注的是假阴性样本。这些被漏诊的青光眼图像,其Grad-CAM激活区域往往偏离视盘(optic disc),呈现局部化但位置错误的模式。视盘是青光眼评估中具有明确临床重要性的结构,这一发现说明模型的错误并非随机,而是与解剖学上关键区域的关注缺失相关。
Grad-CAM(梯度加权类激活映射)通过对目标类别得分关于最后一个卷积层特征图求梯度,再将梯度作为权重对特征图加权求和并经过ReLU,得到一张与输入同尺寸的热力图,标示模型决策时最依赖的空间区域。它无需修改网络结构,适用于任意CNN架构,但分辨率较粗,且热图反映的是"相关性"而非严格的因果贡献。
焦点指数正是在Grad-CAM热图基础上构造的派生指标,用于把"注意力是否集中"这一模糊描述量化为可统计比较的数值。其典型做法是对热图归一化后计算激活的空间集中程度(例如峰值区域占比、熵或与质心的距离等),数值越高表示注意力越集中于局部。由于它是单张图像的标量,研究者可以比较不同模型、正确与错误样本之间该指标的分布差异,从而把可解释性从个案可视化提升为群体层面的定量分析。
临床转化的潜在价值与局限
从临床角度看,这项工作的价值在于双重的改进:校准更好的不确定性使模型能够“知道自己不知道”,而更一致的可解释性模式则为医生提供了审查模型决策的线索。当模型对一张眼底图给出低不确定性但错误预测时,焦点指数可以提示注意力是否偏离了视盘区域。
需要留意的是,该研究的验证仅限于两个公开数据集,尚未涉及多中心前瞻性临床数据。条件熵函数在不同种族、不同相机设备下的泛化能力仍需进一步检验。此外,焦点指数作为可解释性度量,其与临床医生判断的一致性也尚未在读者研究中得到验证。
视盘(optic disc) 是视神经乳头在眼底图像上的表现,为视网膜神经节细胞轴突汇聚穿出眼球的区域,也是视网膜中央血管进出之处。青光眼的核心病理是视神经损伤,临床上以视杯与视盘的比值(杯盘比)增大、盘沿变窄等形态改变作为关键判据。因此视盘及其周边区域是青光眼判读中信息量最集中的解剖结构。
假阴性样本的Grad-CAM激活偏离视盘,意味着模型可能依赖了周边血管形态、图像亮度或拍摄伪影等与诊断无关的线索。这类"捷径学习"在数据集内部可能表现良好,却在跨设备、跨人群时失效,这也解释了为何作者强调跨中心验证的必要性。
对医学影像AI的启示
这项研究传递出一个信号:不确定性量化的设计不应脱离具体任务的结构性知识。条件熵的引入之所以有效,部分原因在于它契合了分类任务中“正确预测应伴随集中证据”的直觉。类似思路或可迁移至其他医学影像分类问题,尤其是那些假阴性代价高昂的筛查场景。
同时,将不确定性校准与可解释性分析结合起来的做法,为模型评估提供了更丰富的维度。单一指标(如AUC)无法揭示模型在错误样本上的行为模式,而校准误差与焦点指数的联合分析,能够更全面地刻画模型的可靠性边界。
对于关注AI安全落地的研究者而言,EDL路线的吸引力在于其推理效率——无需多次采样即可获得不确定性估计。如果条件熵正则化能够被更广泛地验证,它可能成为医学影像模型不确定性建模的一个实用选项。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。