停止烧钱:用n8n工作流大幅削减LLM Token成本的3步法

三步法将LLM只用于设计阶段,通过n8n工作流实现重复任务零Token成本运行
本文介绍了YouTube创作者Chris Levn提出的AI自动化成本优化三步法:第一步在探索阶段不惜用最强模型快速获得高质量结果;第二步让AI将满意的结果固化为可复用的"技能",将动态推理转化为确定性逻辑;第三步通过MCP协议将技能接入n8n工作流平台,使后续每次执行完全绕开LLM API调用,实现零Token成本。此外,该方案还具备自愈能力,可在运行出错时自动调查并修复。其核心工程原则是:把智能用在设计时,把确定性用在运行时——适合逻辑固定、需要高频重复执行的自动化任务,但对每次都需要真正语义理解或创造性生成的任务效果有限。
为什么你的AI应用在不断烧钱
调用大语言模型(LLM)的成本常常被低估。每一次向模型发送请求,无论是让它分析数据、生成文本还是执行推理任务,都在消耗Token——而Token直接对应真金白银的账单。对于需要反复执行相同逻辑的自动化场景,这种成本会呈线性甚至指数级增长。
YouTube创作者Chris Levn在其分享中提出了一个核心观点:很多开发者在重复性任务上持续调用LLM,等于让模型提供商不断“烧掉”你的Token预算。他给出了一套三步法,核心思路是——只在必要的探索阶段使用LLM,一旦逻辑固化就彻底脱离模型调用。
三步法拆解:从LLM探索到零成本执行
第一步:用最新模型,不要在这里省钱
这是一个反直觉但关键的建议。在构建和调试工作流的探索阶段,作者主张使用最新、最强的LLM模型,而不是为了省钱选择低配版本。
"I try to use the latest LLM model so I don't try to save the money at this step."
原因在于:探索阶段的目标是尽快得到正确、高质量的结果。使用能力更强的模型可以减少反复试错的次数,更快收敛到可用方案。在这个阶段过度抠成本,反而会因为模型能力不足导致多轮调用,总花费可能更高。真正的成本控制发生在后续环节,而非这里。
第二步:让AI把结果固化为“技能”(Skill)
当你对LLM输出的结果感到满意后,下一步不是继续调用它,而是让AI把这套逻辑生成为一个可复用的技能(Skill)。
"When you happy with the result, you ask the AI to generate the skill."
这一步是整个方法论的转折点。它把原本依赖实时模型推理的“动态逻辑”,转化为一份确定性的、可执行的描述。换句话说,你用LLM完成了一次性的“编程”工作,而不是让它在每次运行时都重新思考一遍。
第三步:通过MCP连接n8n,转化为零成本工作流
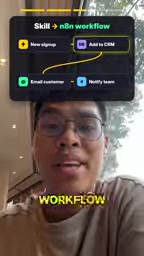
最后一步是将生成的技能落地到n8n(视频中读作"NAN")自动化平台。作者提到可以直接连接n8n的MCP服务器,把技能转化为一个标准的n8n工作流。
"So you can connect n8n MCP server directly to turn the skill into the n8n workflow... to execute that workflow without any further LLM cost. Zero cost at all."
一旦技能变成了n8n工作流,后续的每一次执行都走的是确定性的节点逻辑,不再触发任何LLM API调用。这意味着无论你运行多少次,都是零Token成本。LLM只在最初的“设计阶段”出现,运行阶段则完全由工作流引擎接管。
n8n 是一款开源的工作流自动化平台,类似于 Zapier 或 Make(原 Integromat),但支持自托管部署。它通过可视化的节点编排方式,将各类 API、数据库、云服务连接成自动化流程,适合技术型用户构建复杂的业务逻辑。每个"节点"代表一个具体操作(如 HTTP 请求、数据转换、条件判断),节点之间通过数据流串联,整个流程以确定性方式执行,无需每次调用 AI 模型。
MCP(Model Context Protocol) 是由 Anthropic 于 2024 年末提出并推动的开放协议,旨在为 LLM 提供标准化的工具调用与上下文接入接口。通过 MCP,AI 模型可以像调用函数一样与外部系统(如 n8n、数据库、文件系统)交互,而无需为每个平台单独编写适配代码。n8n 推出的 MCP 服务器支持,使 AI Agent 能够直接在 n8n 中创建、触发和管理工作流,从而实现"由 AI 设计流程、由引擎执行流程"的分离架构。
自愈式工作流:自动排错与修复
除了成本优化,作者还提到这套方案具备自愈(self-healing)能力。工作流在自动运行的过程中,一旦遇到错误,系统会自主调查错误原因并尝试修复。
"It's an automatic error fixing self-healing app. So it will run automatically and investigate the error and fix the error for you."
这一特性让自动化流程在生产环境中更具韧性。传统的硬编码工作流一旦遇到意外输入或接口变动就会中断,而带有自愈机制的流程能够减少人工介入的频率,提升整体可靠性。不过需要说明的是,原始素材中并未详细展开自愈能力的技术实现细节,这部分仍需结合实际工具文档验证。
自愈(Self-healing)工作流的概念在工程领域由来已久,常见于分布式系统的容错设计,例如 Kubernetes 的 Pod 自动重启机制。在 AI 自动化场景下,自愈能力通常通过以下方式实现:当工作流节点抛出异常时,错误信息被捕获并传递给 LLM,由模型分析错误原因、生成修复方案,再将修复后的逻辑写回工作流节点并重试。这本质上仍是一次 LLM 调用,只是触发条件从"常规执行"变为"异常处理",频率大幅降低。与纯硬编码的 try-catch 逻辑相比,AI 驱动的自愈对意料外的错误类型(如第三方 API 字段结构变更)有更强的适应性,代价是偶发的额外 Token 消耗。
这套方法论的价值与局限
从架构设计角度看,这套三步法本质上体现了一个成熟的工程原则:把智能用在设计时,把确定性用在运行时。LLM擅长开放式的推理与生成,但代价高昂且结果不完全可控;而工作流引擎擅长稳定、廉价、可重复的执行。两者结合,恰好扬长避短。
适用场景主要是那些逻辑相对固定、需要高频重复执行的任务,例如数据清洗、格式转换、固定流程的信息抓取等。对于这类任务,用LLM“教会”系统一次,之后就能零成本反复运行,收益极为明显。
局限同样存在:如果任务本身每次都需要真正的语义理解或创造性生成(比如每次都要撰写不同主题的原创内容),那么逻辑无法被完全固化,LLM调用就难以彻底省去。此外,MCP连接n8n、技能生成等环节的具体操作,原始分享较为概括,实际落地仍需参考对应平台的详细配置流程。
小结
Chris Levn的三步法为控制AI自动化成本提供了一个清晰的思路框架:探索阶段大胆用最强模型求速度与质量,满意后让AI固化为技能,再通过MCP接入n8n实现零Token成本的持续运行,并借助自愈机制提升稳定性。对于正在构建AI工作流、却被Token账单困扰的开发者来说,这是一个值得尝试的优化方向。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。