Token总是不够用?这套五层方法论帮你省下真金白银
通过分层优化输入、输出、上下文与工具,把Token花在刀刃上。
文章系统拆解了AI使用中Token浪费的根源与优化路径。作者指出,冗余Prompt、过大上下文、过度推理和冗长输出是主要浪费来源,并用“有效Token÷总消耗”衡量效率。核心认知有两点:输出Token通常比输入贵数倍,限制无必要输出的ROI更高;工具加载过多会隐性占用系统提示词。优化分为五层:输入求确定而非求短、模型与工具按需分级、控制上下文膨胀(一事一会话、稳定前缀复用缓存、超长任务先摘要)、借助上下文压缩与代码检索类工具,最后建立持续度量习惯。自查清单帮助定位浪费最严重的一层,核心口诀为“少喂、少吐、多复用”。
为什么你的Token总在悄悄溜走
你有没有算过这样一笔账:每个月花在AI模型上的钱,有多少真正变成了有用的输出?国外模型价格本就高昂,而OpenAI近期发布新模型后,有分析指出后续高频使用档位的Token额度可能面临调整,使用成本只会越来越贵。
一位开发者在B站直播中系统拆解了「如何节约并高效利用Token」的问题。他把Token浪费的根源归结为几类:冗余的Prompt信息、过大的上下文、过度推理(把推理等级调到极高甚至Ultra档),以及不必要的冗长输出。
衡量Token利用效率有个简单指标:有效Token ÷ 总消耗。这个比值越接近1越好,但完全达到1并不现实——模型本身不够精准,平台也不会让你这么用。
有两个认知必须先建立起来。第一,输出Token通常比输入贵得多。 以常见定价为例,输入100万Token约2块钱,输出往往在8到10块左右,差距在数倍以上。所以限制没必要的输出,ROI远高于优化输入。第二,工具加载过多会吃掉大量上下文。 你装的每一个Skill和MCP,其简介都会被预装进系统提示词里,看起来方便,隐性成本却很高。
五层方法论:从认知到体系
这位创作者把优化路径分成五个层次:认知层搞清楚钱花在哪;输入输出层做精简;模型与工具层按需匹配;上下文层控制膨胀;体系层建立持续度量习惯。
不需要一次全部做到位,找到当前浪费最严重的那一层先下手即可。
第一层:把「猜」变成「执行」
输入优化的核心不是越短越好,而是越确定越好。
以计算留存率为例。含糊的问法是「帮我算一下各小组的留存率」,模型得猜是次日留存还是7日留存、分母是什么、活跃怎么定义。明确的写法是:7日留存率 = 第7天内的活跃用户 ÷ 当前日新增用户;活跃定义为至少一次App打开操作;新增定义为首次注册;按group id分组;日期范围给定。模型拿到这种输入就不需要试探和试错,省下的都是真金白银。
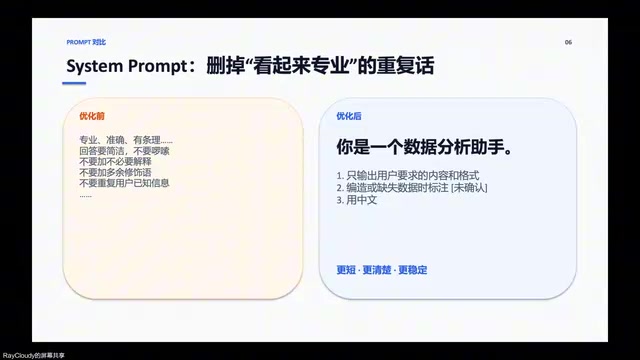
系统提示词同样要瘦身。「你要专业、准确、有条理,同时回答要简洁、不要啰嗦、不要加不必要的解释……」这类话看似专业,对模型来说大部分是废话。改成「你是一个数据分析助手,输出格式为Markdown,语言为中文」,更短、更清楚,输出反而更稳定。
结构化输入也值得养成习惯:用编号列出三个问题,或者用JSON替代长段自然语言描述,模型理解成本更低。输出端则要限制字段、格式和篇幅——300字能说清的事,没必要让模型写600字。
系统提示词(System Prompt) 是模型每次推理时最先接收的固定指令,通常由平台预设或用户自定义,用于定义模型角色、输出格式与行为边界。它不随对话轮次改变,但会持续占用输入Token。因此,系统提示词应只保留必要的角色定义与硬性约束,而非堆砌“专业、准确、有条理”等泛化形容词——这类描述对模型行为影响微弱,却会抬高每次调用的基础成本。精简系统提示词是输入优化中回报最直接的动作之一。
第二层:模型分级与工具精简
不是所有任务都值得动用最强模型。复杂问题用强模型,一般难度用中等模型,简单任务用小模型甚至上一两代模型就够了。强模型的Token消耗速率更快、单价更贵,从强到弱价格递减。
确定性的操作——查询、过滤、计算、缓存——不必每次都让模型读完再算。让模型生成一段一次性执行脚本嵌入流程,后续数据源进来直接由代码处理,既快又省。
工具层面有个反直觉的结论:能力越多不等于效率越高。 日常高频使用的Skill或MCP,按经验判断通常不会超过10个,其余可以默认关掉或卸载。指定固定的工具集,比全量挂载省下可观的输入开销。
MCP(Model Context Protocol,模型上下文协议) 是一套让模型以标准化方式调用外部工具与数据源的开放协议。每个MCP服务都会向模型暴露一份工具清单及其简介,这些描述会被预加载进系统提示词。挂载的MCP越多,输入上下文越臃肿,且模型在选择工具时也更容易犹豫或选错。因此,按任务类型只启用必要的MCP、关闭长期不用的服务,是控制隐性Token开销的关键手段。
第三层:上下文膨胀才是真正的敌人
很多人以为上下文只包含自己的输入和输出,实际上模型处理任务时会持续从浏览器、知识库、代码库里检索信息塞进上下文,这个过程本身极其消耗Token。
一事一会话是最容易落地的操作。代码实现、需求分析、部署上线全串在一个对话里,每次交互都会把之前的全部历史重新塞进去,而部署环节根本用不到代码生成的大段内容。拆开做,立竿见影。
复用缓存依赖稳定的前缀和工具顺序。用了一个叫ABC的Skill,中途改成ABCD,缓存就失效了,模型要重新加载一遍,之前的信息再塞一次。名称、前缀、工具顺序尽量别动。
遇到超长任务逼近上下文上限时,让模型先做摘要压缩,保留结论后新开一个会话继续,而不是把整个过程反复回放。
KV缓存(Key-Value Cache) 是推理时复用已处理上下文的机制:当新请求的前缀与之前完全一致时,模型无需重新计算这部分内容,从而降低延迟与成本。这也是“稳定前缀”能省钱的原因——系统提示词、工具顺序、Skill名称一旦变动,缓存即失效,模型必须从头重算。多数平台的缓存有效期较短(常见为5至10分钟),因此连续追问比隔很久再问更容易命中缓存,而频繁改动开头内容则会让缓存收益归零。
值得装上的几类工具
创作者推荐的工具都面向模型自动调用,用户只需安装,不需要自己操作。
上下文压缩类以kintestmode为代表。官方数据显示,它能让原始数据尽量不进上下文,精炼结果可减少约98%的上下文占用;压缩后恢复的效率是传统方式(知识库追踪、文件编辑、错误恢复)的六倍;让模型生成计算脚本而非整份数据入上下文,提升达一百倍。适合Playwright浏览器调用、CSV表格、日志输出这类「大输入、小结论」场景。
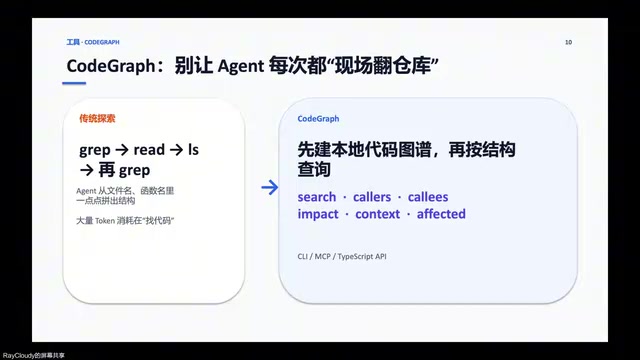
代码与知识检索类以CodeGraph为代表。传统方式是grep反复读取、逐字遍历,Token在找代码的过程中大量流失。CodeGraph通过本地索引建立快速查询能力,信息不上传,安装后执行初始化即可,默认提供CLI和MCP能力供本地Agent使用。它在老项目改bug、大型仓库的结构性问答(比如「订单流程怎么走」「缓存在哪失效」)中价值最大。需要注意:静态分析不等于运行时真相,动态导入、反射等机制存在盲区,涉及这类代码仍需人工判断。
输出压缩类如RTK和headroom,用于压缩diff、test、log等输出内容;消耗观测类如tokenlizer,帮你看清预算分布与缓存命中率,定位浪费最严重的环节。
30秒自查:你的浪费在哪一层
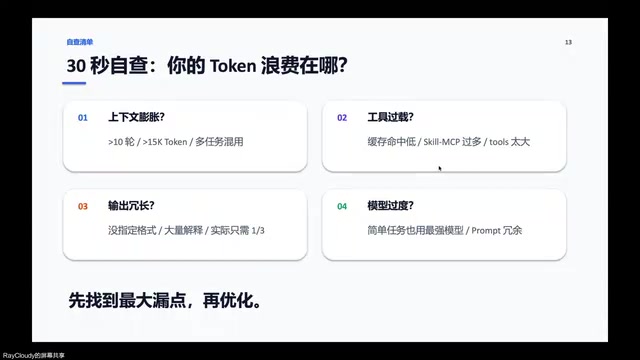
直播中给出的自查清单有四条:
- 上下文膨胀——单次对话超过10轮,或单任务超过15k Token,或多个任务混用
- 工具过载——缓存命中率低,装了过多Skill和MCP
- 输出冗长——没按指定格式输出,附带大量解释性文字,实际只需要三分之一的内容
- 模型过度使用——简单任务动用了最强模型
直播间的实时反馈中,上下文膨胀(第一项)被提及最多。对应的解法很直接:不要多任务混用;任务确实长就先摘要再新开会话。工具过载的解法是把非高频工具默认关闭。缓存命中方面要注意时效——部分模型的缓存有效期为5分钟或10分钟,回答完上一个问题后尽快追问能命中缓存,超时则重新计算。
把优化变成习惯
最后一层是体系化。优化不是一次性动作,而是可度量、可循环的过程。持续观察缓存命中率、工具调用情况和Token分布,用大约两成的时间解决最痛的那个点,拿到大部分收益就已足够。
具体做法有三条:Prompt模板化,把高频场景沉淀成固定模板,每次只替换时间、指标等变量;批处理合并,与其反复要求「再起一个名字」,不如一次让它生成10个候选;持续度量,让数据告诉你下一轮该优化哪里。
整场分享的核心口诀只有六个字:少喂、少吐、多复用。 低消耗不等于降低能力,而是把Token花到真正有价值的地方。
常见疑问
这些工具需要熟悉才能用吗?不需要。除tokenlizer这类观测工具由人来看,其余工具都是给模型调用的,装上即可。它们不限于特定模型,国外模型适配更好,国内模型装上后也会自动调用。生图和视频场景的节约,同样可以套用模板化思路:固定尺寸参数,把水墨、赛博、二次元等风格沉淀为提示词模板反复复用。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。