TomasuLLM:用乱序推测执行给LLM智能体提速
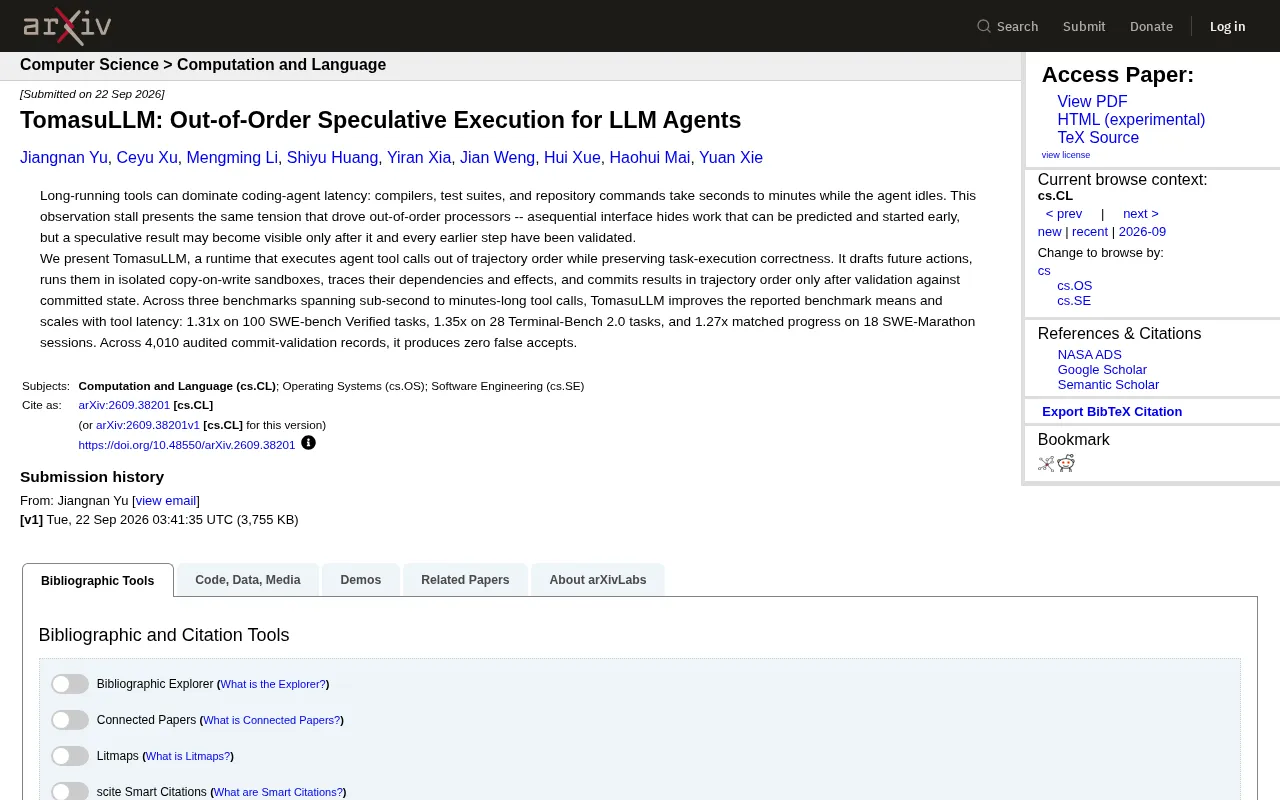
TomasuLLM将CPU乱序执行思想引入AI智能体,让工具等待时间重叠,实现最高1.35倍无损加速。
编码类AI智能体在调用编译器、测试套件等慢速工具时会陷入串行等待,白白浪费大量时间。TomasuLLM借鉴CPU界的Tomasulo乱序执行算法,在智能体运行时层面实现"乱序执行、顺序提交":系统在隔离的写时复制沙箱中提前推测执行后续步骤,追踪依赖关系,只有当推测结果按原始轨迹顺序验证通过后才正式提交,从而将本应串行的等待时间重叠压缩。在SWE-bench、Terminal-Bench 2.0、SWE-Marathon三项基准上,该方案实现了1.27–1.35倍加速,且加速比随工具延迟增长而扩大。更关键的是,在4010条提交验证记录中实现零误接受,证明推测执行完全不以牺牲正确性为代价。这代表了将成熟体系结构思想系统性迁移至AI智能体工程的新方向。
编码智能体的延迟瓶颈:等待工具的尴尬
长时间运行的工具调用,正在成为编码类AI智能体最隐蔽的性能杀手。编译器、测试套件、仓库命令——这些操作往往需要数秒到数分钟才能完成,而在这段时间里,智能体只能干等着,白白浪费算力和响应时间。
arXiv最新论文提出的TomasuLLM,正是瞄准了这一痛点。它的核心洞察颇为巧妙:智能体遭遇的这种"停顿"(stall),本质上与当年推动乱序处理器(out-of-order processor)诞生的问题如出一辙。一个顺序执行的接口,表面上掩盖了大量可以被预测并提前启动的工作,但推测执行的结果只有在它本身及其之前的所有步骤都被验证通过后,才能对外可见。
这个类比并非牵强附会。CPU领域的Tomasulo算法(论文名称TomasuLLM显然是对其致敬)早已证明,通过乱序执行+依赖追踪+顺序提交,可以在不破坏程序正确性的前提下大幅提升吞吐。TomasuLLM把这套成熟的硬件思想迁移到了LLM智能体的运行时层面。
Tomasulo算法由IBM工程师Robert Tomasulo于1967年为IBM System/360 Model 91浮点单元设计,是现代乱序处理器的基石。其核心思想是引入"保留站"(Reservation Station)来缓存待执行的指令及其操作数,配合"公共数据总线"(Common Data Bus)实现结果的广播与动态依赖解析。当某条指令依赖的操作数尚未就绪时,后续无依赖的指令可以绕过它提前执行,从而隐藏数据相关带来的流水线停顿(pipeline stall)。该算法的精髓在于将"执行顺序"与"提交顺序"解耦:指令可以乱序完成,但通过重排序缓冲区(Re-Order Buffer, ROB)确保结果按程序原始顺序对外可见,从而在维持串行语义的同时榨取并行性。这一思想被Intel Pentium Pro、ARM Cortex系列等几乎所有现代高性能处理器沿用至今。
TomasuLLM 如何工作:乱序执行但顺序提交
TomasuLLM是一个运行时系统,它让智能体的工具调用能够脱离轨迹顺序(out of trajectory order)执行,同时保证任务执行的正确性。整个机制可以拆解为四个关键环节:
预测与隔离沙箱
系统会"起草"(draft)智能体未来可能执行的动作,并在隔离的写时复制(copy-on-write)沙箱中提前运行它们。写时复制是关键设计——它让推测执行的副作用被限制在沙箱内,不会污染真实的已提交状态,同时又避免了完整复制环境带来的开销。
写时复制(Copy-on-Write, CoW)是操作系统中的经典内存管理技术,广泛用于进程fork操作和虚拟机快照。其原理是:多个执行上下文最初共享同一份内存页,只有当某个上下文试图"写入"时,系统才为其单独复制一份副本,修改仅在该副本上生效。这样既避免了预先为每个沙箱分配完整内存的巨大开销,又保证了各沙箱之间的隔离性。在TomasuLLM的场景中,每个推测执行分支从当前已提交状态"分叉"出一个沙箱——文件系统写入、环境变量修改、shell状态变更等副作用都被局限在该沙箱内。一旦推测结果被验证通过,沙箱内的变更才会被"合并"回主状态;若验证失败,直接丢弃沙箱即可,主状态零污染。
依赖追踪与效果记录
在推测执行的过程中,TomasuLLM会追踪每个动作的依赖关系和产生的副作用(effects)。这一步相当于CPU乱序执行中的记分板(scoreboard)机制,确保系统清楚知道哪些结果依赖于哪些前置条件。
顺序验证与提交
最关键的一环是:推测结果只有在按轨迹顺序针对已提交状态验证通过后,才会被正式提交。也就是说,执行可以乱序、可以提前,但对外可见的结果必须严格按原始顺序兑现。这正是保证正确性的核心——如果某个推测动作的前置条件在真实执行中发生了变化,该推测结果就会被丢弃。
这种"乱序执行、顺序提交"的架构,让智能体能够在等待一个慢速工具时,提前把后续大概率会执行的步骤跑起来,一旦验证通过就能立即兑现,从而把本应串行的等待时间重叠起来。
实测效果:延迟越高,收益越大
TomasuLLM在三个基准测试上进行了验证,覆盖了从亚秒级到分钟级的不同工具延迟场景:
- SWE-bench Verified:在100个任务上实现 1.31倍 加速
- Terminal-Bench 2.0:在28个任务上实现 1.35倍 加速
- SWE-Marathon:在18个会话上实现 1.27倍 的匹配进度提升
一个值得关注的规律是:加速比随工具延迟增长而扩大。这完全符合直觉——工具调用越慢,智能体空等的时间越长,推测执行能够重叠和隐藏的工作也就越多。对于那些动辄跑几分钟测试套件的大型代码库场景,这种架构的价值会更加突出。
SWE-bench是当前评估AI编码智能体最具影响力的基准之一,由Princeton NLP团队构建,测试集来自真实GitHub仓库的issue修复任务,要求智能体读取问题描述后自主定位并修改代码,通过官方测试用例视为成功。SWE-bench Verified是其人工审核子集,过滤掉了描述模糊或测试用例本身有问题的条目,结果更可信。SWE-Marathon则是更长周期的多轮会话评测,侧重考察智能体在持续工程任务中的累积表现,工具调用次数和单次调用延迟都显著高于单issue修复场景,因此更能体现延迟隐藏技术的价值。Terminal-Bench 2.0聚焦纯命令行环境下的任务完成能力,工具调用以shell命令为主,延迟分布与真实开发环境更为接近。
正确性才是真正的考验
推测执行最大的风险在于"算错了还当真"。对于编码智能体而言,一次错误的提交可能意味着破坏代码库、污染测试结果,后果远比性能损失严重。
TomasuLLM在这一点上给出了相当硬核的数据:在 4,010 条经审计的提交-验证记录 中,系统产生了 零误接受(zero false accepts)。换句话说,没有任何一个本不该被采纳的推测结果被错误地提交为真实状态。
这个零误报的结果,是TomasuLLM能否从研究走向实用的分水岭。性能提升固然诱人,但如果以牺牲正确性为代价,对于生产环境中的编码智能体来说是不可接受的。顺序提交+验证机制在这里发挥了守门员的作用。
对AI智能体工程的启示
TomasuLLM的意义不止于一个具体的加速方案,它代表了一种思路转向:把成熟的计算机体系结构思想系统性地引入LLM智能体运行时。
过去几十年,CPU设计者为了在"顺序语义"和"并行执行"之间取得平衡,积累了大量精巧的技术——乱序执行、推测执行、依赖追踪、提交队列。如今,当LLM智能体面临类似的"接口串行、工作可并行"矛盾时,这些经典思想正好可以被重新激活。
随着智能体越来越多地承担真实的工程任务——运行测试、编译构建、执行命令行——延迟隐藏将成为一个核心优化方向。TomasuLLM证明了在不改变智能体逻辑、不牺牲正确性的前提下,通过运行时层面的推测执行就能拿到可观的加速。这对于追求响应速度的AI编程工具来说,是一条值得深挖的路径。
当然,论文目前仍处于早期阶段(arXiv新提交),其在更复杂的多工具、多依赖场景下的表现,以及写时复制沙箱带来的额外内存开销,都有待进一步观察。但作为一个把硬件智慧迁移到AI运行时的尝试,TomasuLLM提供了一个颇具启发性的范式。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。
泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。
74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。