统计推断基础详解:样本方差的三种收敛性证明
通过引入辅助变量与三大极限定理,严格证明样本方差的三种收敛性。
本文以样本方差估计量 $S_n$ 为核心,系统证明其三种收敛性:依概率收敛、几乎必然收敛及渐近正态性。证明的核心技巧是引入辅助变量 $Y_i=(X_i-\mu)^2$,将问题转化为标准 iid 序列问题。利用收敛性的强弱链条(几乎必然收敛⇒依概率收敛),优先证明更强的命题 (b),再由强推弱获得命题 (a)。命题 (c) 则借助中心极限定理与 Slutsky 定理,证明 $\sqrt{n}(S_n-\sigma^2)$ 依分布收敛到 $N(0,\tau)$,揭示样本方差的渐近正态性。整个框架展示了强大数定律、连续映射定理与 Slutsky 定理的协同运用。
统计推断是理解现代数据科学与机器学习理论的基石。在这篇教程中,我们围绕一个经典问题展开:给定独立同分布(iid)的随机变量序列,如何证明样本方差估计量 $S_n$ 分别在概率意义、几乎必然意义下收敛到总体方差 $\sigma^2$,并进一步分析其渐近正态性。这三种收敛性及其相互关系,是统计推断考试与研究中的高频考点。
问题设定与准备工作
设 $X_1, X_2, X_3, \dots$ 为独立同分布随机变量,方差 $\tau$ 有限。定义样本方差估计量:
$$S_n = \frac{1}{n}\sum_{i=1}^{n}(X_i - \bar{X})^2$$
我们需要证明三个命题:
- (a) $S_n$ 依概率收敛到 $\sigma^2$;
- (b) $S_n$ 几乎必然收敛到 $\sigma^2$;
- (c) $\sqrt{n}(S_n - \sigma^2)$ 依分布收敛到正态分布。
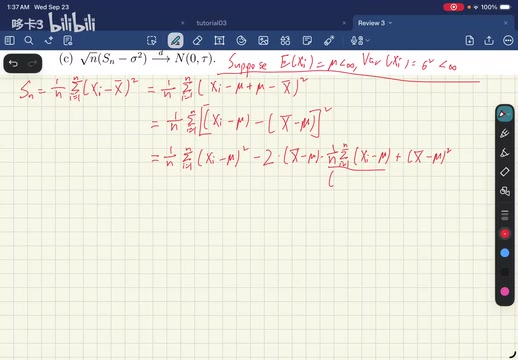
在正式证明前,关键的一步是对 $S_n$ 做代数变形。技巧在于对括号内减去并加上均值 $\mu$,即写成 $(X_i - \mu) + (\mu - \bar{X})$,这样并不改变原表达式,却能拆分出有用的结构。
展开后可得:
$$S_n = \frac{1}{n}\sum_{i=1}^{n}(X_i - \mu)^2 - (\bar{X} - \mu)^2$$
注意交叉项经过整理后恰好并入了 $(\bar{X}-\mu)^2$。假设 $E[X_i] = \mu$、$\mathrm{Var}(X_i) = \sigma^2$ 且均有限,虽然题干未明确给出这些量,但这是标准假设。
引入辅助变量简化结构
为了利用大数定律与中心极限定理,我们令 $Y_i = (X_i - \mu)^2$。这个替换是整个证明的核心枢纽,因为它把二次项转化为一列新的 iid 随机变量。
首先计算其期望:
$$E[Y_i] = E[(X_i - \mu)^2] = \mathrm{Var}(X_i) = \sigma^2$$
这正是我们希望估计的目标值。其次,$Y_i$ 的方差恰为题设中给定的 $\tau$,且有限。由于 $X_1, X_2, \dots$ 是 iid 的,作为它们的函数,$Y_i$ 同样是 iid 的。至此,$Y_i$ 具备了应用极限定理所需的全部条件:iid、均值有限($\sigma^2$)、方差有限($\tau$)。
命题 (a) 与 (b):从几乎必然收敛出发
三种收敛性存在明确的强弱关系:几乎必然收敛最强,可推出依概率收敛,而依概率收敛又可推出依分布收敛。因此命题 (b) 比命题 (a) 更强,只要证明了 (b),(a) 便自然成立。这是一个高效的解题策略——先攻最强的结论。
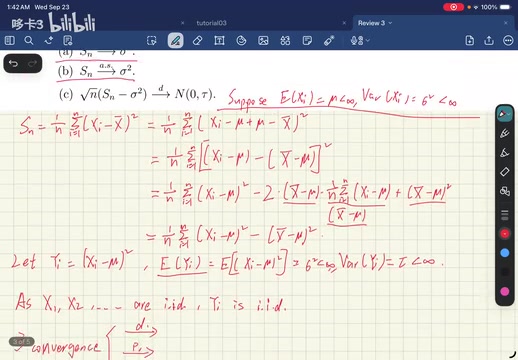
证明 (b) 时分两部分处理。第一部分:由于 $Y_i$ 是 iid 且均值为 $\sigma^2$,根据强大数定律(SLLN),样本均值 $\bar{Y}_n$ 几乎必然收敛到 $\sigma^2$。
第二部分:$X_i$ 是 iid 且期望为 $\mu$,同样由强大数定律得 $\bar{X}$ 几乎必然收敛到 $\mu$。再借助连续映射定理,$(\bar{X}-\mu)^2$ 几乎必然收敛到 $0$。
最后用 Slutsky 定理将两部分组合:
$$S_n = \bar{Y}_n - (\bar{X}-\mu)^2 \xrightarrow{a.s.} \sigma^2 - 0 = \sigma^2$$
命题 (b) 得证。由几乎必然收敛推出依概率收敛,命题 (a) 随之成立。
**强大数定律(SLLN)指出:若 $Z_1, Z_2, \dots$ 是 iid 随机变量且 $E[|Z_1|] < \infty$,则样本均值 $\bar{Z}n = \frac{1}{n}\sum{i=1}^n Z_i$ 以概率 1 收敛到 $E[Z_1]$,即 $P(\lim_{n\to\infty}\bar{Z}_n = E[Z_1]) = 1$。这比弱大数定律(WLLN)**更强——WLLN 只保证对任意 $\varepsilon > 0$ 有 $P(|\bar{Z}_n - E[Z_1]| > \varepsilon) \to 0$,即依概率收敛,而 SLLN 保证的是"几乎所有样本路径最终都会收敛"这一更强的逐样本路径意义。**连续映射定理(CMT)**则补充了一个重要工具:若 $W_n \xrightarrow{a.s.} c$ 且函数 $g$ 在点 $c$ 处连续,则 $g(W_n) \xrightarrow{a.s.} g(c)$。本文中取 $g(x) = (x - \mu)^2$,连续性显然成立,因此 $\bar{X} \xrightarrow{a.s.} \mu$ 直接推出 $(\bar{X}-\mu)^2 \xrightarrow{a.s.} 0$,无需额外论证。
命题 (c):渐近正态性的证明
命题 (c) 需要证明 $\sqrt{n}(S_n - \sigma^2)$ 依分布收敛到正态分布。同样将其拆分为两部分处理。
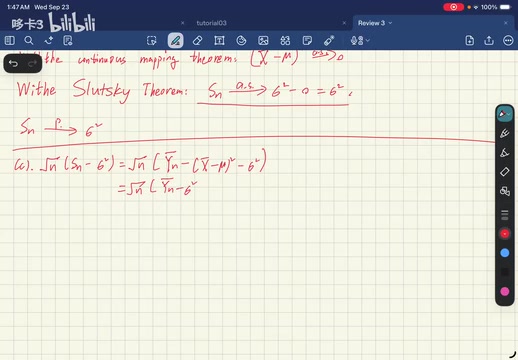
将 $S_n$ 代入并整理:
$$\sqrt{n}(S_n - \sigma^2) = \sqrt{n}(\bar{Y}_n - \sigma^2) - \sqrt{n}(\bar{X}-\mu)^2$$
第一部分:$Y_i$ 是 iid,均值 $\sigma^2$,方差 $\tau$ 有限,直接套用中心极限定理(CLT):
$$\sqrt{n}(\bar{Y}_n - \sigma^2) \xrightarrow{d} N(0, \tau)$$
第二部分:将 $\sqrt{n}(\bar{X}-\mu)^2$ 巧妙拆写为 $\sqrt{n}(\bar{X}-\mu)\cdot(\bar{X}-\mu)$。
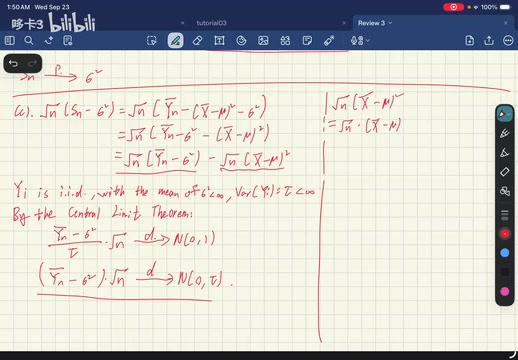
其中 $\sqrt{n}(\bar{X}-\mu)$ 由中心极限定理收敛到 $N(0, \sigma^2)$,而另一个因子 $(\bar{X}-\mu)$ 由大数定律收敛到 $0$。两者相乘,由 Slutsky 定理可知整个第二部分依概率收敛到 $0$。
综合两部分,再次应用 Slutsky 定理:
$$\sqrt{n}(S_n - \sigma^2) \xrightarrow{d} N(0, \tau)$$
命题 (c) 得证。
Slutsky 定理是组合多个极限结果的核心工具,其主要内容为:若 $A_n \xrightarrow{d} A$ 且 $B_n \xrightarrow{p} c$($c$ 为常数),则 $A_n + B_n \xrightarrow{d} A + c$,$A_n \cdot B_n \xrightarrow{d} c \cdot A$。注意该定理要求其中一个序列必须收敛到常数,两个序列同时依分布收敛时一般不能直接相加或相乘。在命题 (c) 的证明中,第二部分 $\sqrt{n}(\bar{X}-\mu)^2$ 被拆写为两因子之积:$\sqrt{n}(\bar{X}-\mu)$ 依分布收敛到 $N(0,\sigma^2)$,而 $(\bar{X}-\mu)$ 依概率收敛到常数 $0$;由 Slutsky 定理,乘积依分布收敛到 $0 \cdot N(0,\sigma^2) = 0$,即依概率收敛到 $0$。最终将"依分布收敛到 $N(0,\tau)$"的第一部分与"依概率收敛到 $0$"的第二部分相减,再次应用 Slutsky 定理,得到整体结果 $N(0,\tau)$。
方法论小结
这道题贯穿了统计推断中最重要的几个工具,也揭示了它们的使用条件与配合逻辑:
- 收敛性层级关系:几乎必然收敛 ⇒ 依概率收敛 ⇒ 依分布收敛,理解这一链条能大幅简化证明路径。
- iid 与有限矩条件:使用大数定律需要 iid 与有限均值;使用中心极限定理还需有限方差。这些前置条件缺一不可。
- 辅助变量替换:令 $Y_i=(X_i-\mu)^2$ 是化繁为简的关键,把非线性问题转化为标准的 iid 序列问题。
- Slutsky 定理与连续映射定理:在组合多个收敛结果时不可或缺。
掌握这套证明框架,不仅能应对考试,更能为深入理解估计量的一致性与渐近分布打下坚实基础。
相关推荐
Meta Muse为何爆红?AI创作工具新范式深度解析
Meta Muse为何爆红?AI创作工具新范式深度解析
Meta推出的AI创作工具Muse凭借多模态融合、低门槛交互和社交传播优势迅速走红。本文深度解析Muse爆红背后的产品逻辑、用户真实反馈,以及字节跳动、腾讯等国内玩家的竞争机会。
Claude Code 完全入门:非程序员也能一下午造出真实应用
非程序员如何用 Claude Code 一下午构建真实应用?本文完整拆解 theMITmonk 的入门教程,包括 BITE 四步框架、MVP 思路、模型分工技巧,以及从计时器到关系管理器 Orbit 的实战全过程。
Claude Code是什么?零基础程序员的AI编程新工具
Claude Code 是什么?本文解析这款 AI 编程工具如何让零基础程序员快速上手,从入门到构建企业级 Agent 的学习路径,以及如何理性看待训练营类课程。