同款模型三大AI Agent横评:DeepSeek Harness、ZCode与Hermes谁更强

同款GLM Flash模型横评三大Agent框架,DeepSeek Harness综合最优,框架选择比升级模型更立竿见影。
一位B站UP主在控制模型与提示词不变的前提下,对DeepSeek Harness、ZCode和Hermes三个Agent框架进行了横向测评,任务是生成「最美丽的文件」。结果显示:DeepSeek Harness以28分钟完成任务、生成1313行代码,视觉效果最惊艳,综合排名第一;ZCode代码最少(893行)但效果稳健,排名第二;Hermes耗时最长却排名末位。测评揭示了一个关键结论:同一模型在不同Agent框架中的表现差距显著,框架对模型的「激发方式」直接决定产出质量,代码行数与最终效果并不成正比,开发者在升级模型前应优先考虑优化Agent框架的选择。
在AI Agent工具层出不穷的今天,一个常被忽视的问题是:同样的模型、同样的提示词,放进不同的Agent框架里,最终产出会有多大差异?B站一位UP主用一次实测给出了直观答案——差异比想象中更大。
本次测评统一使用 GLM 4.5 Flash(视频中口述为「GIM 5.3 Flash」,推测为GLM系列Flash模型)作为底层模型,配合完全相同的提示词,分别在三个Agent环境中运行:DeepSeek Harness(视频中称Harmonies)、ZCode(原配环境)以及Hermes。评判标准很纯粹——「创建你能想到最美丽的文件,让人们看到时会发出惊叹」。
测试设定:控制变量下的Agent对决
这次测评最有价值的地方在于「控制变量」。模型不变、提示词不变,唯一变化的是承载模型的Agent框架。这样得出的差异,几乎完全来自Agent本身对任务的拆解方式、代码生成策略以及执行链路的设计。
提示词本身相当开放——要求生成一个「最美丽的文件」,这实际上是在考验Agent如何理解模糊需求、如何自主发挥创造力,以及如何把抽象的「美」转化为可运行的代码。
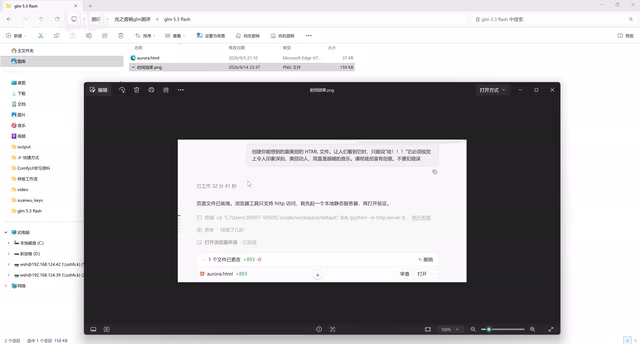
对于开发者来说,这种开放式任务比结构化编程任务更能暴露Agent的「思维方式」差异。同样一句话,有的Agent会保守地生成基础页面,有的则会主动加入音乐、动效、交互切换等增强体验的元素。
Agent框架(Agent Framework)是指在大语言模型之上封装的一套执行层,负责将用户的自然语言指令拆解为可执行的子任务序列,并调度代码生成、工具调用、错误重试等能力。同一底层模型在不同框架下,本质上是在被不同的「思维脚手架」引导——框架决定了模型会被要求先做什么、如何分配上下文窗口、以及在生成失败时如何兜底。这也是为什么控制变量测评中,框架差异能直接影响最终产出质量:它改变的不是模型的权重,而是模型被调用的方式与频次。
ZCode原配环境:最简洁却不最差
ZCode作为GLM Flash模型的「专属原配」环境,用时32分41秒完成任务,生成代码893行——是三者中最短的。
输出效果是一个带背景音乐的可下滑页面,UP主形容其音乐「更接近白噪音」。虽然代码量最少,但表现并不垫底。这印证了一个常见误区:代码行数与最终效果并不成正比。更短的代码有时意味着更精炼的实现,而非功能缺失。
ZCode的这次表现,在UP主的整体排名中位列第二,属于稳扎稳打的类型。对于追求代码可维护性、不希望产出冗余逻辑的场景,这种「够用即止」的风格反而是优势。
DeepSeek Harness:速度与效果双赢
DeepSeek Harness(口述Harmonies)是本次测评的最大赢家。它仅用28分钟就完成任务,比ZCode还快,且采用「标准模式」生成了1313行代码——比ZCode多出四五百行。
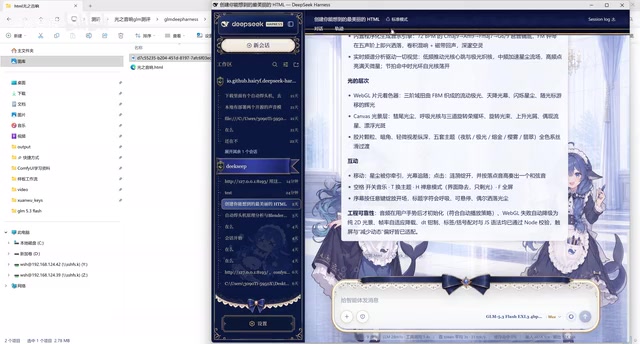
更关键的是效果。UP主直言其页面「有点炫酷」,惊艳到「光是当电脑锁屏都很美」,并且支持切换。在「速度更快 + 代码更丰富 + 视觉更惊艳」的三重优势下,DeepSeek Harness被评为本次横评的第一名。
这一结果值得玩味:更多的代码量在这里对应了更丰富的视觉表现,而非无意义的膨胀。这说明Harness框架在任务拆解和创造力引导上,可能对同一模型进行了更充分的「激发」。同样的GLM Flash,在不同Agent里就像被赋予了不同的发挥空间。
「Harness」在AI测评语境中通常指测试驱动的执行框架,原本用于规范化评估模型性能。DeepSeek将其引入Agent场景后,该框架以结构化的任务分解见长——将模糊指令切割为多个可验证的子目标,逐步生成并校验代码片段。这种「边生成边验证」的机制,可能是其在本次测评中代码量更大但执行速度反而更快的原因之一:每步产出更具方向性,减少了大段回溯和重写的概率,最终积累出视觉层更丰富的页面效果。
Hermes:耗时最长,效果垫底
第三个环境Hermes的表现相对逊色。UP主坦言自己「看了半天不知道怎么看它用了多少时间」,但推测其耗时应该是三者中最长的,明显超过ZCode和DeepSeek Harness。
综合最终产出效果,Hermes在本次测评中排名第三。耗时更长却未能换来更好的结果,这提示我们:Agent框架的执行效率与产出质量并不总是线性相关,框架设计的合理性至关重要。
从这场横评能看出什么
这次非严谨但直观的测评,给出了几个有参考价值的结论:
Agent框架的差异被严重低估。 同一个模型在不同Agent里的表现,从速度到最终效果都拉开了明显差距。选对Agent,可能比升级模型带来的收益更立竿见影。
代码行数不等于质量。 ZCode最短却不最差,Hermes耗时最长却排名末位。评判Agent应该看最终交付效果,而非中间过程的数量指标。
开放式任务是检验Agent创造力的好方法。 「创建最美丽的文件」这类模糊需求,能有效区分出Agent在自主发挥、体验增强上的能力上限。
最终UP主给出的排名是:DeepSeek Harness > ZCode > Hermes。当然,这是基于单次、单一模型、单一提示词的主观测评,样本量有限,结果仅供参考。要得出更可靠的结论,还需要在更多任务类型和模型组合下反复验证。
对于正在选型的开发者,这场横评的核心启示很简单:在投入更贵的模型之前,先试试换个Agent框架。
相关推荐
HuggingFace开始内容审查?下架模型引发社区争议
HuggingFace下架一个标注「用于网络攻击」的去审查GLM模型,引发开源社区关于内容审查的争议。本文梳理事件始末,分析abliterated模型的敏感性,以及平台治理透明度这一真正痛点。
Cayu:构建长周期领域智能体的开源Python框架
Cayu 是一个用于构建领域专用、长周期 AI 智能体的开源 Python 框架。它让开发者围绕工具、知识与业务规则组装 harness,并提供集成的持久化运行时处理会话、状态、恢复、审批与可观测性。本文解析其核心思路与落地场景。
社交媒体真的在伤害青少年吗?一场悬而未决的科学争论
社会心理学家乔纳森·海特在《焦虑的一代》中将青少年心理健康下滑归咎于社交媒体,但这一论断在学术界引发分歧。本文探讨相关性与因果关系的争议,以及这场辩论对公共政策的现实意义。