同一模型得分差29%?多Harness强化学习的开源破局之道

Hugging Face开源多框架RL训练方案,让小模型在任意coding agent框架中稳定发挥,终结单框架过拟合困境。
同一模型在不同 agent harness(智能体运行框架)中得分可相差近30个百分点,这一现象揭示了开源模型对框架的高度依赖。Hugging Face 团队发布的多 harness 强化学习指南提出了一种"不侵入"解法:通过一个支持四种主流 API 格式的代理层,在不修改任何 harness 代码的前提下将模型接入统一训练流程。实验表明,在4个框架上联合训练后,LFM2.5-2.6B 得分从42%升至54%,工具调用减少31%;而直接模仿大模型成功轨迹的SFT方法则停滞于47.5%,证明了RL实践相对于行为克隆的优越性。整套方案包括捕获代理、训练器、数据集和7个已训练模型全部开源,让社区可针对任意目标框架自主训练高效小模型。
为什么同一个模型表现天差地别
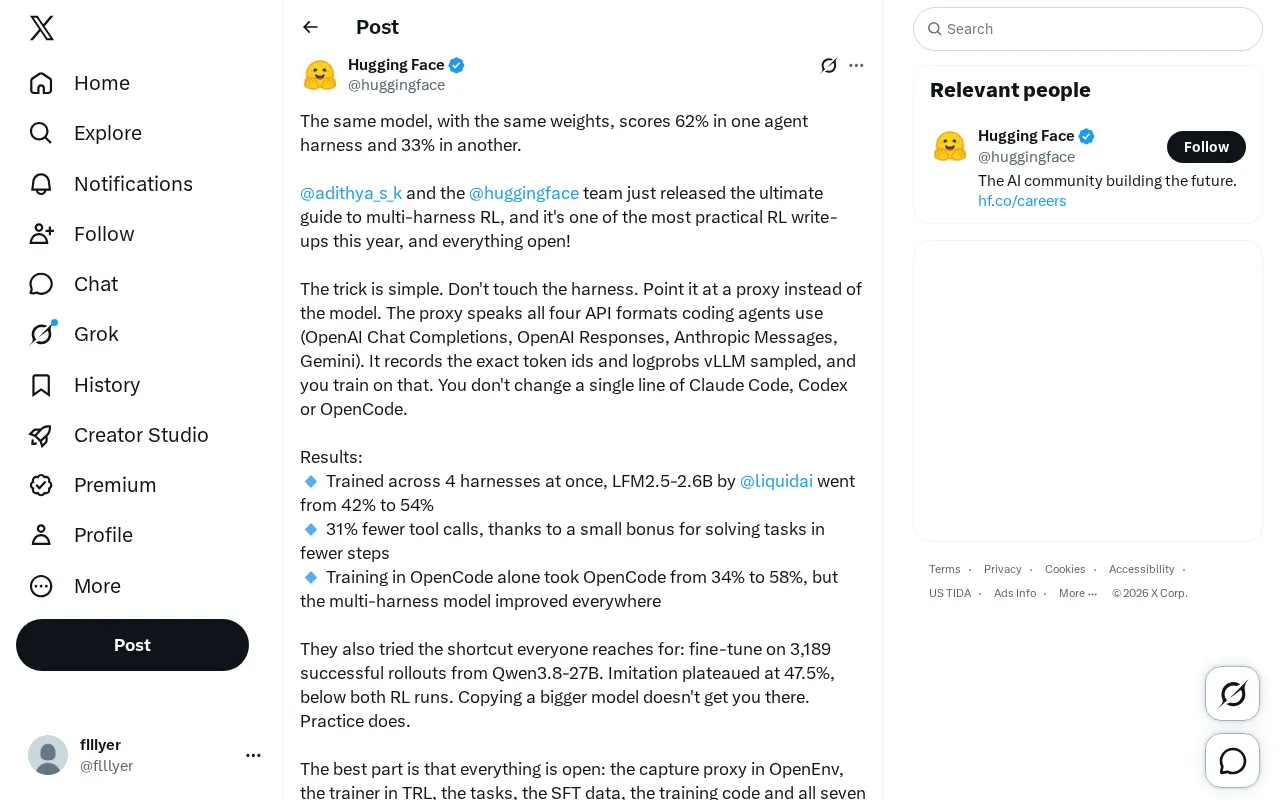
一个令人困惑的现象正在困扰着 AI Agent 开发者:同样的模型,同样的权重,在一个 agent harness(智能体运行框架)里能拿到 62% 的得分,换一个 harness 却只剩 33%。这种接近 30 个百分点的巨大落差,暴露了当前开源模型在实际 Agent 场景中的一个核心痛点——模型性能高度依赖于它所运行的框架环境。
Hugging Face 团队与研究者 Adithya S K 近期发布了一份被称为"今年最实用 RL 写作之一"的多 harness 强化学习指南,并且全部开源。它试图回答一个关键问题:如何让开源模型在各种不同的 coding agent 框架中都能稳定发挥,而不是只在某一个框架里表现突出。
核心思路:不碰框架,接入代理层
这套方法的巧妙之处在于它的"不侵入"设计。传统做法往往需要针对每个 harness 做定制化改造,而这里的思路是:不要动 harness 本身,而是让它指向一个代理(proxy),再由代理连接模型。
这个代理的关键能力是"通晓四种 API 格式"——它能同时处理 coding agent 常用的 OpenAI Chat Completions、OpenAI Responses、Anthropic Messages 和 Gemini 四套接口协议。代理会记录 vLLM 采样时的精确 token id 和 logprobs,训练就建立在这些真实数据之上。
这意味着无论是 Claude Code、Codex 还是 OpenCode,开发者一行代码都不用改,就能把它们接入训练流程。这种解耦设计让同一套训练方法可以复用到任意 harness 上,极大降低了适配成本。
vLLM 是当前主流的高性能大语言模型推理引擎,以 PagedAttention 技术著称,能高效管理 KV Cache 并支持连续批处理。在强化学习训练中,vLLM 承担"采样"角色——即让模型与环境交互、产生 rollout 数据。这里提到的"精确 token id 和 logprobs"至关重要:token id 记录了模型每一步具体生成了哪个词元,logprobs 则记录了该选择的对数概率。这两项数据是 PPO、GRPO 等主流 RL 算法计算策略梯度的必要输入——没有它们,训练器就无法知道模型"为什么"做出某个决策,也就无法正确地施加奖励信号来引导行为优化。代理层通过拦截并记录这些低层采样细节,使得上层 harness 完全感知不到训练的存在,实现了推理侧与训练侧的干净解耦。
实验结果:多框架联合训练的优势
实验数据展现了多 harness 训练的实际收益:
- 在 4 个 harness 上同时训练,Liquid AI 的 LFM2.5-2.6B 模型得分从 42% 提升到 54%;
- 得益于对"用更少步骤完成任务"给予的小额奖励,工具调用次数减少了 31%;
- 仅在 OpenCode 单一框架训练,能把 OpenCode 场景得分从 34% 拉到 58%,但多 harness 训练出的模型则在所有框架上都有提升。
这里揭示了一个重要权衡:单框架训练虽然能在特定环境里冲到更高分数,但泛化能力有限;而多框架联合训练换来的是全面而稳健的提升。对于"Agent 会在几十种 harness 里运行"的现实场景,后者显然更具实用价值。
实验中提到的"对用更少步骤完成任务给予小额奖励",是一种**稀疏奖励下的奖励塑形(Reward Shaping)**技巧。编程 Agent 的主奖励通常是二元的——任务最终通过测试则得 1 分,否则得 0 分——这使得奖励信号极为稀疏,模型难以获得中间反馈来改善行为。通过引入"步骤效率奖励",训练器为每个中间步骤提供了更密集的引导信号,促使模型学会用更短的工具调用链路解决问题。31% 的工具调用削减不仅意味着推理成本降低,在实际部署中也意味着更少的延迟和更低的出错概率——每一次多余的工具调用都是一次潜在的失败点。
模仿学习为何不够:实践胜过复制
团队还验证了一条很多人会本能选择的捷径:直接用更大模型的成功轨迹做监督微调(SFT)。他们从 Qwen3.8-27B 收集了 3189 条成功的 rollout 数据进行模仿学习,结果性能停滞在 47.5%,低于两次 RL 训练的成绩。
这个对比结论很有说服力——单纯复制一个更大的模型,并不能让小模型真正学会解决问题。强化学习式的"反复实践"才是关键。模型需要在真实的交互与试错中积累经验,而不是被动模仿他人的答案。这也从侧面说明,对于 Agent 这类强交互任务,RL 的价值难以被监督微调替代。
监督微调(SFT)与强化学习(RL)的根本差异在于学习信号的来源。SFT 本质上是行为克隆:给模型看"正确答案",让它最大化对这些答案的预测概率。对于编程 Agent 这类任务,"正确答案"是一条成功的操作轨迹,但模型并不理解为什么这条轨迹会成功,也没有经历过失败路径。RL 则不同——模型在真实环境中尝试,成功则获得正向奖励,失败则得到负反馈,通过大量试错逐步学会策略。这种差异在 Agent 任务中尤为突出:Agent 需要在动态环境中连续决策,一步失误可能导致后续全部崩溃,而这种"连锁失败"的经验只能通过实际交互获得,无法从静态成功轨迹中习得。实验中 47.5% 的瓶颈,正是模型缺乏对失败模式的感知所致。
全面开源:人人可训练专属 Agent 模型
这份工作最值得称道的地方在于它的彻底开源。从 OpenEnv 中的捕获代理、TRL 中的训练器,到任务集、SFT 数据、训练代码,再到全部七个训练好的模型,全都对外开放。
这种开放性的意义在于:Agent 未来会运行在数十种不同的 harness 里,而现在任何人都可以针对自己需要的框架去训练开源模型,不再受限于闭源方案或昂贵的定制开发。对于希望在特定 coding agent 生态中部署小型高效模型的团队来说,这提供了一条可复现、可扩展的路径。
随着 Agent 应用形态日益多样化,"让开源模型适配任意框架"这一能力正变得越来越重要。这份多 harness RL 指南不仅给出了方法论,更把完整工具链交到了社区手中。
相关推荐

本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。