通义千问Qwen3.8-Max-0902登顶Code Arena榜首
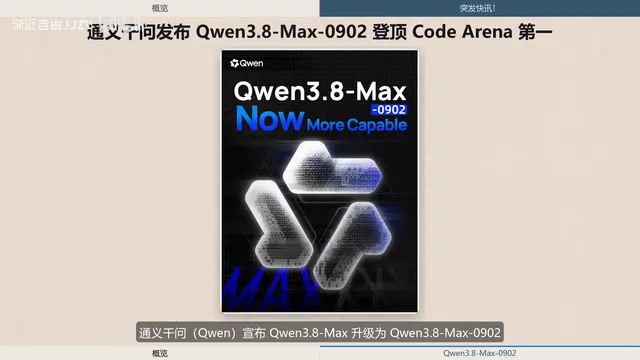
阿里云通义千问近日发布重大更新,其最新版本Qwen3.8-Max-0902在多个编程能力评测榜单中取得突破性成绩,以1691分登顶Code Arena综合总榜第一,并在代码生成领域展现出强劲的竞争力。
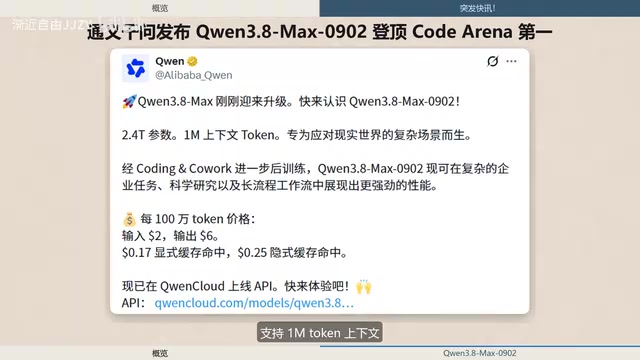
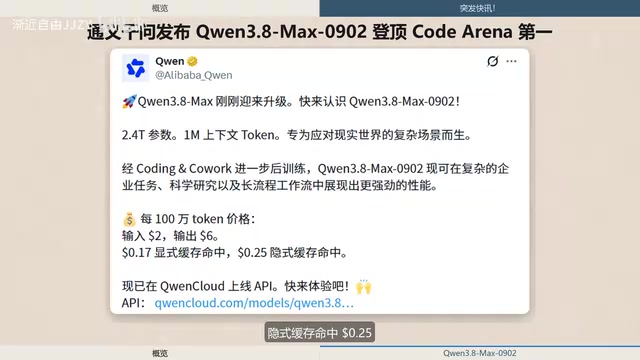
Qwen3.8-Max-0902模型规模与定价策略
新版Qwen3.8-Max-0902采用2.4T参数量的混合专家架构(MoE),支持128K上下文长度。
混合专家架构(MoE)技术解读:混合专家架构(Mixture of Experts)是一种先进的神经网络设计范式,通过将大型模型拆分为多个专门化的子模型("专家")来提升效率。在推理时,路由机制(通常是一个轻量级的门控网络,如Top-K稀疏门控)会根据输入内容的语义特征动态激活其中部分专家,而非调用全部参数。这使得2.4T参数的Qwen3.8-Max实际运行时仅激活其中一小部分参数(通常10-20%),从而在保持强大能力的同时显著降低计算成本和响应延迟。
与传统的Dense(稠密)模型相比,MoE架构的核心优势在于"容量解耦"——模型的知识存储容量(由总参数量决定)与单次推理的计算成本(由激活参数量决定)不再绑定。一个2.4T参数的MoE模型可能拥有比700B Dense模型更丰富的知识储备,但单次推理的计算量却与200-300B的Dense模型相当。这种架构在Google的Switch Transformer和GLaM、Mistral的Mixtral系列,以及DeepSeek-V3等模型中已得到充分验证,特别适合需要处理多样化任务的通用大模型。不同专家可以自然地"分工"——部分专家擅长代码生成,部分专家精通自然语言理解,部分专家则专注于数学推理。Qwen采用MoE架构使其在保持竞争力定价的同时,能够在编程、推理、多语言等不同领域均展现专业水平。
在定价方面,该模型采用了极具竞争力的价格策略:
- 输入成本:每100万Token 2美元
- 输出成本:每100万Token 6美元
- 显式缓存命中:仅需0.17美元
- 隐式缓存命中:0.25美元
上下文长度与Token缓存机制:上下文长度(Context Length)指模型一次能够处理的最大文本量,128K Token约相当于10万个英文单词或20万个中文字符,足以容纳数十个完整的代码文件。Token是文本的最小处理单元,英文中平均一个单词约1.3个Token,中文一个汉字约1-2个Token。128K的上下文窗口在实际开发中意味着模型可以同时"看到"一个中型项目的核心代码库——包括多个模块的源文件、配置文件、测试用例和文档说明——从而实现真正的项目级代码理解,而不是局限于单个函数或文件的局部分析。
缓存机制是大模型API的关键成本优化技术:当用户进行多轮对话或重复调用时,系统可以缓存之前处理过的输入内容(如项目文档、代码库上下文),后续请求只需为新增内容付费。从技术实现角度看,这主要依赖于KV Cache(键值缓存)技术——Transformer模型在处理每个Token时会生成对应的Key和Value向量,这些中间计算结果可以被持久化存储并在后续请求中复用,避免重复计算。显式缓存由开发者主动标记需要复用的内容(类似Anthropic的"system prompt caching"),命中率高且可预测;隐式缓存则由系统通过前缀匹配等机制自动识别重复内容,对开发者透明。Qwen的缓存价格(0.17-0.25美元)仅为正常输入价格的8-12%,对于需要频繁引用大型代码库的企业级应用——如IDE中的AI编程助手在每次用户编辑时都需要重新发送项目上下文——可将API成本降低70-90%。这一定价策略直接降低了AI编程工具的运营门槛,使得基于Qwen构建持续运行的代码辅助服务在经济上更加可行。
编程能力的针对性优化:聚焦Coding与Cowork场景
此次更新的核心亮点在于针对Coding和Cowork场景的深度后训练。通义千问团队专门强化了模型在以下方面的表现能力:
- 复杂企业任务:处理大型项目中的多模块协同开发
- 科学研究:支持数据分析、算法实现等研究型编程需求
- 长周期工作流:适应需要持续迭代的开发场景
后训练与垂直场景优化:后训练(Post-training)是指在基础预训练完成后,针对特定应用场景进行的专项能力强化,主要包括监督微调(SFT)和人类反馈强化学习(RLHF)两个阶段。近年来,直接偏好优化(DPO)和群体相对策略优化(GRPO)等新技术也被广泛应用于后训练流程,这些方法无需单独训练奖励模型,可以更高效地将人类偏好注入大模型。与覆盖广泛知识的预训练不同,后训练使用高质量的垂直领域数据和专家标注,让模型深度适配特定任务模式。
针对"Coding和Cowork"场景的后训练意味着Qwen团队专门收集了企业级代码协作数据,如跨文件代码理解、项目级重构指令、多轮技术对话、代码审查建议等,并通过强化学习让模型学会开发者偏好的代码风格和交互模式。在代码领域,高质量后训练数据的构建本身就是一项系统工程——需要从GitHub等开源平台筛选高星项目的完整提交历史,提取真实的代码修改对(Before/After),结合Issue讨论和Pull Request评审意见构建指令-响应对,甚至利用编译器和测试框架对生成代码进行自动化验证,以确保训练数据中的代码不仅"看起来正确",而且"确实能运行"。
这种垂直优化使模型不仅能"写代码",更能"理解开发流程",例如识别项目架构模式(MVC、微服务、Monorepo等)、遵循现有代码库的命名规范和设计模式、提供上下文相关的重构建议,甚至理解团队协作中的代码评审礼仪——这些能力是通用预训练难以获得的,也是当前大模型差异化竞争的关键战场。"Cowork"(协作编程)能力的强调尤其值得关注,这意味着模型不再是被动的代码生成器,而是向主动参与团队开发流程的"AI队友"角色演进。
这种针对性优化使得Qwen3.8-Max-0902不仅能处理简单的代码补全任务,更能胜任需要多轮交互、跨文件理解和项目级重构的复杂开发场景。
Code Arena榜单表现:1691分登顶总榜
Qwen3.8-Max-0902在Code Arena各项排行榜上的表现尤为突出:
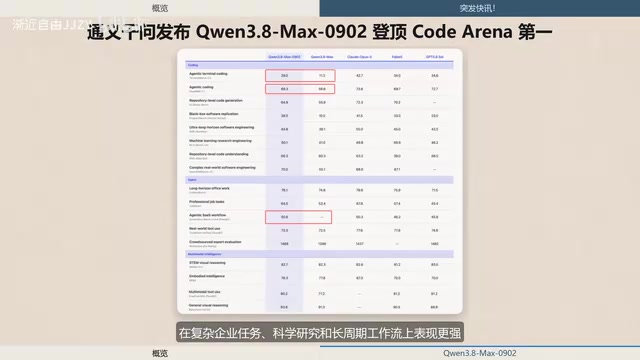
- Code Arena WebDev排行榜:从此前的1669分跃升至1691分,成功超越Claude Opus 3.5,位居该细分榜单第一
- Code Arena综合总榜:以1691分夺得冠军位置
- 帕雷托前沿榜单(5美元/MTok价格档位):同样占据榜首,领先Claude Opus 3.5达3分
Code Arena基准测试体系:Code Arena是评估AI编程能力的竞技场式基准测试平台,采用ELO评分系统来衡量模型的代码生成质量。ELO评分系统源自国际象棋排名,其核心思想是通过模型之间的"对战"——即让两个模型生成同一编程任务的解答,由人类评审员或自动化测试框架判定胜负——来动态调整每个模型的分数。ELO系统的优势在于它能自动校准不同难度的任务:在困难任务中战胜强对手获得的分数远高于在简单任务中战胜弱对手,这使得最终排名更能反映模型的真实能力而非"刷题"效果。
测试内容覆盖算法实现、Web开发、系统设计、Bug修复、API集成等真实编程任务,评判维度包括功能正确性、代码质量、可读性、边界条件处理、最佳实践遵循度等。相较于HumanEval、MBPP等早期代码基准测试(主要考察独立函数的正确性),Code Arena的任务更接近真实开发场景的复杂度,包含多文件项目、前后端交互、数据库操作等工程化挑战。
WebDev子榜单专注前端和全栈Web开发能力,考察模型生成HTML/CSS/JavaScript/React/Vue等代码的实用性,这是当前AI辅助编程需求最旺盛的领域之一。帕雷托前沿榜单则引入了经济学中的帕雷托最优概念,综合性能与成本两个维度,筛选出"性价比最优"的模型——即在特定价格档位内性能最强,或达到特定性能所需成本最低的模型。Qwen在5美元/百万Token档位领先意味着其提供了该价格区间的最佳编程能力,这对成本敏感的初创企业和中小型开发团队极具吸引力——他们可以获得接近甚至超越最贵模型的编程辅助效果,同时将AI工具链的月度支出控制在可接受范围内。
从性价比维度来看,Qwen3.8-Max-0902在同等价格区间内提供了最优的性能表现,对企业用户而言具有显著的成本优势。
技术意义与行业影响
通义千问此次更新体现了几个重要趋势:
国产大模型达到国际顶尖水平:Qwen3.8-Max-0902在编程领域的能力已能够在公开基准测试中超越OpenAI和Anthropic的旗舰模型,标志着国产AI编程能力的重大突破。值得注意的是,这一成绩出现在当前全球AI编程工具市场快速扩张的背景下——GitHub Copilot已拥有超过百万付费用户,Cursor编辑器月活跃开发者持续增长,Replit、Windsurf等AI原生开发平台竞相涌现。在这一竞争格局中,Qwen的优势不仅在于模型能力本身,更在于其开放的API接入模式使其可以被集成到各类开发工具和IDE中,而非局限于某个特定产品形态。对于国内蓬勃发展的AI编程工具生态(如通义灵码、豆包MarsCode、CodeGeeX等),Qwen模型能力的突破意味着底层模型的"天花板"被进一步抬高,这些下游产品的用户体验也将随之提升。
成本控制更加灵活:通过缓存机制的引入,模型在保持高性能的同时实现了更精细的成本管理,让中小企业也能负担得起顶级AI编程能力。以一个典型的AI辅助编程场景为例——开发者在IDE中使用AI助手进行项目开发,每次编辑触发约5万Token的上下文发送,一天约200次交互。在无缓存情况下,日均API成本约20美元(仅输入端),启用显式缓存后(假设90%命中率),日均成本可降至约3.5美元,降幅超过80%。这种量级的成本差异足以决定一个AI编程产品的商业可行性。
垂直场景后训练成为差异化关键:针对企业级代码协作等特定垂直场景的后训练策略,正在成为大模型差异化竞争的核心方向。随着基础预训练技术逐渐成熟,各家模型在通用能力上的差距正在缩小,而针对特定高价值场景(如企业级编程、科学研究、金融分析等)的精细化优化,正成为决定产品市场竞争力的关键因素。这一趋势也意味着大模型的竞争正从"谁的参数多、训练数据大"的规模竞赛,转向"谁对用户场景理解更深、优化更精准"的应用层竞争。
对于开发者和企业而言,Qwen3.8-Max-0902的登顶不仅提供了一个性能优异的AI编程助手选项,其相对较低的使用成本和对中文开发场景的深度适配,使其在国内市场具有独特的竞争优势。中文编程场景的适配不仅体现在注释和文档的中文理解上,更包括对国内常见技术栈(如Spring Cloud Alibaba、Ant Design、微信小程序等)的熟悉度,以及对中文技术社区编程习惯的理解。随着模型能力的持续提升,AI辅助编程正在从代码补全工具向真正的开发伙伴演进——从单行代码建议到整个功能模块的自主实现,从被动响应到主动发现潜在Bug和性能瓶颈,AI正在重新定义软件开发的工作流程。
核心要点
相关推荐

SimpliSafe新款可视门铃:AI+真人保安主动盯防你的家门
SimpliSafe推出售价199.99美元的Video Doorbell Series 2可视门铃,搭配Active Guard主动安防服务,结合AI分析与真人监控坐席,实现家门口的主动威胁侦测与干预。本文解析其技术分工、订阅模式与隐私问题。
富士 Instax Pal 2 迷你相机:补齐屏幕短板的升级之作
富士发布 Instax Pal 2 迷你数码相机,相比初代新增屏幕与取景器,采用微缩化相机造型,补齐了初代盲拍的核心短板,成为一款更实用的便携即时成像设备。
Linux from Scratch:从零手工构建你的Linux系统
Linux from Scratch(LFS)是一个教你从源代码手工构建 Linux 系统的开源项目。本文介绍 LFS 的核心价值、BLFS/ALFS 项目生态及适用人群,帮助你理解 Linux 底层机制。