通用AI智能体能否读懂手术场景?新基准给出答案

研究用两阶段基准测试揭示通用多模态大模型手术理解的能力边界与智能体推理的增益局限。
该研究针对通用多模态大语言模型在手术场景中的真实能力边界缺乏系统评估的问题,提出两阶段框架:第一阶段SurgKnowBench整合跨手术类型的公开数据集,统一评估专有与开源MLLM,发现模型保留部分视觉先验,但在关系理解、流程理解和工作流评估上薄弱;第二阶段SurgAgentGym受脚手架式教学启发,让智能体通过SurgWiki进行有界知识搜索并调用通用视觉定位能力。实验表明,智能体推理主要缩小感知密集型任务的差距,细粒度定位和专家级评估仍是持续瓶颈。研究建议医疗AI在手术场景中优先聚焦感知辅助功能,对精确判断类任务保持谨慎。
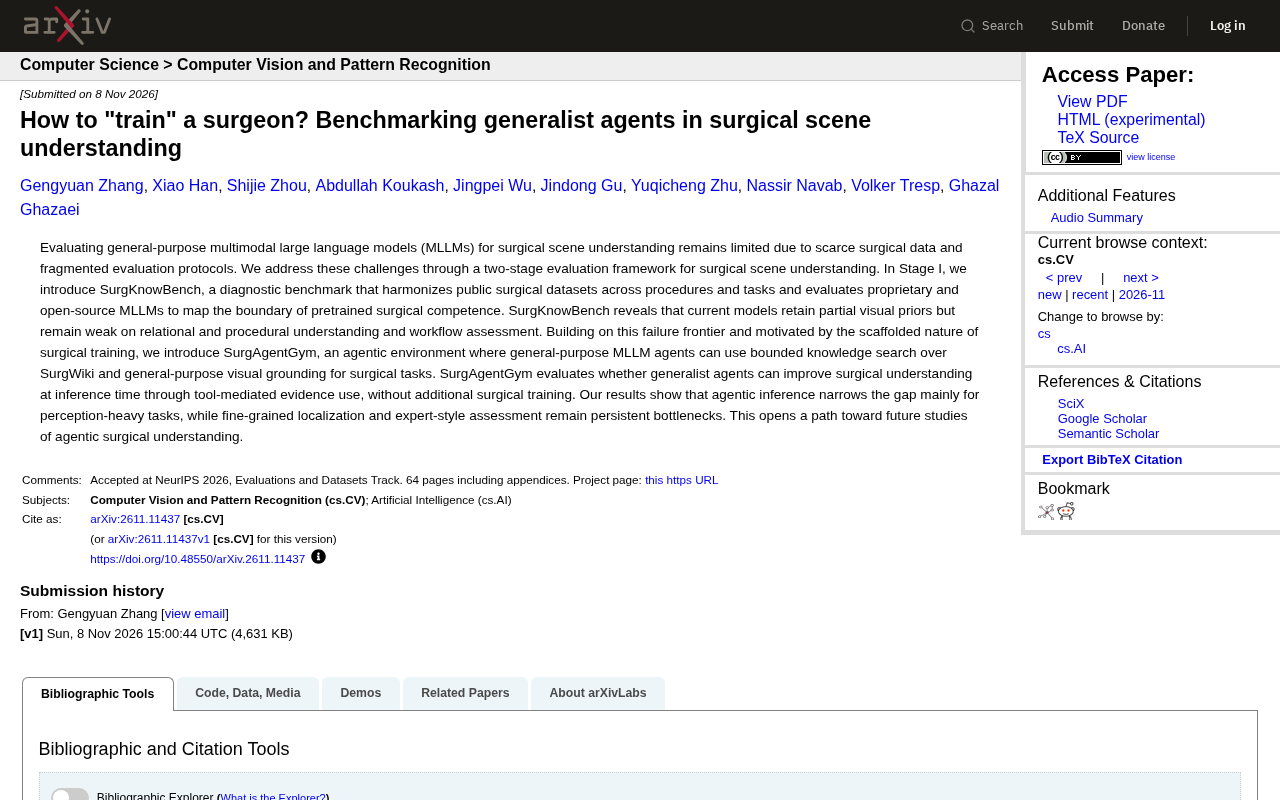
多模态大模型在医疗领域的应用一直备受关注,但它们在手术场景中的真实能力边界却鲜有系统评估。近期一篇题为《How to "train" a surgeon? Benchmarking generalist agents in surgical scene understanding》的研究,通过两阶段框架对通用MLLM(多模态大语言模型)的手术场景理解能力进行了基准测试,并探索了智能体推理能否弥补模型先验知识的不足。
两阶段评估框架:从诊断到智能体增强
研究团队指出,手术场景理解评估面临两大障碍:手术数据稀缺且评估协议碎片化。为此,他们设计了一个两阶段评估框架。
第一阶段:SurgKnowBench诊断基准。 该基准整合了跨手术类型和任务的公开手术数据集,对专有和开源MLLM进行统一评估,旨在绘制预训练手术能力的边界。结果显示,当前模型虽然保留部分视觉先验,但在关系理解、流程理解和工作流评估方面表现薄弱。
第二阶段:SurgAgentGym智能体环境。 受手术培训中“脚手架式”教学启发,研究团队构建了一个智能体环境,让通用MLLM智能体能够通过SurgWiki进行有界知识搜索,并利用通用视觉定位能力完成手术任务。核心问题是:不额外进行手术训练,仅靠推理时的工具调用和证据使用,通用智能体能否提升手术理解水平?
多模态大语言模型(MLLM) 指同时具备视觉与语言理解能力的大规模预训练模型,如GPT-4V、LLaVA等。其核心能力来源于海量图文对预训练,因而具备一定的通用视觉先验,但这些先验是否适用于高度专业化的手术场景,正是本文基准测试要回答的问题。与单模态模型不同,MLLM的评估需要同时考察视觉识别、空间关系推理和语言生成的正确性,评估协议更复杂。
手术场景理解 通常包括识别器械与解剖结构、理解操作步骤的时序关系、判断手术流程是否规范等层次。与自然图像理解相比,手术场景具有纹理相似、遮挡频繁、光照特殊等特点,且公开数据因隐私和伦理限制而稀缺,这解释了为何需要专门构建SurgKnowBench而非直接沿用通用视觉基准。
智能体推理的增益与局限
实验结果表明,智能体推理主要缩小了感知密集型任务上的差距,而在细粒度定位和专家级评估方面仍存在持续瓶颈。这意味着,工具增强的推理策略对“看到什么”类任务有帮助,但对“精确判断”类任务收效有限。
这一发现具有现实意义:在手术这类高风险场景中,通用AI的短板恰恰集中在需要专业判断的环节。研究团队认为,这为未来智能体手术理解研究开辟了路径——不是追求端到端训练,而是探索推理时如何更有效地调用外部知识和工具。
视觉定位(visual grounding) 指模型根据文本描述在图像中定位对应区域或目标的能力,是智能体调用通用视觉工具的基础。在手术场景中,定位任务要求模型不仅找到器械,还要精确标出其边界与空间关系,这正是文中“细粒度定位”瓶颈的所在。通用视觉定位模型多在自然图像上训练,面对手术器械的细长形态和金属反光时性能下降明显。
推理时工具调用 与端到端训练相对,指模型在推理阶段通过检索知识库、调用视觉模型等方式获取外部信息,而不更新模型参数。这种策略成本低、可解释性强,但受限于工具本身的精度和知识检索的覆盖范围,因此对感知密集型任务增益明显,对需要专业判断的任务帮助有限。
对医疗AI开发的启示
该研究传递出一个清晰信号:通用MLLM的手术能力不能简单假设,需要系统性的基准测试来界定边界。同时,智能体框架提供了一种低成本增强思路,但无法替代领域专家的精细判断。对于医疗AI产品开发者而言,这意味着在手术场景中部署通用模型时,应优先聚焦感知辅助类功能,而对定位和评估类任务保持谨慎。
研究也暴露了当前评估生态的不足:手术数据稀缺和评估协议不统一仍是制约领域发展的关键因素。SurgKnowBench的整合尝试为后续研究提供了可复用的基准,但更广泛的社区协作仍是必要条件。
结语
这项研究没有给出“通用AI能否成为外科医生”的简单答案,而是精确描绘了当前能力的边界与智能体增强的适用范围。在医疗AI热度高涨的当下,这种冷静的基准测试或许比乐观的演示更有价值。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。