托管型 Postgres 的真相:Lakebase 到底帮你省了什么
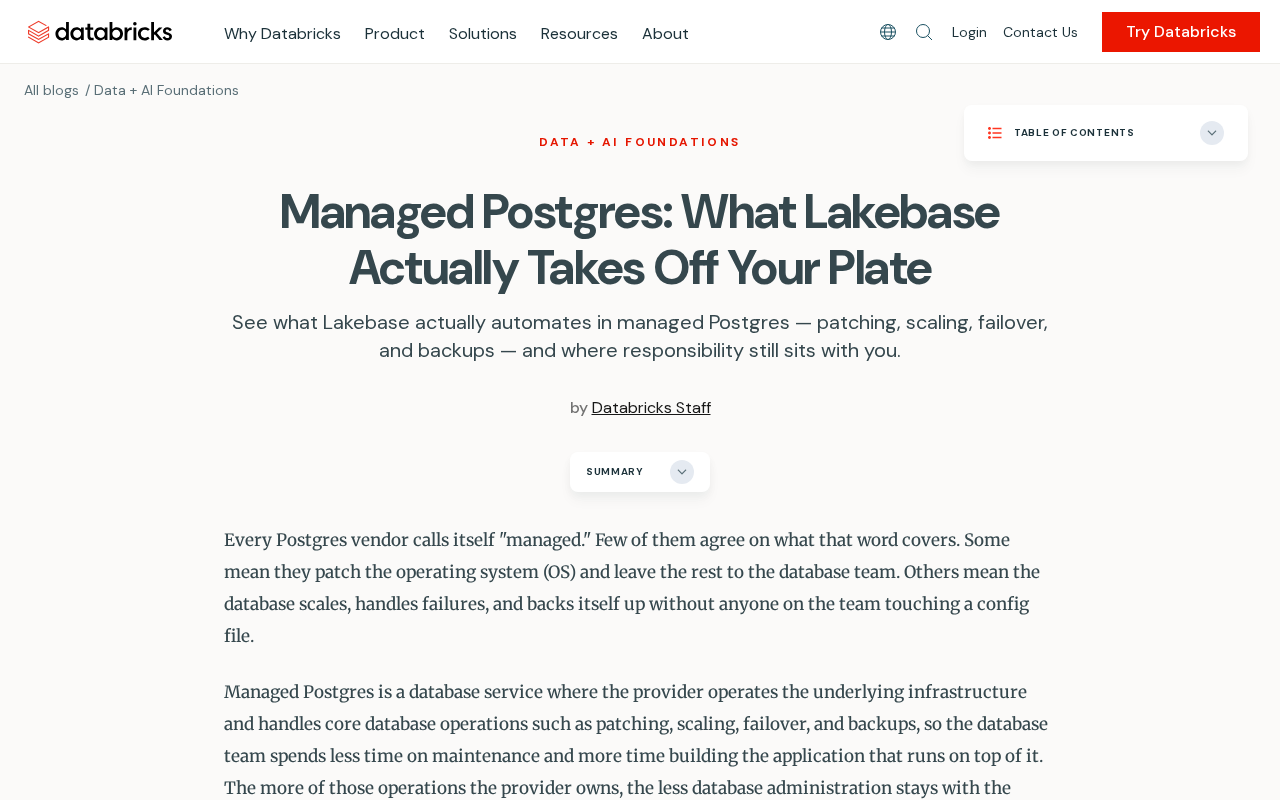
"托管"Postgres服务含义因厂商而异,选型时需逐项核查责任边界而非轻信营销标签。
文章指出"托管"(Managed)一词在各家Postgres云服务商之间含义差异巨大:有的仅限于帮用户启动实例,有的则全面接管数据库生命周期。真正有价值的托管服务应覆盖四大核心运维环节:基础设施与高可用、备份恢复与数据安全、弹性扩缩容、以及版本升级与补丁维护。Lakebase以最大程度转移运维负担为核心卖点,试图将这些高消耗任务纳入平台职责。文章建议选型时抛开营销话术,用责任边界清单逐项核对,判断一款产品的"托管含金量",从而让团队真正聚焦于业务逻辑而非数据库日常照料。
当所有厂商都自称"托管"时,这个词还有意义吗
几乎每一家 Postgres 云服务商都会给自己贴上"托管"(managed)的标签,但很少有厂商对这个词的含义达成一致。有的厂商所谓的"托管"仅仅意味着帮你把数据库实例启动起来,之后的备份、扩容、版本升级、故障恢复等一大堆运维工作,依然压在你自己的团队肩上。而另一些厂商则把"托管"理解为几乎接管了数据库生命周期的每一个环节。
这种概念上的模糊,恰恰是评估任何一款托管型数据库产品时最容易踩坑的地方。当你看到营销页面上大大的"Fully Managed"字样时,真正需要追问的是:它到底从我的工作清单里拿走了哪些任务?又把哪些责任悄悄留给了我?
"托管"背后隐藏的责任边界
理解托管型数据库的关键,在于厘清责任的分界线。一个真正意义上的托管服务,应当覆盖以下几类日常最消耗工程师精力的工作:
基础设施与可用性
数据库实例的部署、底层硬件资源的分配、高可用架构的搭建,都属于最基础的"托管"范畴。如果一款产品连自动故障切换(failover)和多可用区冗余都需要用户手动配置,那它的"托管"程度就相当有限。
自动故障切换(Automatic Failover)的实现质量在各家托管服务之间差异显著。一套成熟的高可用方案通常包含三个环节:主节点健康检测、副本节点的数据同步状态确认、以及将流量切换到新主节点的 DNS 或代理层变更。Postgres 原生不内置自动故障切换,通常需要借助 Patroni、repmgr 等开源工具或云厂商自研的协调层来实现。评估托管服务时,需要追问的不只是"支不支持自动切换",还包括:切换期间应用连接会中断多久(通常在几秒到几十秒之间)、是否可能出现脑裂(split-brain)导致数据不一致、以及副本的同步模式是同步复制还是异步复制——后者在主节点突然宕机时可能造成少量数据丢失。
备份、恢复与数据安全
自动化的定期备份、时间点恢复(PITR)、以及在灾难场景下的快速恢复能力,是衡量托管深度的重要指标。这些工作一旦落到用户头上,不仅繁琐,而且极易因为疏忽而酿成数据丢失的重大事故。
时间点恢复(PITR,Point-in-Time Recovery)是一项值得特别关注的能力。它允许用户将数据库还原到过去任意一个精确时刻的状态,而不仅仅是最近一次完整备份的快照。其底层原理依赖于 Postgres 的预写日志(WAL,Write-Ahead Log):所有数据变更在真正写入数据文件之前,会先被顺序追加到 WAL 中。只要持续归档 WAL 日志,就可以在基础备份之上"回放"任意时间段的变更,从而精确定位到故障发生前的某一秒。对于金融、电商等对数据完整性要求极高的业务场景,PITR 的恢复粒度直接决定了灾难发生时的最大数据丢失量(RPO)。评估托管服务时,需要明确询问 PITR 的保留窗口有多长、恢复操作是否需要人工介入,以及恢复到新实例的时间(RTO)有多快。
扩缩容与性能调优
随着业务增长,数据库需要弹性地扩展计算和存储资源。理想的托管服务应当能够根据负载自动或半自动地完成扩缩容,而不必让工程师在深夜盯着监控面板手动干预。
Postgres 的扩缩容在技术层面面临一些固有挑战,这也是为什么不同托管服务在这一环节的能力差异特别显著。传统的垂直扩容(升级 CPU 和内存)通常需要短暂停机或主从切换;而水平扩展(读写分离、分片)则需要应用层配合改造,复杂度更高。部分托管服务通过将存储层与计算层解耦的架构设计,实现了计算资源的秒级弹性伸缩,存储也可以独立扩展而无需迁移数据。这种"存算分离"架构与传统的单机 Postgres 实例有根本性区别,能显著降低扩容操作对业务可用性的影响。评估时,除了关注扩容是否自动触发,还需要了解扩容过程中是否有连接中断、是否需要应用端重连逻辑,以及存储扩展是否有上限。
版本升级与补丁维护
Postgres 本身以及底层操作系统的安全补丁、版本迭代,往往是运维中最容易被拖延的部分。托管服务把这部分工作接管过来,能显著降低安全风险和维护负担。
Lakebase 的定位:把运维负担降到最低
Lakebase 作为一款托管型 Postgres 服务,其核心卖点正是围绕"到底从用户手里拿走了多少活"来展开的。与那些名义上托管、实则甩锅的产品不同,它试图把上述几类高消耗的运维任务尽可能地纳入平台自身的职责范围。
对于开发团队而言,这意味着可以把更多精力投入到应用逻辑和业务创新上,而不是耗费在数据库的日常照料上。当备份、恢复、扩容、升级这些底层工作被平台默默处理掉之后,团队的运维复杂度和人力成本都会随之下降。
如何理性评估一款"托管" Postgres
在选型时,与其被营销话术牵着走,不如用一张清单去逐项核对:
- 谁负责备份和恢复? 是自动的还是需要手动配置?恢复的粒度能到什么程度?
- 扩缩容如何触发? 是弹性自动的,还是需要停机手动操作?
- 版本升级由谁执行? 是否需要业务停机窗口?
- 高可用是默认开启还是额外付费选项? 故障切换的时间有多快?
- 监控和告警是否内置? 出了问题谁先发现?
把这些问题一一问清楚,才能真正判断出一款产品的"托管"含金量。名字里都写着 managed,但真正能替你分担多少工作,差异可能非常悬殊。
结语
托管型数据库的价值,本质上是一种"责任的转移"——把那些重复、繁琐又高风险的运维工作从用户团队转移到平台一侧。Lakebase 强调的正是这种转移的彻底程度。对于希望轻装上阵、聚焦业务本身的团队来说,看清"托管"这个词背后真正的责任边界,是做出正确技术选型的第一步。
相关推荐
AI验证系统降本困局:如何少读证据又不漏掉关键信息
AI验证系统的真正成本不在检索而在阅读证据量。本文剖析一个RAG验证流水线的降本实践:提前停止、跳过切片、去重为何收效甚微,以及如何在保持高召回率的同时不漏掉少数派证据这一核心难题。
开发者微调AI模型实现视频字幕与水印去除
一位开发者微调开源模型,实现视频字幕与水印去除功能,支持图片处理,已部署在Hugging Face上开放试用。本文解析其实现思路、性能表现与应用争议。
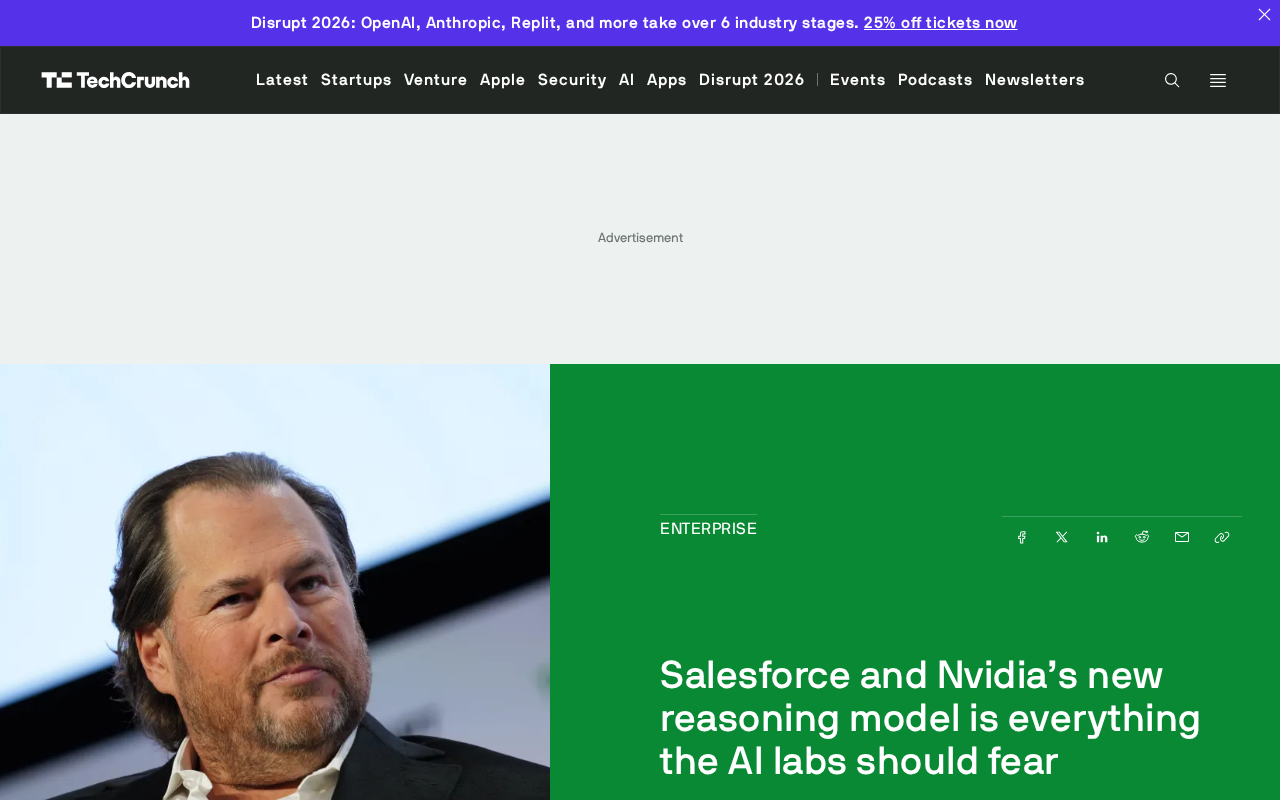
Salesforce联手英伟达推Koa模型:企业AI的开源突围
Salesforce与英伟达联合推出基于开放权重模型Nemotron的推理模型Koa,专注销售、营销和客服场景。本文分析这一垂直化AI策略为何值得通用大模型实验室警惕,以及它对行业格局的启示。