TurboGPT:13秒训练22KiB微型Transformer的极简实验
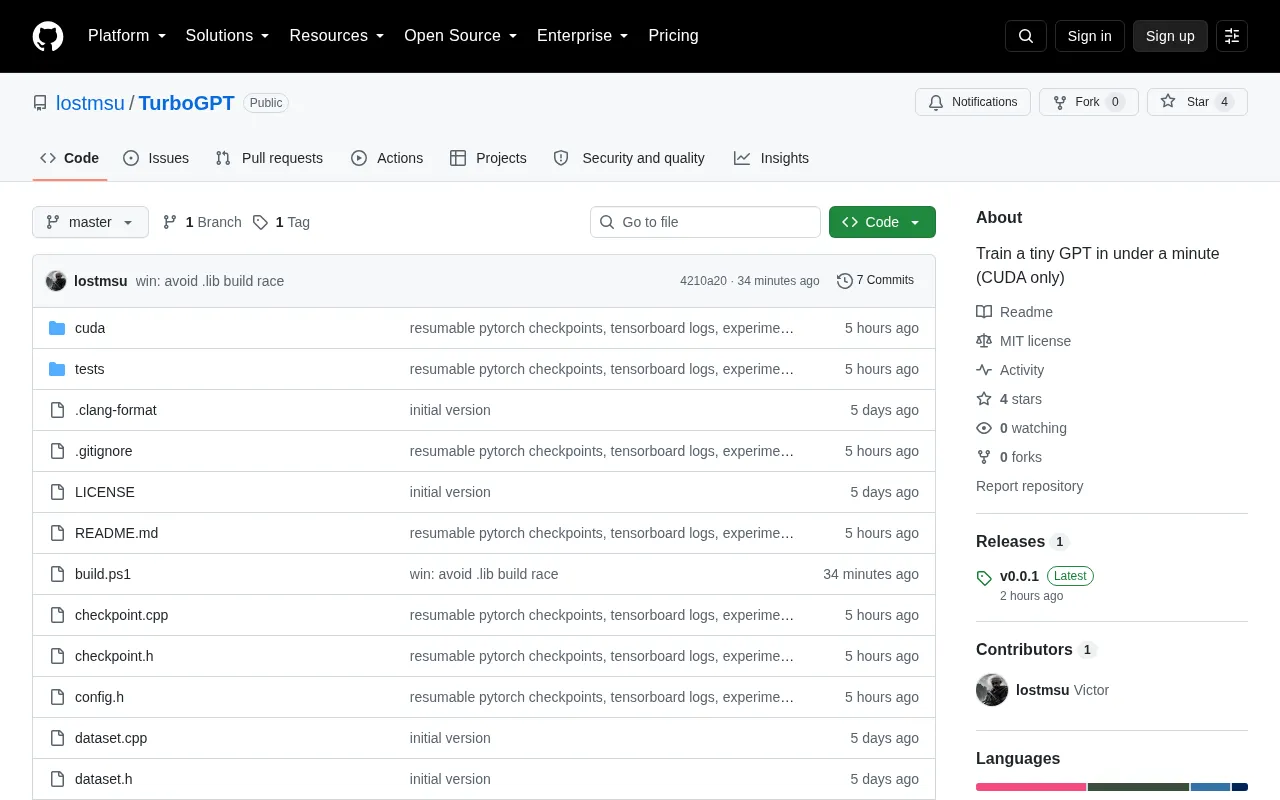
TurboGPT用13秒训练22KiB的极简Transformer,核心价值在于教学透明性而非实用性。
TurboGPT是一个以极简主义为核心理念的开源项目,宣称可在13秒内训练出仅22KiB大小的Transformer模型。与动辄千亿参数的主流大模型相比,其参数量可能仅有几千到几万个,差了七八个数量级。这种体量决定了它在实际语言任务上几乎没有实用价值,但其真正意义在于教学与技术验证:模型足够小,可在普通笔记本上运行,Transformer的自注意力、位置编码、前馈网络等核心机制完整可见且可调试。该项目呼应了nanoGPT等社区对「最小可行实现」的持续兴趣,也契合边缘计算与端侧AI对轻量模型的探索需求。对于想真正理解大模型底层原理而非仅调用API的学习者,这类「跑得起来、看得明白」的极简实现具有独特的入门价值。
当模型训练走向极简主义
在动辄消耗数百万美元算力、参数量达千亿级的大模型时代,Hacker News 上一个名为 TurboGPT 的项目走出了完全相反的方向。它的口号简单直接:在 13 秒内训练出一个仅 22KiB 大小的 Transformer 模型。
这个项目以 Show HN 的形式发布,虽然目前讨论热度还不算高(10 分、1 条评论),但它触及了一个越来越受关注的话题:极小规模模型的训练与教学价值。当主流叙事都在追求「更大」时,有人开始认真思考「多小才够用」。
22KiB 与 13 秒意味着什么
要理解 TurboGPT 的意义,先要把这两个数字放到语境里。
22KiB 的模型体积,比一张普通的网页图标还要小。这意味着模型参数量极其有限,可能只有几千到几万个参数——与 GPT-3 的 1750 亿参数相比,差了七八个数量级。而 13 秒的训练时间,则说明整个过程可以在一台普通的个人电脑、甚至无需 GPU 的环境下完成。
这样的配置显然不是为了解决真实的自然语言任务,而更像是一个可复现、可观察、可教学的最小化 Transformer 实现。它把 Transformer 架构中最核心的机制——自注意力、位置编码、前馈网络——浓缩到一个能在几秒内跑完的规模里。
极简模型的三重意义
从工程与教育的角度看,这类项目通常有几个价值点:
- 学习门槛极低:初学者可以在自己的笔记本上反复运行、修改、观察结果,而不必等待漫长的训练或租用云端算力。
- 透明可调试:模型足够小,每一层的行为、每一个参数的变化都可以被完整追踪,这对理解 Transformer 内部机制极有帮助。
- 快速迭代实验:13 秒的循环意味着可以在一个下午内做上百次实验,验证各种架构假设。
Transformer 架构由 Vaswani 等人在 2017 年论文《Attention Is All You Need》中提出,其核心创新在于用自注意力机制(Self-Attention)取代了此前主流的循环神经网络(RNN)。自注意力允许模型在处理序列中的每个词时,同时关注序列中所有其他词的信息,而不受距离限制。位置编码(Positional Encoding)则用于向模型注入词序信息,因为注意力机制本身不区分位置顺序。前馈网络(Feed-Forward Network)负责在每个位置对特征做非线性变换。这三个模块堆叠起来,便构成一个 Transformer 层。现代大语言模型(如 GPT 系列)本质上是将数十乃至数百个这样的层串联,并用海量文本数据训练。TurboGPT 的价值正在于:用极少的参数保留了上述完整结构,使得学习者无需高算力便可观察这一机制的运转过程。
为什么「小」正在重新被重视
TurboGPT 并非孤例。近年来,从 Andrej Karpathy 的 nanoGPT、minGPT,到各类「从零实现 Transformer」的教学项目,社区对最小可行实现的兴趣持续升温。
背后的逻辑不难理解。大模型固然强大,但对绝大多数开发者而言,它是一个无法窥探内部的黑箱。而像 TurboGPT 这样的微型项目,恰恰提供了一个「解剖标本」——你可以看清 Transformer 到底在做什么,而不是仅仅调用一个 API。
这种「小而透明」的思路,也呼应了边缘计算和端侧 AI 的趋势。当模型需要跑在资源受限的设备上时,如何用最小的体积实现可用的功能,本身就是一个有工程价值的命题。
Andrej Karpathy 是 OpenAI 联合创始人之一,也是深度学习教育领域极具影响力的人物。他开发的 minGPT 和 nanoGPT 项目以极简代码复现 GPT 训练流程,其中 nanoGPT 可在单张消费级 GPU 上完成莎士比亚风格文本的训练,整个核心代码不足 300 行。这类项目的走红,折射出社区对「可理解的 AI」的强烈需求——当主流模型的训练成本高达千万美元量级,普通开发者和学生几乎没有机会亲历完整的训练过程。最小可行实现填补了这一空白:它们不追求 SOTA 性能,而是把「能跑起来、看得明白」作为首要目标,充当大模型原理的「教学沙盘」。
教学工具还是玩具?
需要客观看待的是,一个 22KiB、13 秒训练出来的模型,在实用性上几乎为零。它无法生成连贯的长文本,也谈不上任何语言理解能力。把它当作产品来评判是不公平的。
它的真正定位更接近教学演示与技术验证。类似的项目往往用最少的代码呈现 Transformer 的完整训练流程,让读者能够一行一行地读懂反向传播、梯度更新和注意力计算是如何协同工作的。对于想入门大模型底层原理的人来说,这种「跑得起来、看得明白」的实现,价值可能超过一篇冗长的论文。
值得关注的信号
TurboGPT 目前的信息还很有限,项目细节、具体架构和实现语言都有待作者进一步披露。但它释放出的信号是清晰的:在算力军备竞赛之外,仍有一批开发者在坚持探索 AI 的「可理解性」边界。
用极致的精简去还原一个复杂系统的本质,这既是一种工程审美,也是一条被低估的学习路径。对于关注 AI 底层原理的读者,这类项目值得持续留意——它们或许训练不出惊艳的效果,却能让你真正看懂大模型的第一块积木是怎么搭起来的。
相关推荐
Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。
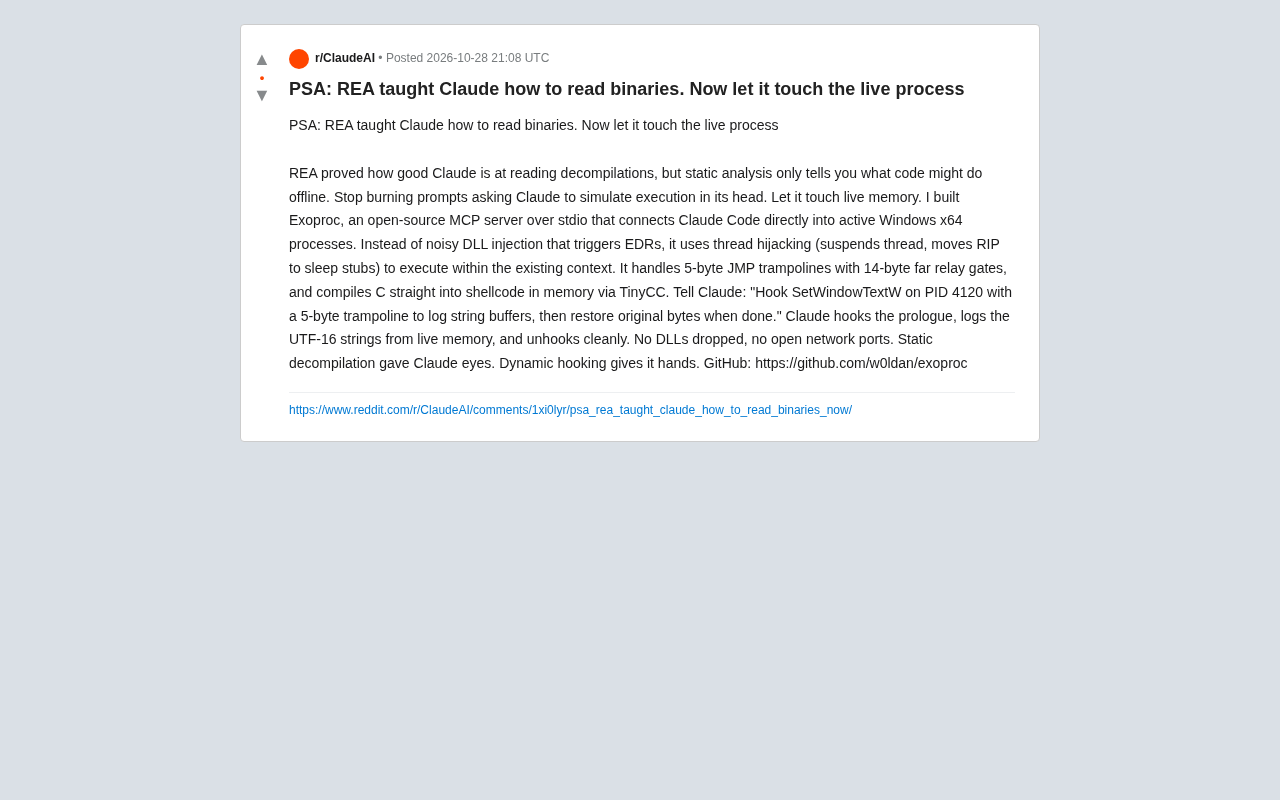
给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。