UCR档案翻车?52头猪揭露TSC基准真相

审计揭示UCR档案数据集任务语义偏移、数据混杂与划分缺陷,呼吁校准TSC评测基准。
一项针对时间序列分类(TSC)基准UCR档案的审计研究发现,该档案中多个数据集存在任务语义偏移、数据构成混杂、多元问题分解不当等问题。以PigAirwayPressure数据集为例,原始出血检测任务被改造为个体识别,导致评测偏离真实目标。档案还包含大量非时序的有序数据(如光谱、形状),与真正的时间序列任务存在能力错配;多元问题被分解为单变量序列,丢失变量交互信息;部分数据集来自玩具实验或存在测试划分缺陷。研究者呼吁更谨慎解读档案分数,转向与部署相关的评测设计,并已开源审计代码。
当基准数据集开始“跑偏”
时间序列分类(TSC)领域有一个绕不开的名字:UCR档案。它几乎是所有TSC论文的默认评测场,被视作衡量模型好坏的“标尺”。但最近一项审计研究却抛出了一个令人不安的问题:这把标尺,量的真的是TSC该解决的问题吗?
研究以PigAirwayPressure数据集为引子。这批数据的原始实验目的是通过气道压力判断猪是否发生出血,而到了UCR档案中,任务变成了“这条曲线来自52头猪中的哪一头”。从医学预警到个体识别,任务语义发生了根本性偏移。更关键的是,这种偏移并非孤例。
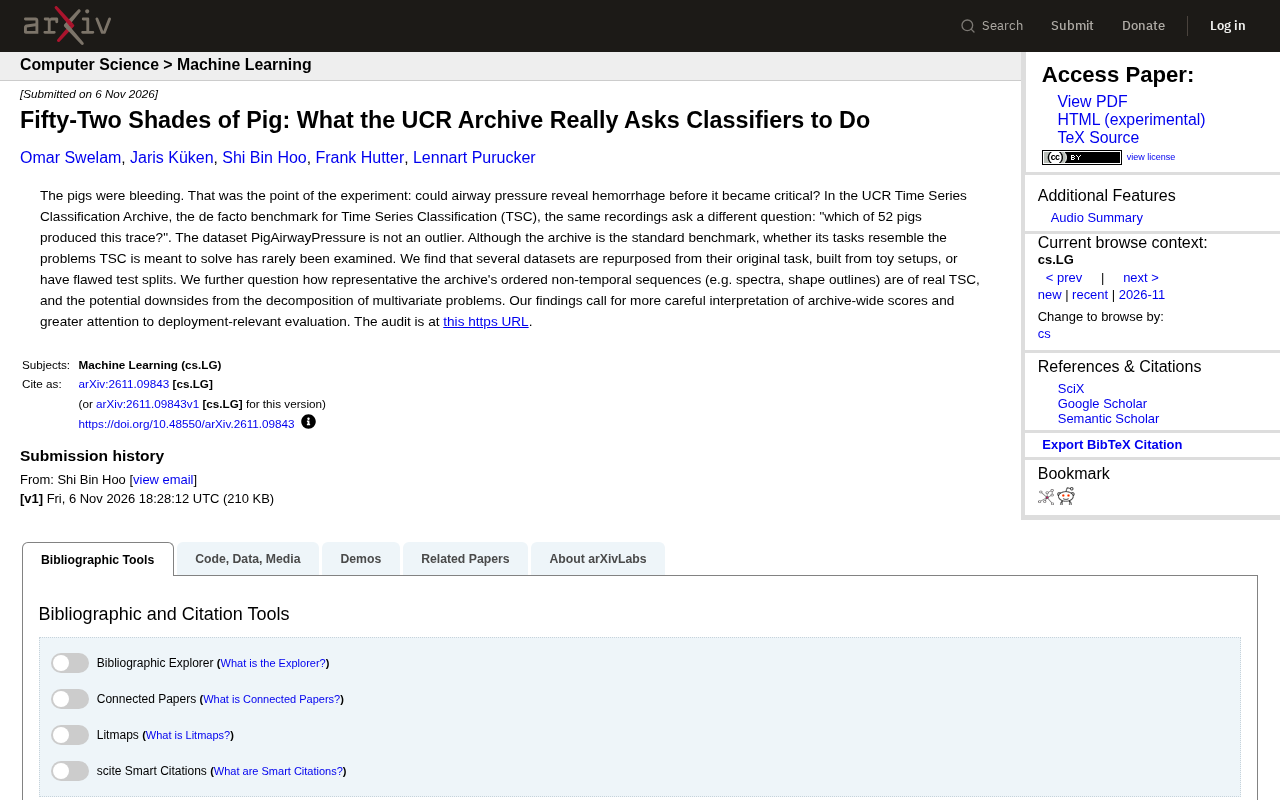
审计团队对UCR档案中的多个数据集进行了溯源,发现它们普遍存在三类问题:其一,原始任务被“改造”成分类任务,导致数据与目标之间的对应关系变得牵强;其二,部分数据集来自玩具级实验设置,与真实场景的复杂度相去甚远;其三,一些数据集的训练/测试划分存在缺陷,可能影响评测的公平性。这些发现指向一个核心结论:我们可能一直在用错误的题目,测试正确的算法。
UCR档案全称UCR Time Series Classification Archive,由加州大学河滨分校(University of California, Riverside)的Eamonn Keogh教授团队维护,自2015年发布以来已成为时间序列分类领域最广泛使用的基准数据集集合,包含上百个来自不同领域的数据集。该档案的初衷是提供多样化的评测场景,促进算法可比性。然而,随着其影响力扩大,研究者逐渐发现档案中的某些数据集存在标注模糊、任务定义不清等问题。本次审计正是针对这些隐患的系统性排查,旨在揭示基准数据集在任务语义上的潜在偏差,而非否定其历史价值。
被忽视的“非时间”序列
UCR档案的另一个争议点在于其数据构成的混杂性。档案中包含了大量并非严格时间序列的“有序非时序”数据,比如光谱曲线、形状轮廓等。这些数据在结构上是有序的,但它们并不具备时间序列特有的时序依赖和动态演化特征。
将它们与真正的时间序列混在一起评测,会带来一个隐蔽的问题:模型在光谱或形状数据上表现好,可能只是因为它们擅长捕捉静态的形态模式,而非时序建模能力。这种“能力错配”会让档案整体分数失去区分度,也让研究者难以判断模型在真实时序任务上的泛化性。
有序非时序数据(ordered non-temporal data)指具有顺序结构但不具备时间依赖性的数据,例如光谱曲线(波长顺序)、形状轮廓(空间点顺序)等。这类数据与时间序列的关键区别在于:时间序列的观测值之间存在动态演化关系,当前值受历史值影响;而有序非时序数据的顺序仅表示采集或排列的先后,不蕴含因果或动态关联。在UCR档案中,这类数据被纳入TSC基准,可能导致模型评估偏离时序建模能力的核心目标,因为模型可能仅通过捕捉静态形态特征就能获得高分,而无需理解时序依赖。
多元分解的代价
对于多元时间序列问题,UCR档案的处理方式也值得商榷。审计指出,将多元问题分解为多个单变量序列进行分类,虽然简化了评测流程,却可能丢失变量之间的交互信息。真实世界的多元时序任务——比如多传感器融合的故障诊断——其核心挑战恰恰在于变量间的协同关系。分解之后,这种关系被抹平,评测结果自然难以反映模型的实际部署价值。
多元时间序列分类(multivariate time series classification)涉及多个变量同时随时间变化的情况,变量间往往存在复杂的交互关系。例如,在多传感器故障诊断中,不同传感器的读数可能相互关联,共同反映系统状态。将多元问题分解为多个单变量序列独立分类,会忽略这种跨变量的协同信息,导致模型无法学习到变量间的联合模式。这种简化虽然降低了计算复杂度,但可能掩盖模型在真实多元任务上的性能缺陷,因为实际部署中模型需要处理变量间的动态交互,而非孤立地分析每个变量。
对TSC评测的启示
这项审计并非要否定UCR档案的历史贡献。它作为标准化基准,极大地推动了TSC领域的可比研究。但问题在于,当社区过度依赖单一档案的汇总分数时,容易产生一种“虚假的进步感”:排行榜上的数字在涨,但模型在真实场景中的表现未必同步提升。
研究者呼吁更谨慎地解读档案级分数,并将注意力转向与部署相关的评测设计。具体而言,这意味着在基准选择上要更关注任务语义的一致性,在数据划分上要确保测试集能反映真实分布,在多元问题上要保留变量间的结构信息。审计代码已在GitHub公开,为后续的基准改进提供了可复现的起点。
结语:标尺需要校准
PigAirwayPressure的52头猪,像一面镜子照出了TSC基准的尴尬:数据还是那些数据,但问题已经不是那个问题。对于AI研究者而言,这项审计提醒我们,基准不是真理,而是工具。工具需要定期校准,否则我们可能在一个看似严谨的体系里,回答着错误的问题。
当社区开始追问“档案到底让分类器做什么”时,TSC的评测文化或许正迎来一次必要的反思。
相关推荐

Harness 才是 Agent 的核心:工业级多 Agent 落地的三个关键
从 B 站实战演示出发,剖析 Harness 为何是 Agent 的核心:Master 与 Worker 双 Agent 架构、心智一致性约束、三遍自主迭代开发,以及工业级多 Agent 落地的可复用框架要点。

零成本用Claude Code:ModelScope免费API配置指南
B站UP主分享如何通过ModelScope魔搭社区免费API额度,配合VS Code和SystemService协议转换工具,零成本在Claude Code中调用DeepSeek等国产大模型写代码。含五步配置流程、模型选择技巧及三个常见坑点规避方法。

Pi Agent:极简开源编码智能体实战指南
Pi Agent 是对标 Codex、Claude Code 的极简开源编码智能体,GitHub Star 持续增长。本文梳理其崛起轨迹、极简设计思路与从原理配置到扩展开发的实战学习路径,帮助开发者快速上手。