Unsloth 0.1.900 更新:Laya 决策模型与统一媒体库上线

Unsloth v0.1.900 新增本地决策模型支持,视频生成提速4.5倍,并深度优化Apple Silicon推理性能。
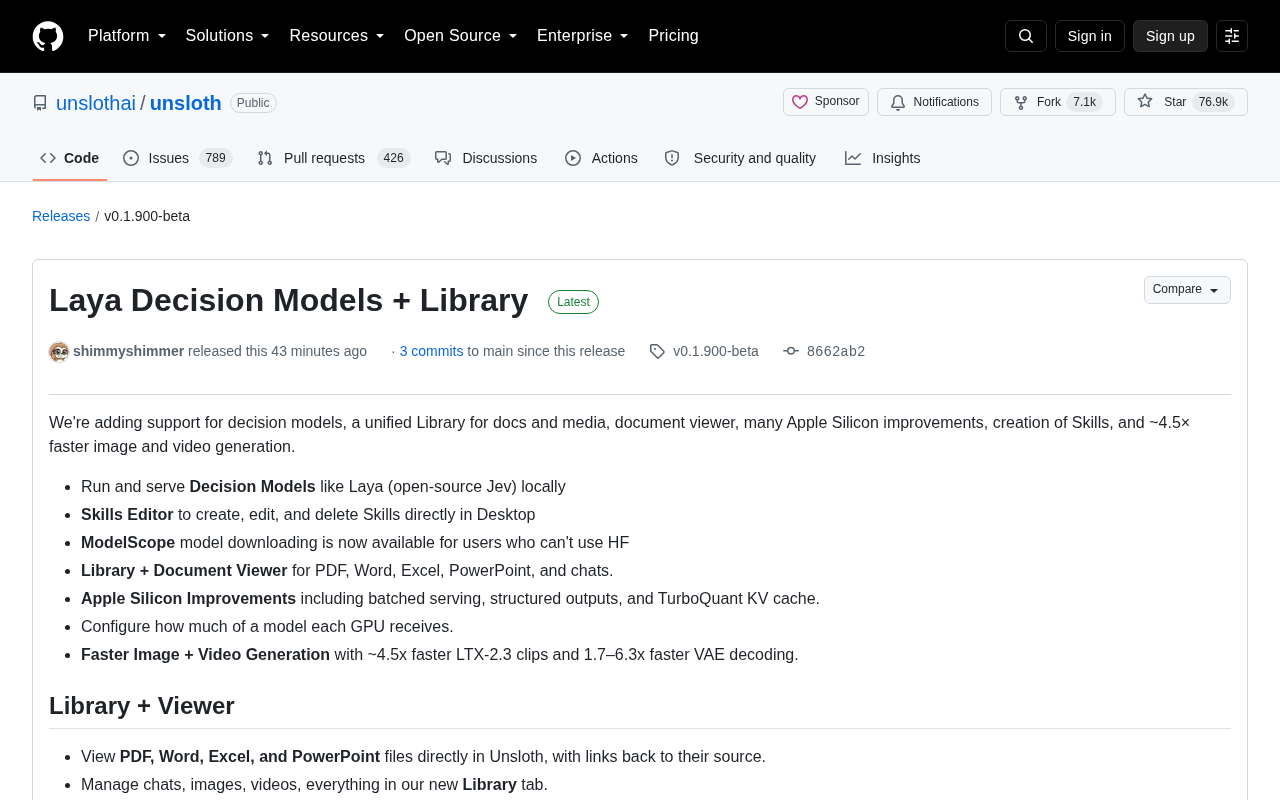
Unsloth 发布 v0.1.900-beta 版本,带来四大方向的更新。新增的 Laya 决策模型(开源版 Jev)专注于是/否判断、多选和评分等结构化推理任务,通过 TypeSafe SDK 和 MLX 框架实现本地高效运行。统一 Library 媒体库与文档查看器让 PDF、Office 文件可直接在应用内预览和管理。性能层面,LTX-2.3 视频生成速度提升约 4.5 倍,VAE 解码加速最高 6.3 倍,MiniMax-H3 的峰值显存降低 25–29 GiB。Apple Silicon 用户获得批量服务、TurboQuant KV 缓存及结构化输出等专项优化。训练侧则支持更快的 block-FP8 LoRA、音频模型加载和 ModelScope 下载渠道。整体而言,此版本持续拉近本地 AI 方案与云端服务在实用性上的差距。
开源大模型工具链 Unsloth 发布了 v0.1.900-beta 版本,带来一系列面向本地推理与训练的重要更新。这次版本的核心变化包括对**决策模型(Decision Models)**的支持、统一的文档与媒体库、文档查看器,以及对 Apple Silicon 平台的大量性能优化。图像与视频生成速度提升约 4.5 倍,成为本次更新中最引人注目的性能提升。
Laya 决策模型:本地运行的判断引擎
本次更新最具标志性的功能,是新增了对 Laya 决策模型(开源版 Jev)的支持。与传统生成式模型不同,决策模型专注于回答“是/否”判断、多项选择以及带概率的评分类问题,适合需要结构化决策输出的场景。
用户可以在 Settings > API 中启用 Decision API,选择具体模型并控制使用 CPU 或 GPU 运行。该功能通过 Jev 兼容的 /v1/systemone 端点对接 TypeSafe SDK,为开发者提供了一套类型安全的调用方式。当选择 GPU 运行时,模型可在 Apple Silicon 的 MLX 框架上原生执行,进一步降低本地部署门槛。
决策模型的引入,意味着 Unsloth 不再只是训练与生成工具,而是开始覆盖“判断”这一类结构化推理任务,为构建自动化流水线和智能代理提供了新的基础组件。
TypeSafe SDK 是一种强类型调用接口,开发者在调用 API 时,请求与响应的数据结构由编译器或运行时在类型层面加以约束,可在编码阶段而非运行阶段发现参数错误。对于决策模型这类需要精确输入格式和结构化输出的场景,TypeSafe SDK 能显著降低集成出错的风险。MLX 是 Apple 为 Apple Silicon 设计的机器学习框架,充分利用统一内存架构(CPU 与 GPU 共享同一块物理内存),省去了数据在不同内存区域之间的拷贝开销,因此在 Mac 上运行中小型模型时往往比通用框架更高效。Laya 决策模型能够在 MLX 上原生执行,意味着 M 系列芯片用户无需额外配置即可获得接近 GPU 加速的推理速度。
统一媒体库与文档查看器
新增的 Library 标签页将聊天记录、图片、视频等内容集中管理,用户还能直接在 Unsloth 内查看 PDF、Word、Excel 和 PowerPoint 文件,并保留回溯到源文件的链接。
文档处理能力得到明显增强:DOCX 的内容控件、修订插入和文本框都能被正确读取,向知识库添加 Word 文件时也不再丢失文本内容。附件卡片经过优化,支持更多文件格式的读取。界面层面,用户可以自定义侧边栏分区并拖拽排序,让工作空间更贴合个人习惯。
对于将本地模型用于文档问答和知识管理的用户来说,这套“库 + 查看器”的组合让 Unsloth 更接近一个完整的本地 AI 工作台。
图像与视频生成提速约 4.5 倍
性能优化是本次版本的重头戏。LTX-2.3 视频片段生成速度提升约 4.5 倍,得益于蒸馏采样、编译修复以及托管的 FP8 权重。图像和视频的 VAE 解码优化带来 1.7 至 6.3 倍的解码加速,整体生成速度的提升幅度则取决于具体工作流。
MiniMax-H3 模型的首帧渲染最多可提前约一分钟完成,同时在 A100、B200 和 RTX PRO 6000 上降低了 25–29 GiB 的峰值显存占用。这类显存优化对显存受限的用户尤为关键,意味着更大的模型或更长的生成任务可以在同样的硬件上运行。
VAE(变分自编码器,Variational Autoencoder) 在图像和视频扩散模型中承担"解码"最后一步的职责:模型在压缩的潜空间中完成去噪后,由 VAE 将潜向量还原为可见的像素图像或视频帧。由于 VAE 解码需要对每一帧做大量卷积运算,在长视频或高分辨率场景下往往成为生成流水线的速度瓶颈。本次 1.7 至 6.3 倍的 VAE 解码加速,意味着即使扩散步骤本身耗时不变,最终输出的等待时间也会大幅缩短。FP8 权重(8位浮点数)相比常见的 FP16 或 BF16 将权重体积压缩至一半,在支持 FP8 计算的 GPU(如 H100、B200)上可同时获得更低的显存占用和更快的矩阵运算速度,是当前大模型量化部署的前沿精度格式。
Apple Silicon 与 MLX 深度优化
这次更新对苹果芯片用户格外友好。批量服务(batched serving)允许多个回复同时解码,提升了并发吞吐;通过 response_format 新增了语法约束的结构化输出,让模型返回符合指定格式的结果。
针对 Gemma 4 等滑动窗口模型,新增了 TurboQuant KV 缓存和 KV 缓存量化。系统还改进了内存估算逻辑,并能根据可用内存自动调整上下文长度。这些改动共同降低了本地大模型在 Mac 上运行时的内存压力,使 Apple Silicon 成为越来越可行的本地推理平台。
KV 缓存(Key-Value Cache) 是 Transformer 推理中的核心加速机制:在自回归生成时,模型对已处理的 token 计算出的 Key 和 Value 矩阵会被缓存起来,后续生成新 token 时直接复用,避免重复计算。随着上下文变长,KV 缓存占用的内存可达数 GB,在资源有限的 Mac 上尤为明显。TurboQuant KV 缓存通过对缓存内容进行量化压缩(降低每个数值的存储精度),在几乎不损失输出质量的前提下大幅缩减缓存体积。针对 Gemma 4 等采用滑动窗口注意力的模型,KV 缓存只需保留最近 N 个 token 的键值对,天然限制了缓存上限,与量化结合后内存压力进一步降低,使在 16–32 GB 统一内存的 MacBook 上运行长上下文对话成为可能。
训练与推理的实用改进
在模型训练侧,本次版本带来了更快的 block-FP8 LoRA 训练,并支持在 compressed-tensors W8A8 检查点上进行 LoRA 微调。用户可以通过 FastModel 加载 Voxtral 和 Qwen2-Audio 等音频模型,也能从崩溃或取消的训练任务中导出已保存的检查点,避免长时间训练成果付诸东流。
兼容性方面,团队修复了 Gemma、较新版 TRL 训练器,以及 RTX 5090 和 RTX PRO 6000 上 FP8 的多个问题。此外还新增了两项实用能力:一是 Skills 编辑器,可在桌面端直接创建、编辑和删除技能;二是支持通过 ModelScope 下载模型,为无法访问 Hugging Face 的用户提供了替代方案。
LoRA(Low-Rank Adaptation) 是一种参数高效微调方法:训练时不直接修改预训练模型的全部权重,而是在特定层旁边附加一对低秩矩阵,只更新这对矩阵的参数。这样可以将可训练参数量压缩到原模型的 1%–10%,显存需求和训练时间随之大幅下降。block-FP8 LoRA 在此基础上将参与计算的张量进一步量化为 FP8 格式,在支持该精度的硬件上可同时加快矩阵乘法速度并减少激活值的显存占用。compressed-tensors W8A8 则指权重(Weights)和激活值(Activations)均以 8 位整数存储的量化检查点格式,在该格式的模型上直接叠加 LoRA 微调,让用户无需从全精度权重出发即可完成领域适配,极大降低了对高端 GPU 的依赖。
小结
从整体来看,Unsloth 0.1.900 版本的更新方向清晰:一方面通过决策模型和结构化输出拓展任务类型,另一方面通过大幅提速和显存优化降低本地部署成本。对于追求数据隐私、希望在个人硬件上运行 AI 模型的开发者和研究者而言,这些改进让本地方案在实用性上进一步逼近云端服务。
相关推荐
Perplexity混合计算实测:隐私数据不出Mac
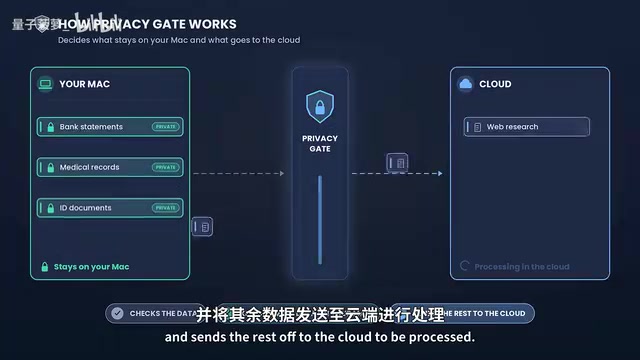
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
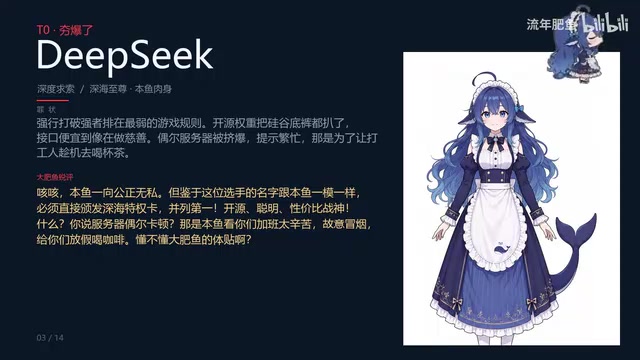
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。