Unsloth Studio更新:浏览器文件交互与玻璃主题Beta

Unsloth Studio 更新浏览器文件编辑、Glass 主题与内存/MLX 性能优化。
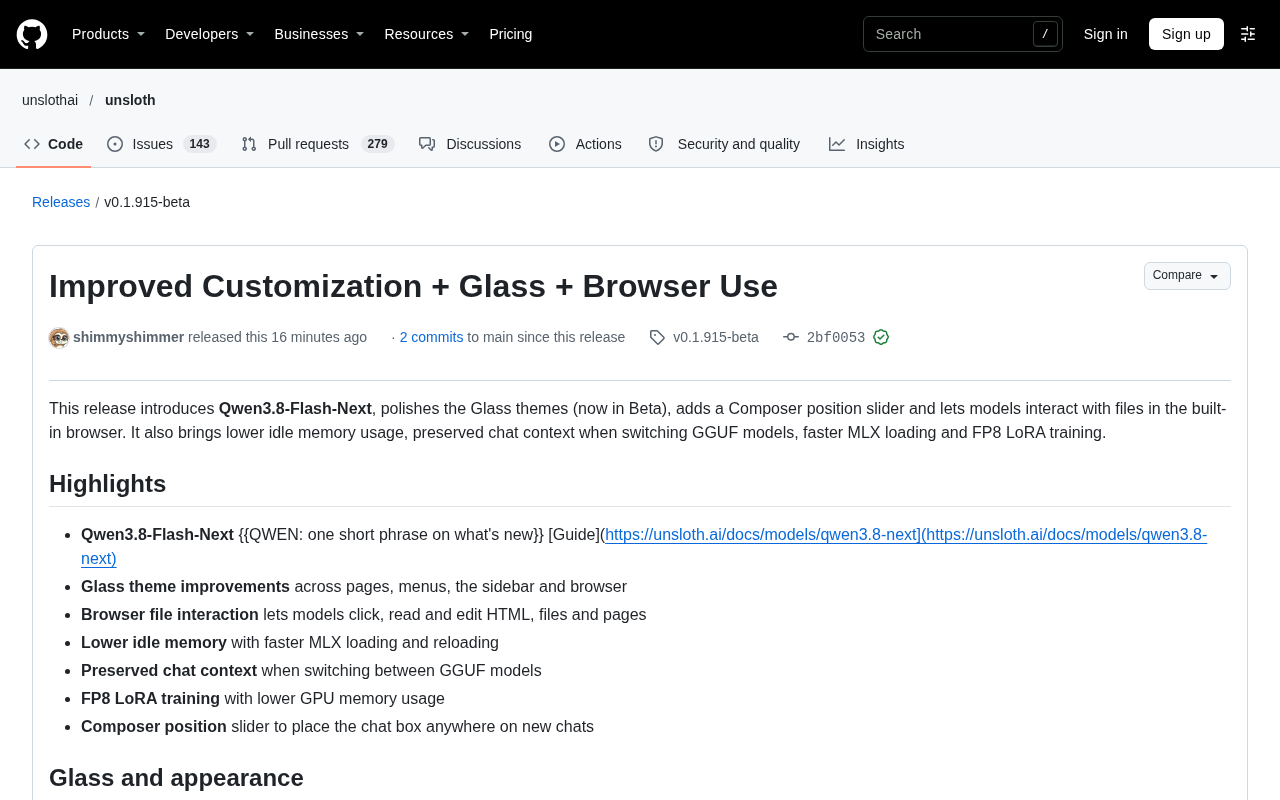
Unsloth Studio 发布 v0.1.915-beta,重点强化本地模型工作台体验。启用 Browser use 后,模型可直接在浏览器面板中点击、读取和编辑 HTML、React、Markdown、代码及文本文件,并支持 PDF 阅读与版本回退,减少在编辑器和浏览器间切换。Glass 主题进入 Beta,视觉更统一,并新增 Composer 位置滑块。性能方面,启动不再加载 PyTorch 等 ML 库,空闲内存显著降低,MLX 模型加载与重载大幅提速。训练侧支持 fp8_lora 低显存 LoRA 训练,DPO/ORPO/KTO/GRPO/CPO 登陆 MLX。整体看,该版本正把本地模型从开发者工具推向完整工作台,但仍处于快速迭代的 beta 阶段。
Unsloth Studio 发布了 v0.1.915-beta 版本,这次更新把重点放在了「本地模型工作台」的体验上:模型可以直接在浏览器面板里读写和编辑文件,Glass 玻璃主题进入 Beta 阶段,同时带来了显著的性能优化,包括更低的空闲内存占用和更快的 MLX 加载速度。
浏览器不再是只读窗口
据 GitHub 发布页的变更日志,启用 Browser use 后,模型可以点击、输入并编辑在聊天中生成的 HTML 和 React 页面,也能直接读取和编辑 HTML、React、Markdown、代码和文本文件。浏览器中的「Back」按钮可以恢复上一个版本,模型还能读取浏览器里打开的 PDF 和其他文档。这意味着不少本地模型的「代码生成—预览—修改」流程,不必再在编辑器和浏览器之间来回切换。
下载提示现在支持按站点或全局记住权限,包括程序文件。对于经常让模型下载依赖或工具的使用者,这个细节能减少重复确认的打断。
Glass 主题与 Composer 位置
Glass 主题被正式标记为 Beta。更新后它的高光更柔和、阴影更轻,菜单、面板和浏览器中的磨砂效果更统一;Library、Images 和 Train 等页面不再对背景图做重度模糊,打开的对话会轻微压暗背景并给 Composer 更密的玻璃质感。Windows 和 Linux 的标题栏也更贴合 Glass 主题与背景图。
新加入的 Composer 位置滑块允许在新对话中把聊天框放在页面任意位置,路径是 Settings > Appearance > Composer。这项改动看似小,但对使用超宽屏或分屏布局的用户来说,实际影响不小。
空闲内存与 MLX 加载的优化
发布说明提到,Unsloth 不再在启动时加载 PyTorch 及其他 ML 库,从而显著降低空闲内存占用,相关功能可在 Settings > General > Startup performance 中配置。MLX 模型的加载和重载速度大幅提升,缩小已加载模型的上下文现在只需数秒;长提示在受支持的 MLX 模型上占用更少内存。
GGUF 模型切换时开始保留聊天上下文,不必重新读取长历史。在工具无需询问即可运行的场景下,GGUF 模型可以一次读取最多四个网页。
MLX 是苹果公司为 Apple Silicon(M 系列芯片)开发的机器学习数组框架,其设计充分利用了统一内存架构,使 CPU 与 GPU 共享同一块内存池,从而减少数据拷贝开销。与 PyTorch 等通用框架相比,MLX 在 Mac 本地推理和训练场景中通常能获得更低的内存占用和更快的加载速度。Unsloth 对 MLX 模型加载与重载的优化,正是建立在 MLX 这一底层框架特性之上的,因此相关加速效果主要面向使用 Apple Silicon 设备的使用者。
训练与 API 侧的改动
在较新 NVIDIA GPU 上,16 位基础模型可以通过 float8_training = "fp8_lora" 以更低显存进行 LoRA 训练;DPO、ORPO、KTO、GRPO 和 CPO 训练开始支持 MLX。OpenRouter 模型改为从 API 实时加载,并支持 Reload models。Decision API 新增 LiquidAI 的 d1 模型和 Decider 2B(仅 MLX)。
本次版本由 shimmyshimmer 发布,包含 2 个提交,涉及 12 位以上贡献者。有意思的是,发布说明中 Qwen3.8-Flash-Next 的介绍段落仍保留着待填充的占位符,具体新特性需要查阅官方指南。
LoRA(Low-Rank Adaptation)是一种参数高效微调方法:它冻结基础模型的原始权重,只在部分层旁注入低秩分解矩阵进行训练,从而将可训练参数量降低几个数量级,显著减少显存占用和训练时间。fp8_lora 进一步将 LoRA 适配器权重以 FP8(8 位浮点)格式存储和计算,在较新的 NVIDIA GPU(如 Ada Lovelace 及 Hopper 架构)上可借助硬件原生支持获得更低显存需求。这让 16 位基础模型在消费级或中端显卡上进行微调成为可能,代价是需要评估量化带来的精度损失。
文中提到的 DPO、ORPO、KTO、GRPO 和 CPO 均为对齐或偏好优化算法。DPO(Direct Preference Optimization)直接用偏好对数据优化策略,省去奖励模型;ORPO 将监督微调与偏好对齐合并为单一阶段;KTO(Kahneman-Tversky Optimization)只需标注「好/坏」而非成对比较;GRPO(Group Relative Policy Optimization)通过组内相对比较估计优势,常用于推理模型训练;CPO(Contrastive Preference Optimization)则以对比方式优化偏好。这些算法登陆 MLX,意味着 Mac 用户也能在本地完成偏好对齐训练,而不必依赖 CUDA 环境。
编辑观点
这次更新的主线很清楚:把「本地运行模型」从开发者工具推向更完整的工作台。浏览器文件交互解决的是 Agent 类任务中最常见的操作闭环,而降低空闲内存和加快 MLX 加载则直接改善日常使用的体感。Glass 主题进入 Beta 说明视觉层还在打磨,但更新日志中占位符未清理、页面加载出现报错提示等细节,也提醒使用者这仍是一个快速迭代中的 beta 版本。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。