Unsloth v0.1.71-beta发布:微调加速框架核心改进解析
Unsloth 的持续迭代
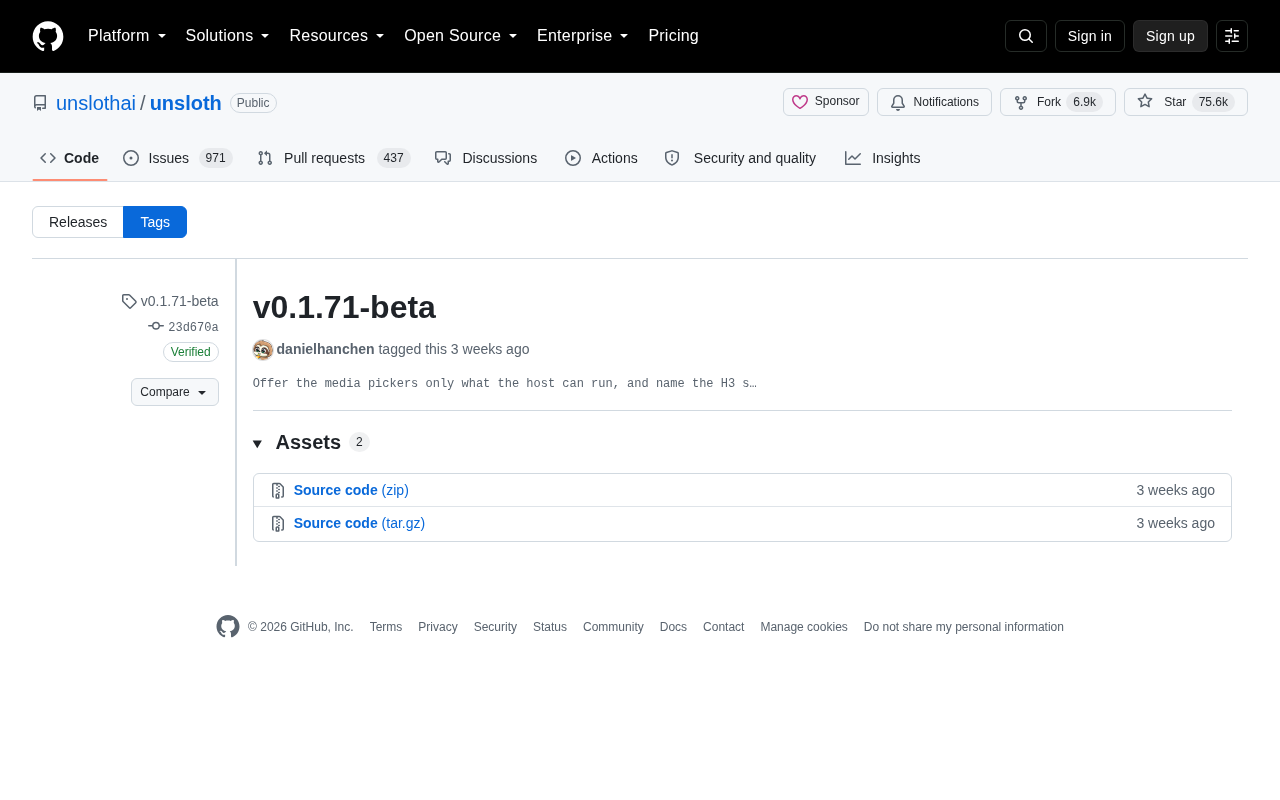
Unsloth 作为当前最受欢迎的大模型微调加速框架之一,近日发布了 v0.1.71-beta 版本。这个由 GitHub 用户 danielhanchen 标记发布的测试版,延续了该项目一贯的快速迭代节奏。目前 Unsloth 在 GitHub 上已累积超过 75.6k Star 和 6.9k Fork,稳居 AI 微调工具生态的头部位置。
对于关注 AI 编程和模型定制的开发者而言,Unsloth 的核心价值在于它能以极低的显存占用和更快的训练速度完成大语言模型的微调工作。个人开发者甚至能够在消费级 GPU 上完成过去需要昂贵集群才能进行的微调任务。
理解大模型微调的技术背景
大模型微调(Fine-tuning)是指在预训练大语言模型的基础上,使用特定领域或任务的数据集对模型参数进行进一步训练,使其在目标任务上表现更优。与从头训练(pre-training)相比,微调只需要少量数据和计算资源。当前主流的微调技术包括全参数微调(Full Fine-tuning)和参数高效微调(PEFT),后者以 LoRA(Low-Rank Adaptation)为代表,通过在模型权重矩阵中引入低秩分解的适配器模块,仅训练极少量新增参数即可实现接近全参数微调的效果。
LoRA 的核心思想源于一个关键观察:大模型在微调过程中,权重的变化矩阵 ΔW 往往具有很低的内在秩(intrinsic rank)。这意味着一个维度为 d×d 的权重更新矩阵,实际上可以用两个远小于原矩阵的矩阵 A(d×r)和 B(r×d)的乘积来近似表示,其中 r 远小于 d(通常 r=8 或 16)。这样,需要训练的参数量从 d² 骤降为 2dr,在 7B 参数模型上通常只需训练不到原始参数量的 1%。这一发现由微软研究院在 2021 年提出,从根本上改变了大模型定制的经济性。
Unsloth 正是在 LoRA/QLoRA 等技术路线上进行了深度的工程优化,使得这些本就高效的微调方法能够以更低的资源消耗运行。
v0.1.71-beta 的核心改进内容
从发布信息来看,v0.1.71-beta 的主要提交聚焦在媒体处理与运行环境适配的优化上。提交说明中提到「Offer the media pickers only what the host can run」,即根据宿主机的实际运行能力,仅向用户提供其可支持的媒体选项。
更智能的硬件能力适配
这一改动看似细微,实则体现了 Unsloth 团队对用户体验的深入思考。在多模态微调场景日益普遍的背景下,不同硬件配置对图像、音频等媒体类型的支持能力存在明显差异。通过让工具主动感知宿主环境的能力边界,可以有效避免用户在不兼容的配置下遭遇报错或性能瓶颈,从而显著降低使用门槛。
多模态微调是指对能够同时处理文本、图像、音频、视频等多种输入模态的大模型进行定制化训练。随着 GPT-4V、LLaVA、Qwen-VL 等多模态大模型的涌现,开发者不再局限于纯文本场景,而是希望让模型理解图文混合指令、处理医学影像、分析文档版面等复杂任务。然而,多模态微调对硬件的要求远高于纯文本微调——图像编码器需要额外的显存和计算资源,音频处理则对特定解码库有依赖。v0.1.71-beta 中「根据宿主机能力提供可用媒体选项」的改进正是为了应对这种复杂性,避免用户在硬件不支持的情况下选择了不兼容的多模态训练配置。
命名规范优化
提交中还涉及对 H3 层级命名的调整。虽然具体细节有限,但这类规范性改进通常有助于提升代码可读性与 API 一致性,为后续功能扩展打下更清晰的结构基础。
为什么 Unsloth 值得开发者关注
显存与训练速度的双重优化
Unsloth 最核心的竞争力在于对训练效率的极致追求。通过手写的 GPU kernel 和对 Transformer 架构的深度优化,Unsloth 能够在不损失精度的前提下,将微调速度提升数倍,同时大幅削减显存占用。这对于硬件资源受限的个人开发者和中小团队尤为关键。
所谓手写 GPU kernel,是指绕过 PyTorch 等高级框架的通用计算调度,使用 OpenAI 的 Triton 语言直接编写在 GPU 上执行的并行计算函数。Triton 是 OpenAI 开源的一种 GPU 编程语言和编译器,它在 CUDA 之上提供了更高层次的抽象。传统 CUDA 编程需要开发者手动管理线程块(thread block)、共享内存(shared memory)、内存合并访问(coalesced memory access)等底层细节,开发门槛极高。Triton 则允许开发者以类似 NumPy 的块级(block-level)编程范式编写 GPU kernel,由编译器自动处理内存分层调度和线程映射,同时仍能产出接近手写 CUDA 的性能。Unsloth 团队选择 Triton 而非纯 CUDA,使其在保持极致性能的同时降低了内核维护的工程复杂度。
Unsloth 团队针对 Transformer 中的注意力机制、交叉熵损失函数、RoPE 位置编码等关键计算环节进行了逐一优化,直接控制 GPU 的内存访问模式和线程调度策略,从而在相同硬件上实现更高的计算吞吐量和更低的显存占用。
其中,注意力机制(Attention)是 Transformer 架构的核心,也是计算和显存的最大瓶颈之一。标准自注意力的计算复杂度为 O(n²),其中 n 为序列长度,这意味着处理长文本时显存占用会急剧膨胀。FlashAttention 系列工作通过重新组织计算顺序(IO-aware tiling),避免将完整的 n×n 注意力矩阵写入 GPU 高带宽内存(HBM),而是在芯片的 SRAM 中分块计算并累加结果,将显存占用从 O(n²) 降至 O(n)。Unsloth 在此基础上进一步针对 LoRA 微调场景做了定制优化,例如将 LoRA 适配器的计算与注意力计算融合为单个 kernel,减少 kernel launch 开销和中间结果的显存驻留。
这也是 Unsloth 能够声称「零精度损失下训练速度提升 2-5 倍」的技术根基。
结合 QLoRA(Quantized LoRA)技术,这种底层优化的威力得到了进一步放大。QLoRA 是 2023 年由华盛顿大学提出的方法,它将预训练模型的权重量化为 4-bit(如 NF4 格式)后再应用 LoRA 适配器进行微调。NF4(4-bit NormalFloat)是一种信息论最优的 4-bit 量化数据类型,它基于一个关键假设:预训练神经网络的权重近似服从零均值的正态分布。NF4 将正态分布的累积分布函数等分为 2⁴=16 个区间,每个区间的中位数作为量化级别,从而使得量化误差在正态分布下达到信息论最优。相比传统的 INT4 均匀量化,NF4 能更好地保留权重分布中出现频率最高的中间值区域的精度,同时对尾部的极端值也有合理的覆盖。这是 QLoRA 能够在 4-bit 量化下仍保持接近 16-bit 微调精度的关键因素之一。
借助 QLoRA,70 亿参数的模型微调仅需约 6GB 显存,在 RTX 3090、RTX 4090 等消费级 GPU 上即可运行。Unsloth 对 QLoRA 流程做了进一步的工程优化,包括减少中间激活值的显存占用、优化梯度检查点策略等,使得实际可训练的模型规模进一步提升。
梯度检查点(Gradient Checkpointing,也称激活重计算)是一种经典的显存优化技术。在标准反向传播中,前向计算产生的所有中间激活值都需要保留在显存中,以供反向传播计算梯度时使用。梯度检查点策略只保留部分层的激活值,在反向传播时重新计算被丢弃的激活值,以约 33% 的额外计算开销换取约 60-70% 的显存节省。Unsloth 对这一策略进行了更精细的控制——根据不同层的显存占用特征选择性地应用检查点,而非简单地对每个 Transformer 层统一处理,从而在显存节省和计算开销之间找到更优的平衡点。
这些优化叠加在一起,极大地降低了个人开发者和小团队的硬件门槛。
广泛的主流模型兼容性
作为一个高度活跃的开源项目,Unsloth 持续跟进主流大模型的适配支持,覆盖 Llama、Mistral、Gemma 等热门模型系列。这种及时的兼容性更新,使其成为许多研究者和工程师进行模型定制时的首选工具。
在微调工具生态中的差异化定位
当前大模型微调工具生态呈现出多层次的格局。Hugging Face 的 Transformers + PEFT + TRL 组合提供了最通用的微调框架;Axolotl 以配置驱动的方式简化了多种微调策略的组合使用;LLaMA-Factory 则以丰富的 Web UI 和中文社区支持著称。Unsloth 的差异化定位在于「底层性能优化」——它并非从零构建一套微调流程,而是作为加速层嵌入已有的 Hugging Face 生态中,用户只需替换几行代码即可获得显著的速度和显存收益。这种最小侵入性的设计哲学使其能够与上述工具兼容使用,而非相互竞争。
开源社区的强力支撑
75.6k 的 Star 数背后是一个高度活跃的开发者社区。频繁的版本发布(beta 版号已迭代至 0.1.71)说明项目维护者对社区反馈的响应速度极快,问题修复和功能增强都能快速落地。
Beta 版本的使用建议
需要注意的是,v0.1.71 属于 beta 测试版本。对于追求稳定性的生产环境,建议开发者谨慎评估后再行升级,或在隔离环境中先行测试。而对于希望体验最新特性、参与社区反馈的用户,beta 版是了解 Unsloth 发展方向的绝佳窗口。
此次发布已附带 2 个构建产物(Assets),并通过 GitHub 的 verified signature 进行了签名验证(GPG key ID: B5690EEEBB952194),保障了下载来源的可信度。GPG(GNU Privacy Guard)签名验证是一种基于非对称加密的数字签名机制,用于确认软件发布包确实由声称的作者签署,且在传输过程中未被篡改。
在开源软件供应链攻击日益频繁的今天,这种验证机制显得尤为重要。2024 年 3 月曝光的 XZ Utils 后门事件是开源安全领域的一次标志性事件——一位化名「Jia Tan」的贡献者经过长达两年的社区信任建设,最终在 xz 压缩库中植入了针对 OpenSSH 的后门代码。该后门几乎进入了所有主流 Linux 发行版的稳定版本,若非被一位微软工程师偶然发现 SSH 登录延迟而追查,后果不堪设想。这一事件深刻暴露了开源软件供应链的脆弱性——全球关键基础设施可能依赖于少数缺乏资助的维护者。此后,GPG 签名验证、可重现构建(reproducible builds)、SBOM(软件物料清单)等实践受到了前所未有的重视。
当开发者看到发布页面上的「Verified」标记时,意味着该版本的 commit 或 tag 使用了与 GitHub 账户绑定的 GPG 密钥进行签名,GitHub 已验证密钥的所有权。Unsloth 采用 GPG 签名发布正是对这一安全趋势的积极响应,也体现了项目在安全性方面的规范管理。
总结
Unsloth v0.1.71-beta 虽然是一次相对小幅的迭代,但其对媒体能力适配和命名规范的优化,延续了该项目「注重工程细节、快速响应需求」的一贯风格。在大模型微调需求持续增长的当下,Unsloth 这样兼顾效率与易用性的开源微调框架,正成为 AI 应用落地不可或缺的基础设施。持续关注其版本演进,对每一位从事模型定制的开发者都有实际参考价值。
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。