Unsloth v0.1.803更新:自动上下文压缩与局域网远程访问详解

Unsloth v0.1.803-beta:170+改进的稳定性大版本
以微调加速著称的开源项目Unsloth(GitHub已获7.5万星标)近日发布了v0.1.803-beta版本。Unsloth是由Daniel和Michael Han兄弟于2023年创立的开源项目,专注于大语言模型的微调(Fine-tuning)加速与推理优化。微调是指在预训练模型基础上,使用特定领域或任务的数据进行进一步训练,使模型适应特定应用场景。Unsloth的核心技术优势在于通过手写CUDA内核和数学等价优化,将LoRA/QLoRA微调速度提升2-5倍,同时将显存占用降低60-80%。LoRA(Low-Rank Adaptation)是微软在2021年提出的参数高效微调方法,通过在冻结的预训练权重旁注入低秩分解矩阵,仅训练极少量参数即可达到全量微调的效果;QLoRA则进一步将基础模型量化到4-bit精度后再进行LoRA微调,大幅降低了硬件门槛。
这次更新与其说是功能大爆发,不如说是一次以稳定性为核心、辅以两个实验性新特性的里程碑式迭代。据官方发布说明,本次版本合并了超过170个Pull Request,覆盖bug修复、可靠性与性能优化,同时带来了三大亮点:自动上下文压缩(Auto Compaction)、局域网远程访问(LAN Remote Access),以及全面提速的聊天体验。
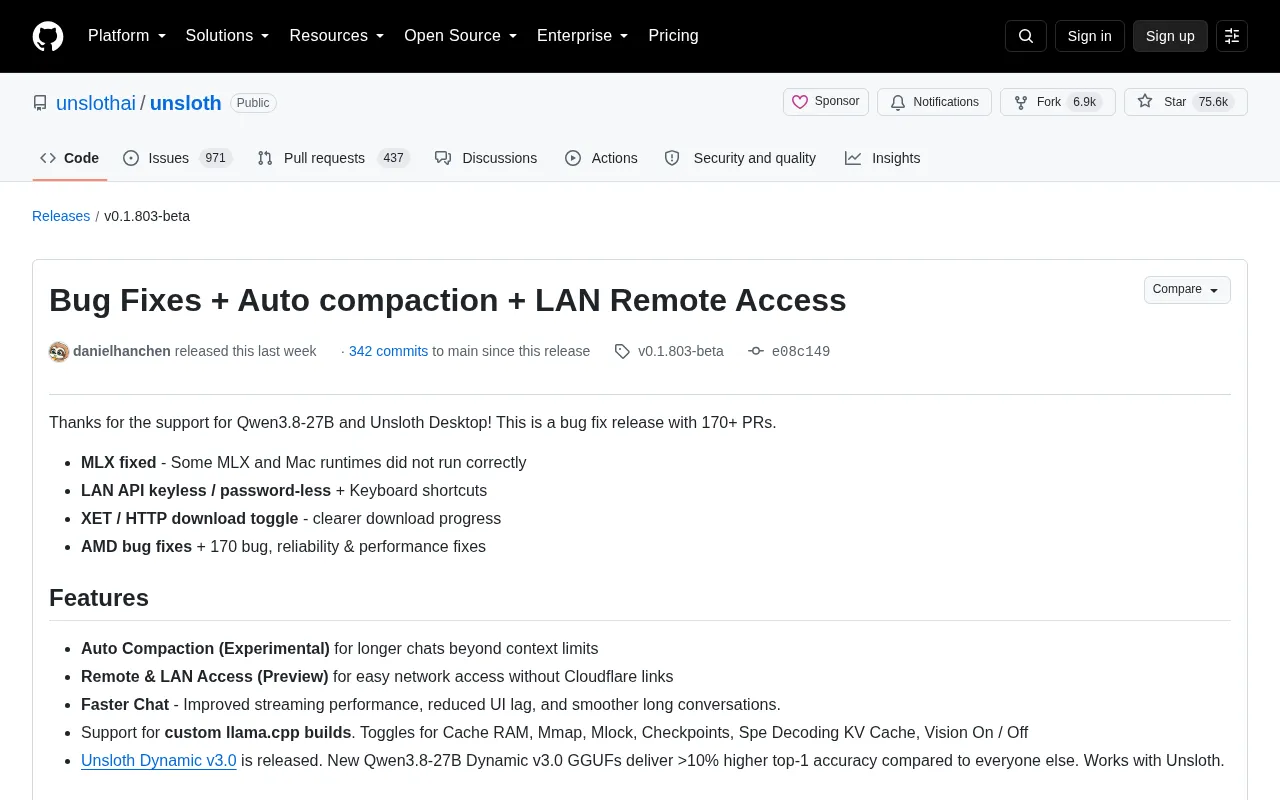
对于长期使用本地大模型的开发者而言,这次更新触及了两个真实存在的痛点:上下文窗口的限制,以及本地推理服务的跨设备访问。下面逐一拆解这两项核心能力的技术设计。
自动上下文压缩:突破对话长度限制的实用方案
从简单截断到归档搜索的思路转变
任何本地大模型都受限于固定的上下文窗口。上下文窗口(Context Window)是大语言模型的核心架构约束之一,指模型在单次推理中能够处理的最大token数量。例如,Llama 3的上下文窗口为8K tokens,而GPT-4 Turbo扩展到了128K tokens。这一限制源于Transformer架构中自注意力机制的二次方计算复杂度——自注意力(Self-Attention)机制由Vaswani等人在2017年的论文《Attention Is All You Need》中提出,其计算过程需要将输入序列中的每个token与所有其他token进行点积运算生成注意力权重矩阵,因此时间和空间复杂度均为O(n²)。这意味着当上下文窗口从4K扩展到128K时,理论计算量增加了约1024倍。业界为此发展出多种优化方案,包括稀疏注意力(仅计算部分token对)、线性注意力(将复杂度降至O(n))、以及分组查询注意力(GQA,通过共享Key-Value头减少显存占用)等。传统做法是在对话超长时简单地丢弃早期内容,采用滑动窗口或FIFO队列方式截断最早的token,这会导致模型"失忆",在多轮对话中丢失关键上下文信息。
Unsloth这次给出的答案更为精巧——**自动压缩(Experimental)**允许你进行超越模型上下文上限的长对话,而被移出上下文的历史轮次"仍然可被搜索"。
其核心机制值得关注:当上下文空间不足时,系统仅会将最早的完整对话轮次整体移出活跃上下文,且绝不会在消息中途截断。原始的对话记录保持不变,被移出的内容则通过Unsloth已有的RAG流水线(存储、分块、嵌入、检索)建立每个线程独立的可搜索归档。
这里所说的RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库与大语言模型结合的技术范式,最早由Meta AI在2020年提出。其核心流程包括四个阶段:存储(将文档持久化到数据库)、分块(Chunking,将长文本切割为适合检索的片段)、嵌入(Embedding,通过向量模型将文本转化为高维向量表示)、检索(根据查询在向量空间中找到最相关的片段)。在Unsloth的场景中,RAG被巧妙地复用于管理被移出上下文的对话历史——每个对话线程维护独立的检索索引,使得被压缩的历史内容不是被丢弃,而是被转移到一个可按需召回的归档系统中。
值得深入理解的是Unsloth引入的"上下文纪元"(epoch)概念。每当一次压缩操作发生,就标志着一个新纪元的开始。归档跨纪元持久存在意味着系统维护了一个累积的知识库——第一次压缩移出的对话、第二次压缩移出的对话都存在于同一个可搜索空间中。这种设计使得模型在超长对话中的信息保留能力理论上不再受限于上下文窗口大小,而是受限于存储空间和检索效率,用户可以进行数小时甚至数天的持续对话而不必担心早期的关键信息被永久丢弃。
为什么选择词法搜索而非摘要压缩
一个有意思的工程决策是:Unsloth放弃了对话摘要方案。官方明确指出,摘要"收益甚微,却给每次压缩增加约190秒的开销"。取而代之的是,系统在移出对话时强制触发一次"召回"(recall),而非依赖模型自行搜索,后续检索则通过search_conversation完成。
更关键的是,检索优先采用**词法搜索(lexical search)**而非语义搜索。词法搜索和语义搜索代表了信息检索的两种根本不同的范式。词法搜索基于精确的词汇匹配,典型算法包括BM25和TF-IDF,通过计算查询词在文档中的出现频率和逆文档频率来排序结果,优势在于速度快、不需要GPU推理、对精确术语的匹配极为可靠。语义搜索则依赖向量嵌入模型(如sentence-transformers)将文本映射到连续向量空间,通过余弦相似度等度量找到语义相近但措辞不同的内容。
Unsloth选择词法搜索优先的理由很务实:聊天记忆的召回通常是精确匹配,比如人名、数字或ID。在这类查询场景下,词法搜索的准确率远高于语义搜索,且不会引入嵌入模型的额外计算开销。这种对实际使用场景的深刻理解,体现了Unsloth团队在工程上的克制与聚焦。此外,归档会跨"上下文纪元"(epoch)持久存在,意味着未来的压缩操作可以恢复之前被移出的内容。
局域网远程访问:告别Cloudflare隧道的原生方案
跨设备访问的原生化支持
过去,想要从手机或另一台电脑访问本地运行的Unsloth服务,往往需要借助Cloudflare隧道链接等外部工具。Cloudflare Tunnel(前身为Argo Tunnel)是Cloudflare提供的一项零信任网络服务,其工作原理是在本地运行一个名为cloudflared的守护进程,主动向Cloudflare的边缘网络建立出站连接,外部请求通过Cloudflare的全球CDN反向代理到本地服务。虽然这种方案安全且便捷,但它引入了外部依赖——需要Cloudflare账户、依赖第三方网络基础设施、且所有流量都经过Cloudflare服务器,这对于仅需在家庭或办公局域网内跨设备访问的场景来说过于"重量级"。
这里涉及两种不同的网络安全理念的取舍。零信任(Zero Trust)网络安全模型的核心原则是"永不信任,始终验证"——无论请求来自网络内部还是外部,都必须经过身份验证和授权。Cloudflare Tunnel正是基于这一理念设计的。而Unsloth新增的局域网访问功能则采用了更传统的网络边界安全模型,即信任同一局域网内的设备,但通过密码认证增加一层防护。这种设计反映了不同使用场景的安全需求差异:对于家庭用户在自己的Wi-Fi网络中从手机访问PC上的LLM服务,零信任模型显然过度设计,而简单的密码保护加局域网隔离就已足够。
本次更新的**远程与局域网访问(Preview)**功能,让这一切变得原生而简单——你可以直接从设置中管理,让同一网络内的其他设备访问Unsloth,省去了中间环节,直接在本地网络层面解决问题。
新版本新增了专门的远程访问设置区域,支持连接地址、二维码扫描以及可选的自动启动。值得称赞的是,用户无需重启即可启用或禁用局域网访问。
安全性的默认约束设计
在便利性之外,Unsloth对安全做了合理的默认约束:局域网访问默认关闭,且必须修改系统生成的管理员密码后才能启用。同时,API层面也提供了无密钥/无密码的LAN访问选项并配合键盘快捷键。这种"默认安全、按需开放"的设计,对于将本地服务暴露到网络环境的场景是必要的防护。
性能与硬件兼容性:全面的底层优化
聊天体验的流畅度提升
除了两大新特性,本次更新在聊天体验上做了大量优化。官方称改进了流式传输性能、减少了UI卡顿,并让长对话更加流畅。从PR列表可以看到,团队针对长线程做了诸多细致处理,例如"立即绘制长线程的最新消息,而非先重建所有消息",以及"延迟渲染屏幕外的代码块高亮"等,这些都是提升大规模对话响应速度的关键工程细节。
此外还新增了提示词队列、可自定义快捷键、用于局部文件修改的edit_file工具,以及改进的工具调用与MCP行为。MCP(Model Context Protocol,模型上下文协议)是Anthropic于2024年底开源的标准化协议,旨在为大语言模型提供与外部工具和数据源交互的统一接口,类似于AI世界的"USB-C"标准。
多平台硬件兼容性提升
硬件层面,本次更新的覆盖面相当广:
- 支持自定义llama.cpp构建。llama.cpp是由Georgi Gerganov于2023年3月发起的开源项目,用纯C/C++实现了大语言模型的推理,无需GPU即可在普通CPU上运行。该项目催生了整个本地LLM推理生态,其GGUF(GPT-Generated Unified Format)格式已成为本地量化模型的事实标准。支持自定义构建意味着用户可以针对特定硬件(如特定CUDA架构或Apple Silicon芯片)编译优化版本,或启用实验性功能如推测解码。
- 新增Cache RAM、Mmap、Mlock、Checkpoints、推测解码KV缓存、视觉开关等高级设置切换。其中推测解码(Speculative Decoding)是一种利用"小模型草拟、大模型验证"策略加速自回归生成的技术——用一个参数量小得多的草稿模型快速生成多个候选token,然后由目标大模型一次性并行验证其可接受性,当草稿模型预测准确率较高时可带来2-3倍的端到端加速。KV缓存在此过程中需要特殊处理,因为被拒绝的token对应的缓存项需要被正确回滚。Mmap(内存映射文件)和Mlock(内存锁定)则是操作系统层面的内存管理技术:Mmap允许将模型文件直接映射到虚拟地址空间,实现按需加载而非一次性读入全部权重;Mlock则防止操作系统将已加载的模型权重换出到磁盘交换分区,避免推理过程中因页面换入换出导致的延迟抖动。
- 修复了AMD相关bug,改善ROCm、xFormers与Flash-Attention的兼容性。ROCm(Radeon Open Compute)是AMD推出的开源GPU计算平台,对标NVIDIA的CUDA生态。xFormers是Meta开发的高效Transformer组件库,提供内存高效的注意力实现,可将显存占用从O(n²)降低到O(n)。Flash-Attention则是由Tri Dao等人提出的IO感知型精确注意力算法,通过分块计算和核函数融合实现2-4倍速度提升和5-20倍显存节省。三者在AMD平台上的协同一直存在兼容性挑战,本次修复对AMD GPU用户群体意义重大。
- 新增Intel XPU支持。Intel XPU是Intel推出的统一加速计算架构,涵盖其Arc系列独立显卡、Data Center GPU Max系列(基于Ponte Vecchio架构)以及集成显卡等。Intel通过oneAPI编程框架和SYCL标准试图打造一个跨硬件的统一编程模型,对标NVIDIA的CUDA生态。Unsloth新增Intel XPU支持标志着本地LLM推理正在走向真正的硬件多元化——用户不再被锁定在NVIDIA GPU上,AMD和Intel的加速硬件都成为可选方案,这对于降低本地AI部署的硬件成本门槛具有重要意义,尤其是许多笔记本电脑已内置Intel集成显卡或Arc独立显卡。
- 修复了MLX与Mac运行时的问题。MLX是Apple于2023年12月开源的机器学习框架,专为Apple Silicon(M系列芯片)设计,核心特点包括统一内存架构——CPU和GPU共享同一内存空间,避免了传统GPU计算中的数据搬运开销。对于Mac用户而言,MLX提供了原生且高效的本地LLM推理路径,尤其在M2 Ultra和M4 Max等高端芯片上,统一内存可达192GB甚至更高,足以加载70B甚至更大参数的模型。
- 改进MTP性能与VRAM处理。MTP(Multi-Token Prediction,多token预测)是Meta在2024年提出的训练与推理优化技术。传统的自回归语言模型每次只预测下一个token,而MTP训练模型同时预测未来的多个token。在推理阶段,MTP可以与推测解码协同工作——模型自身的多token预测头充当"草稿生成器",减少了对独立草稿模型的依赖。DeepSeek-V3等模型已经在架构中集成了MTP机制,Unsloth改进MTP性能意味着支持这类新架构的模型能获得更好的推理体验。
对多GPU用户,还修复了张量并行降级后重新询问投影器放置等边缘情况。张量并行(Tensor Parallelism)是将单个模型的权重矩阵切分到多个GPU上并行计算的技术,适用于单个模型太大无法放入单块GPU显存的场景。与之相对的还有流水线并行(Pipeline Parallelism,将模型的不同层分配到不同GPU)和数据并行(Data Parallelism,每个GPU持有完整模型副本处理不同数据批次)。这里修复的问题涉及当张量并行配置变化时,视觉模型的投影层(将图像特征映射到语言模型空间的组件)需要重新确定其在GPU间的分配策略。
Unsloth Dynamic v3.0:精度领先的动态量化方案
随本次版本同步发布的还有Unsloth Dynamic v3.0量化方案。官方宣称,新的Qwen3.8-27B Dynamic v3.0 GGUF模型相比业界其他方案,top-1准确率高出10%以上,且完全兼容Unsloth。
动态量化一直是Unsloth的技术招牌。模型量化是将神经网络权重从高精度浮点数(如FP16/BF16)转换为低精度表示(如INT4/INT8)的技术,目的是在可接受的精度损失下大幅减少模型体积和推理所需的显存与计算量。传统的均匀量化对所有层使用相同的量化位宽,但研究表明模型中不同层对量化的敏感度差异显著——早期的注意力层和最终的输出层通常对精度更敏感,而中间的前馈网络层则更能容忍低精度。这一发现在多项研究中得到验证,例如GPTQ和AWQ等量化算法都引入了基于权重重要性的差异化处理策略。
Unsloth的Dynamic Quantization方案正是基于这一洞察,通过分析每一层的权重分布和对最终输出的影响程度,自动为不同层分配最优的量化位宽。例如,敏感层可能保持6-bit量化,而鲁棒层则压缩到2-bit,从而在整体模型大小不变的前提下,将精度损失集中在影响最小的位置。与GPTQ(基于近似二阶信息的逐层量化)和AWQ(Activation-aware Weight Quantization,根据激活值分布保护重要权重通道)等方案相比,Unsloth Dynamic的独特之处在于它在层间粒度上进行位宽分配,而非仅在层内进行权重重要性加权。v3.0的这一提升,进一步巩固了Unsloth在本地量化模型领域的竞争力。
总结:面向实际使用场景的务实迭代
综合来看,Unsloth v0.1.803-beta并非追求华丽功能堆砌的版本,而是一次以"能用、好用、稳定"为目标的务实迭代。170+个PR的修复量说明团队正在打磨产品的可靠性根基;而自动上下文压缩与局域网远程访问两项功能,则精准解决了本地大模型使用中的真实痛点。
对于本地部署LLM的开发者和爱好者来说,这次更新中的归档搜索式上下文管理和原生局域网访问,都是值得立即尝试的实用能力。而Dynamic v3.0量化方案的精度突破,则再次证明了Unsloth在开源模型优化领域的技术实力。
核心要点
相关推荐
企业级AI Agent全栈开发实战:从零搭建可上线智能体的学习路径
一份企业级AI Agent全栈开发课程导学解析:涵盖为什么学Agent、适合人群、LangChain与CrewAI框架学习路径,以及从单智能体到多智能体的实战落地方案,助你搭建可上线的智能体应用。
从真实项目拆解AI智能体:基于LangGraph的学习助手架构实践
以真实上线的AI学习助手为例,拆解基于LangGraph、Neo4j知识图谱、Redis与MinIO的智能体架构实践,解析为何面试官偏爱复杂真实项目,以及FDE岗位的求职方向。
LangChain 1.3 入门指南:大模型与Agent核心概念解析
LangChain 1.3入门教程:解析大语言模型的三大局限、框架的统一接口与模块化架构,以及LLM、Agent、DeepAgent与Harness架构的层级关系,助你理解大模型应用开发核心概念。